

Timu ya Alibaba Tongyi Qianwen ilitangaza rasmi Qwen3.8-Flash usiku wa leo. Timu ya Tongyi pia ilitoa uzani wa chanzo huria wa Qwen3.8-Flash-Next; usanifu mpya wa Next utakuwa msingi wa awali wa kizazi kipya kabisa cha miundo ya Qwen4.
Huu ni muundo wa MoE wenye uwezo wa kutumia njia mbalimbali, ukiwa na vigezo 125B katika muundo mkuu na 51B za ziada za N-gram Embedding; kila tokeni huwezesha vigezo 6B. Unaunga mkono kiasili muktadha wa tokeni 262,144, na unaweza kupanuliwa hadi tokeni 1M kupitia YaRN.
Kulingana na maelezo yaliyotolewa, Qwen3.8-Flash imeboreshwa kwa kina katika maeneo manne:
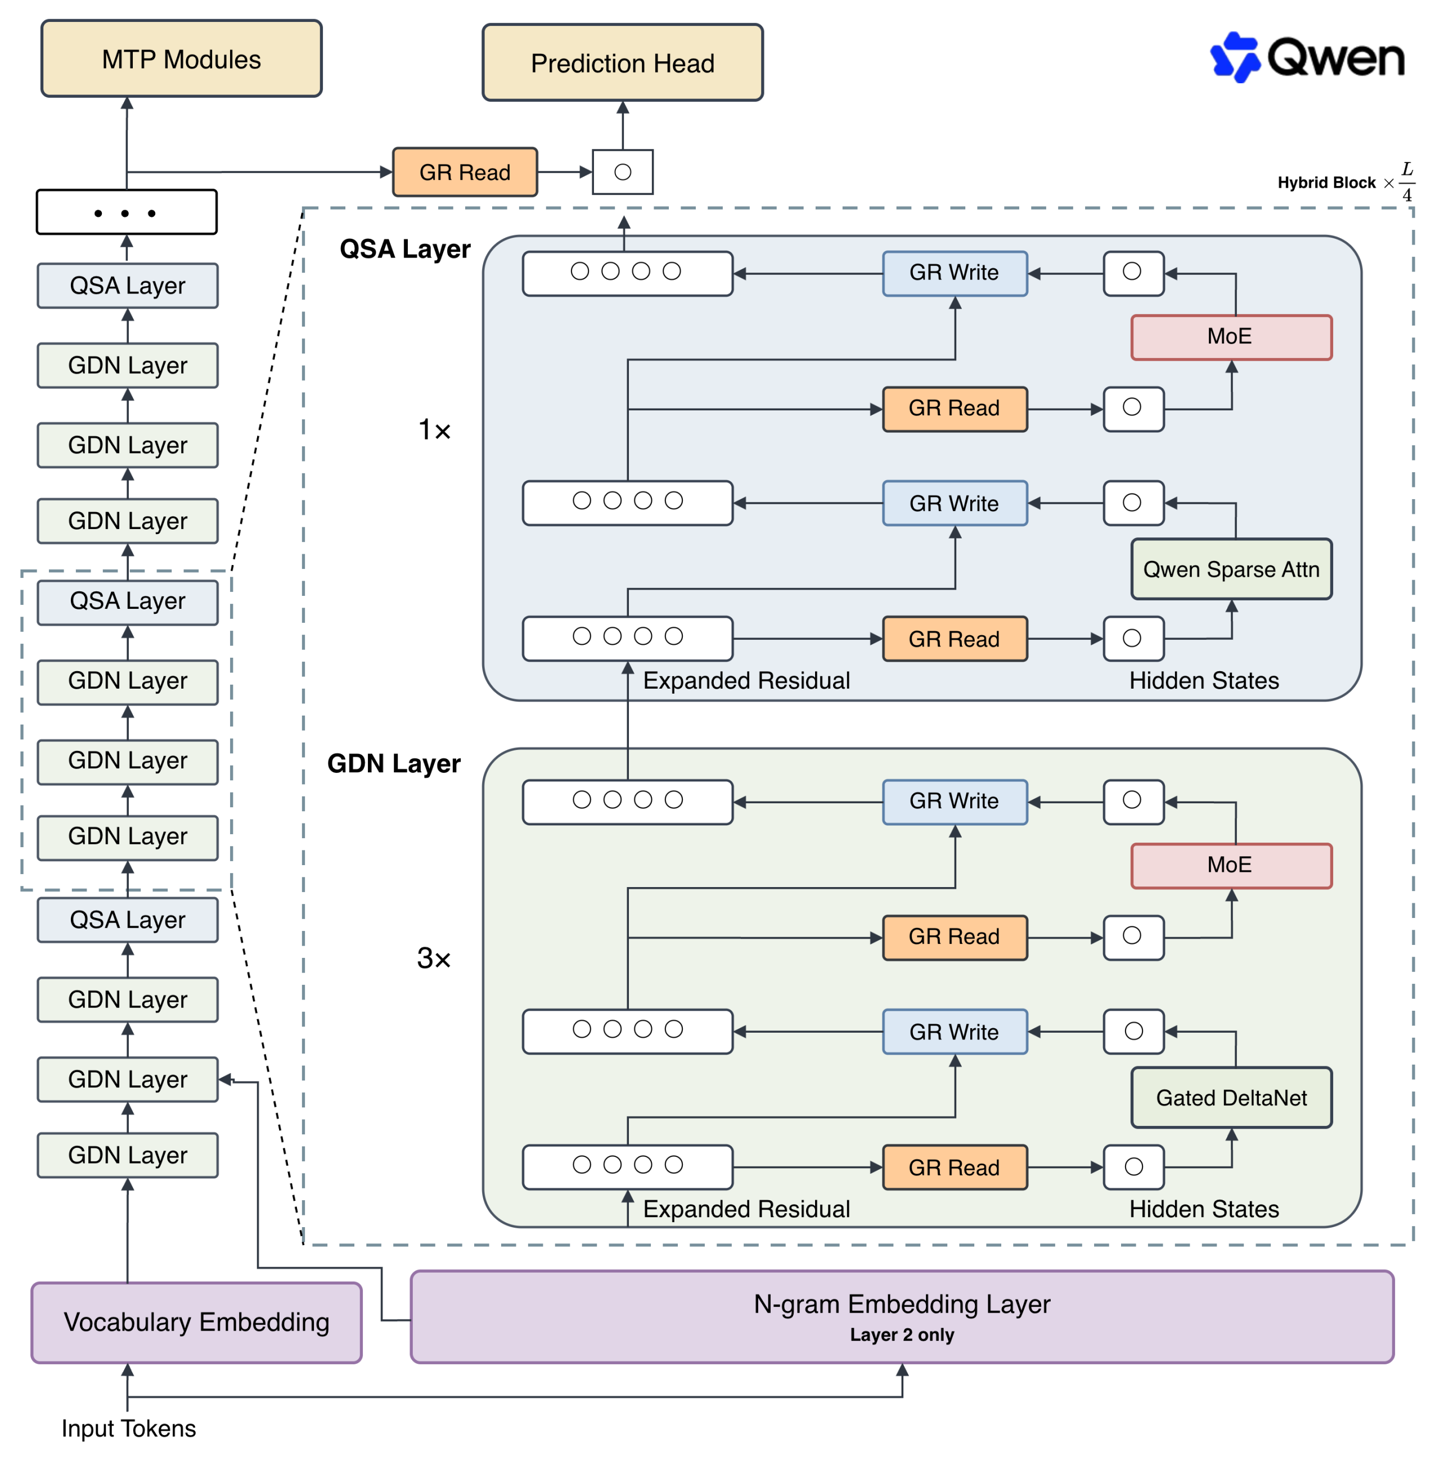
Katika Attention, inatumia usanifu mseto wa GDN (Gated DeltaNet) + QSA (Qwen Sparse Attention). GDN hukandamiza kwa ufanisi taarifa za awali, huku QSA ikitumia Indexer nyepesi kuchagua muktadha muhimu kwa kiwango cha micro-block, hivyo kupunguza kwa kiasi kikubwa gharama ya Attention katika mfuatano mrefu. Katika muktadha mrefu wa tokeni 1M, Attention Kernel ya QSA ilifikisha kasi ya juu ya mara 7.6 na mara 4.9 katika hatua za Prefill na Decode mtawalia.
Katika Residual, imeanzisha utaratibu wa Gated Residual (GR), unaopanua mkondo wa mabaki kuwa matawi 4 yanayofanya kazi sambamba, huku Gate inayobadilika ikidhibiti usomaji na uandishi wa taarifa. Hali ya mabaki inaweza kuhifadhiwa kwa FP8, na hivyo kupunguza kwa kiasi kikubwa gharama ya ufikiaji wa kumbukumbu.
Katika Embedding, imeanzisha N-gram Embedding yenye vigezo 51B, ikitumia utafutaji wa jedwali la muktadha wa karibu kupanua uwezo wa muundo. Vigezo hivi vinaweza kuhamishiwa kwenye Host Memory na kuingiliana na mahesabu ya muundo kupitia Prefetch isiyolingana, bila kuchukua kwa muda mrefu kumbukumbu ya GPU.
Katika Optimization, inatumia Muon Optimizer na imeboresha mikakati kama usahihi wa orthogonalization, mgawanyo wa majukumu ya vigezo na utenganishaji wa matriki zilizounganishwa. Scaling Law imekadiriwa upya kwa kuzingatia usanifu mpya.
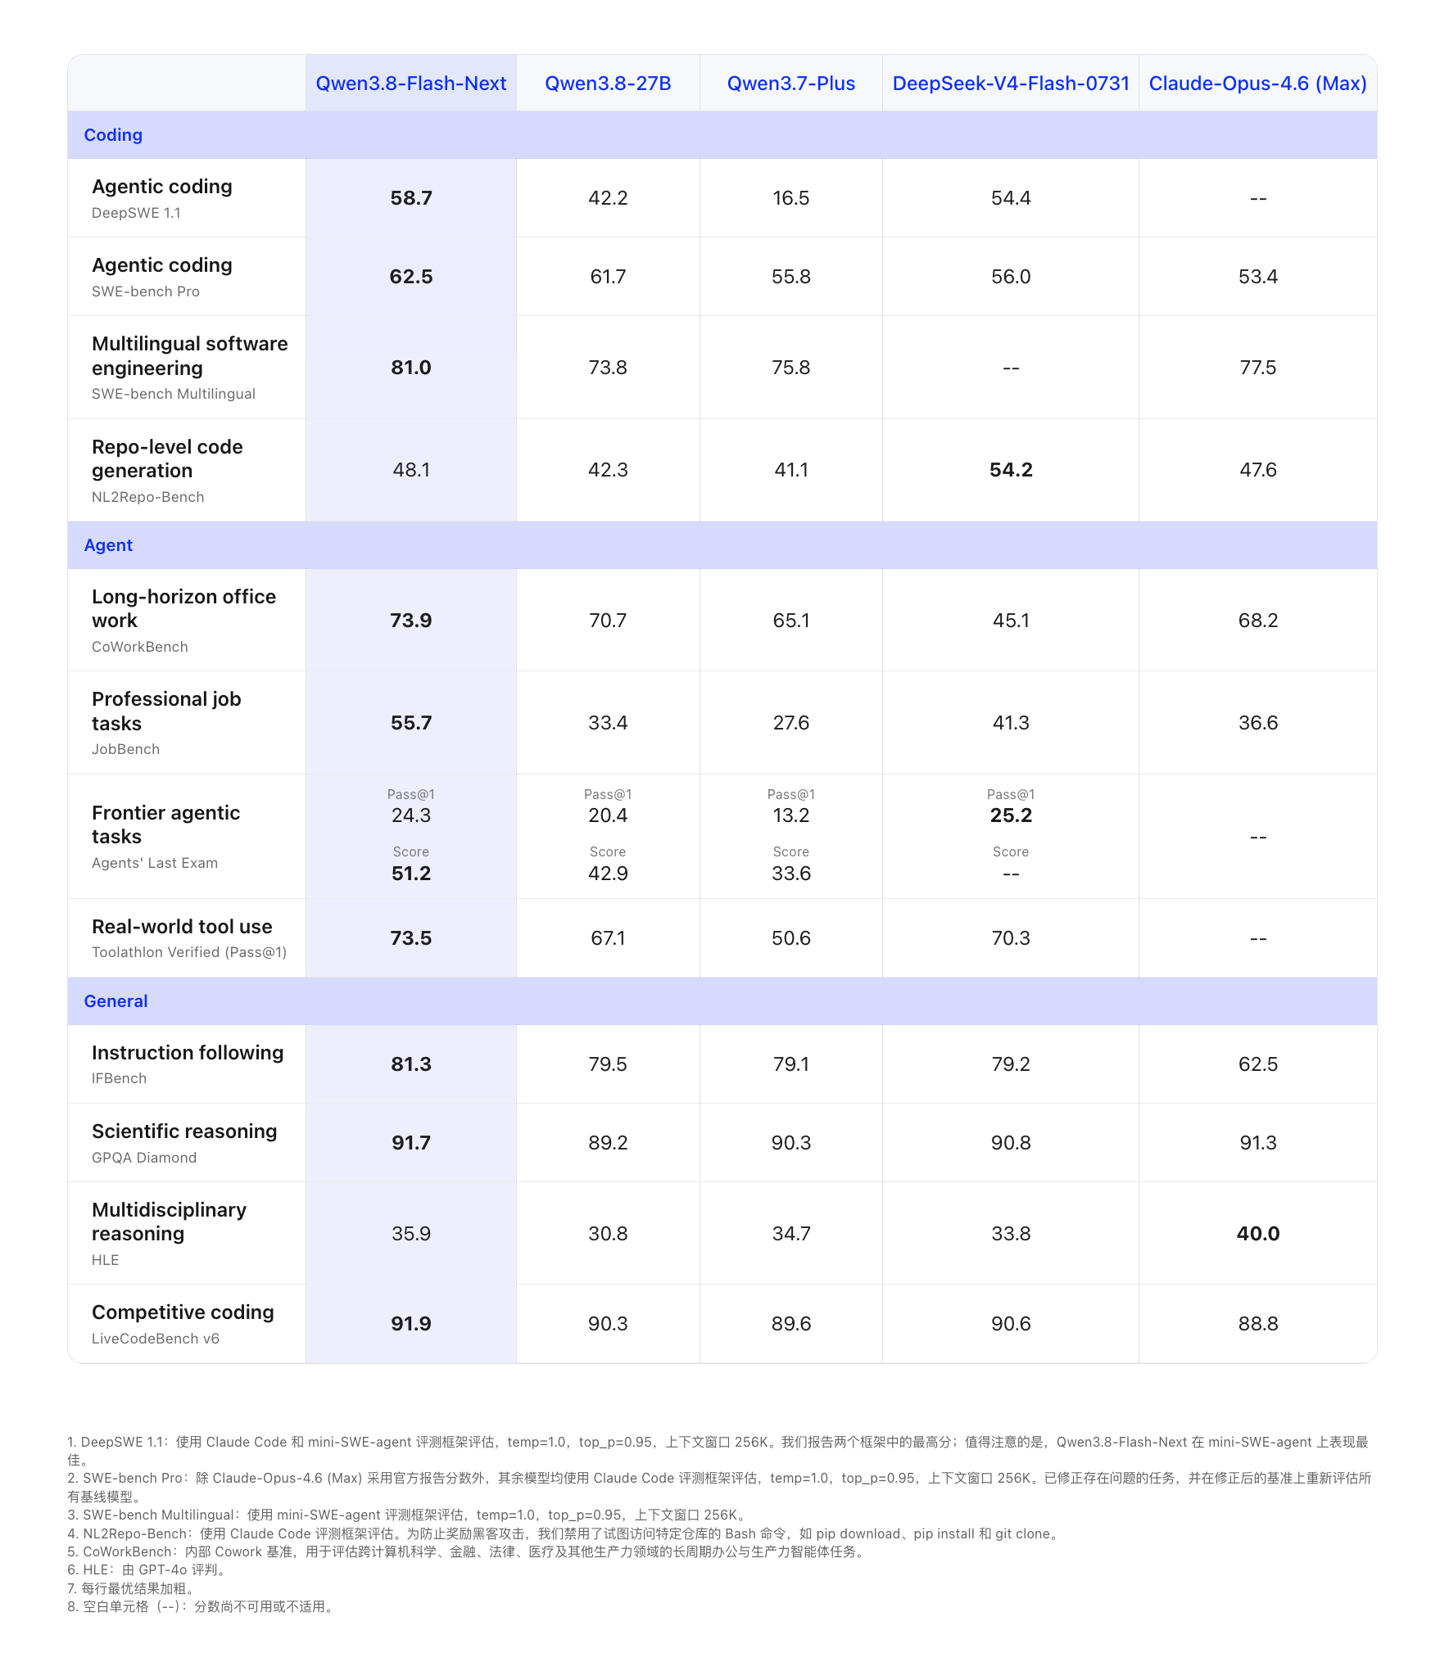
Ikilinganishwa na Qwen3.7-Plus, gharama ya mafunzo ya Qwen3.8-Flash ni takriban moja ya tisa tu ya mtangulizi wake, huku ikiwa na uwezo mkubwa zaidi katika kazi za usimbaji na ofisi.
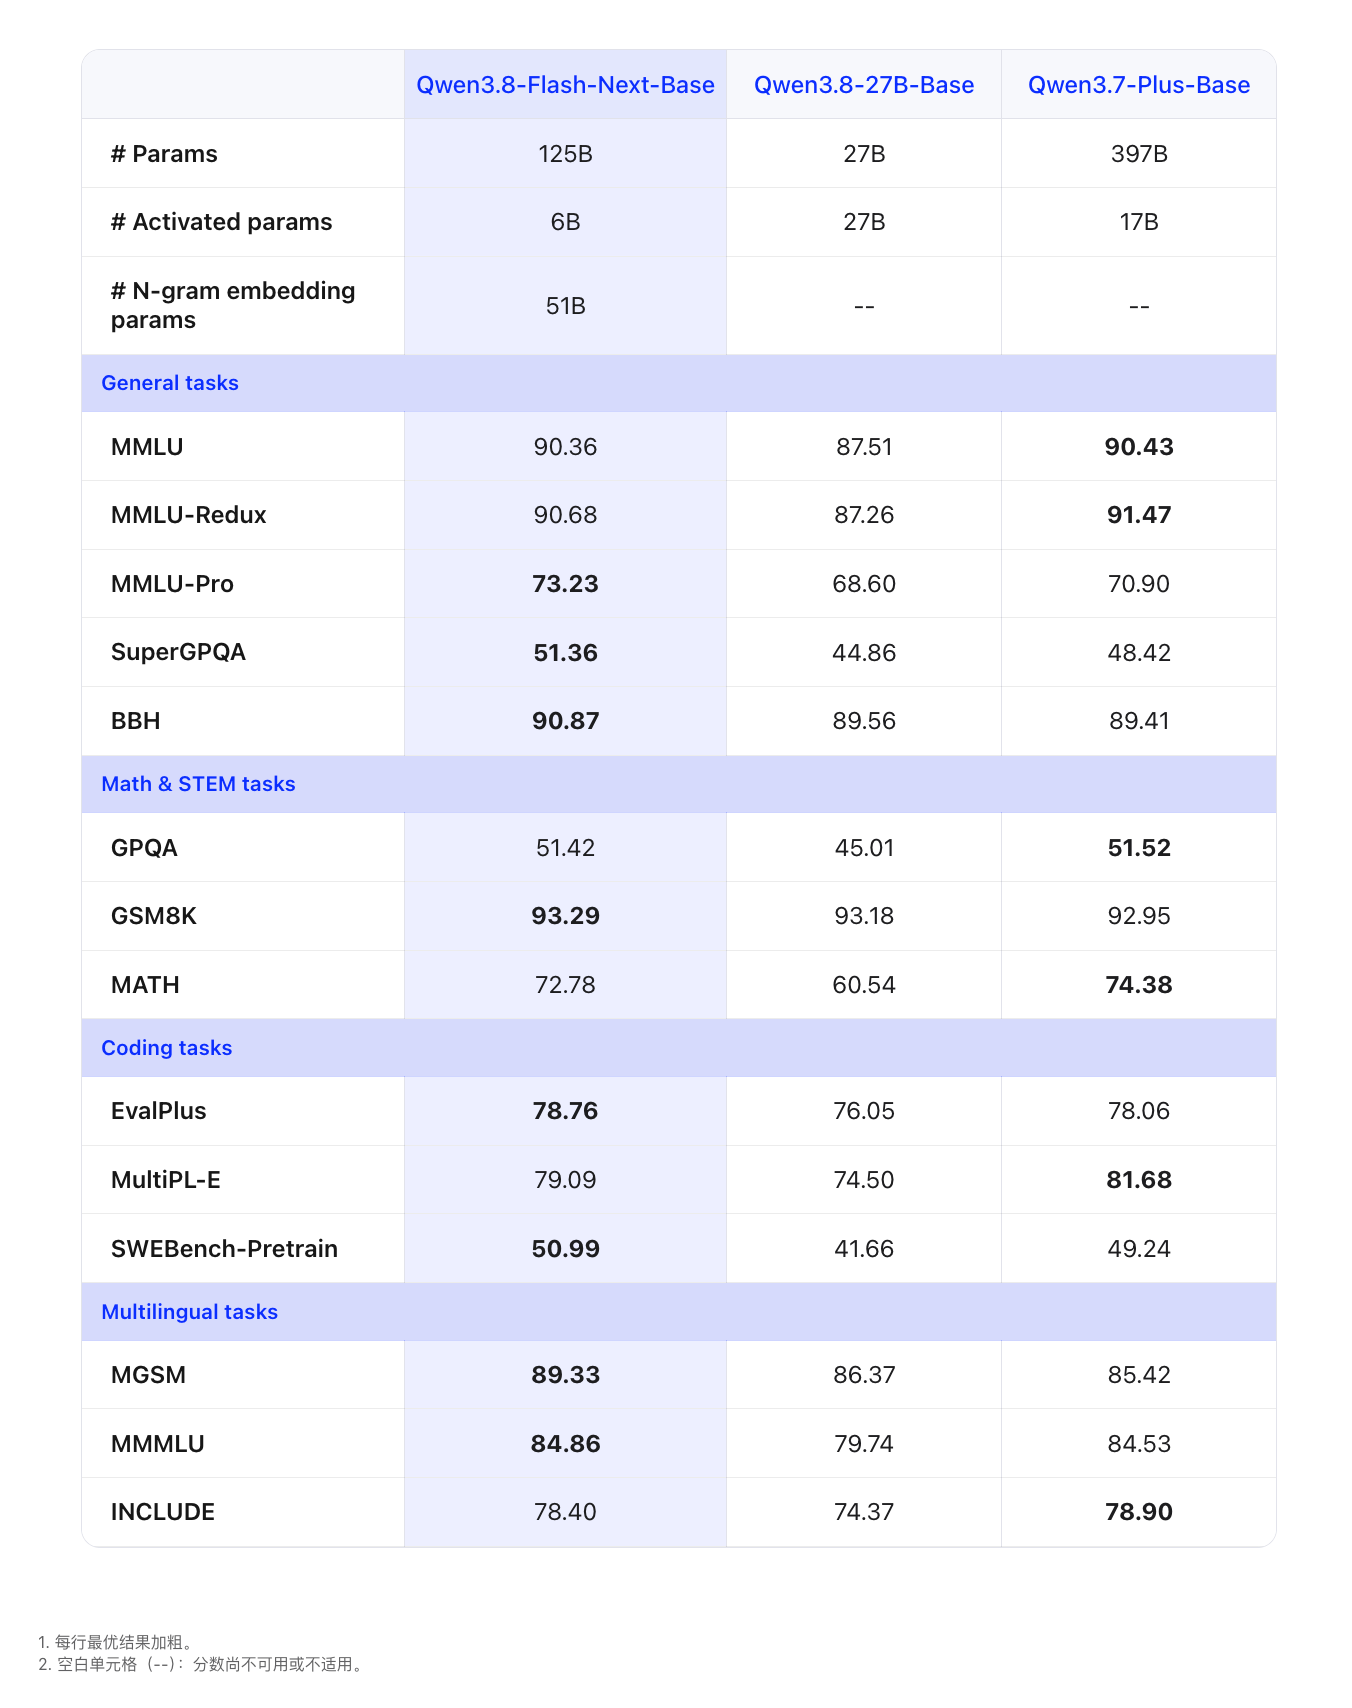
Kwa vigezo 6B vilivyoamilishwa, Qwen3.8-Flash-Next-Base ilipata matokeo bora katika benchmark 8 kati ya 14, zikiwemo MMLU-Pro, SuperGPQA, BBH, SWEBench-Pretrain, MGSM na MMMU.
Maandishi pekee:
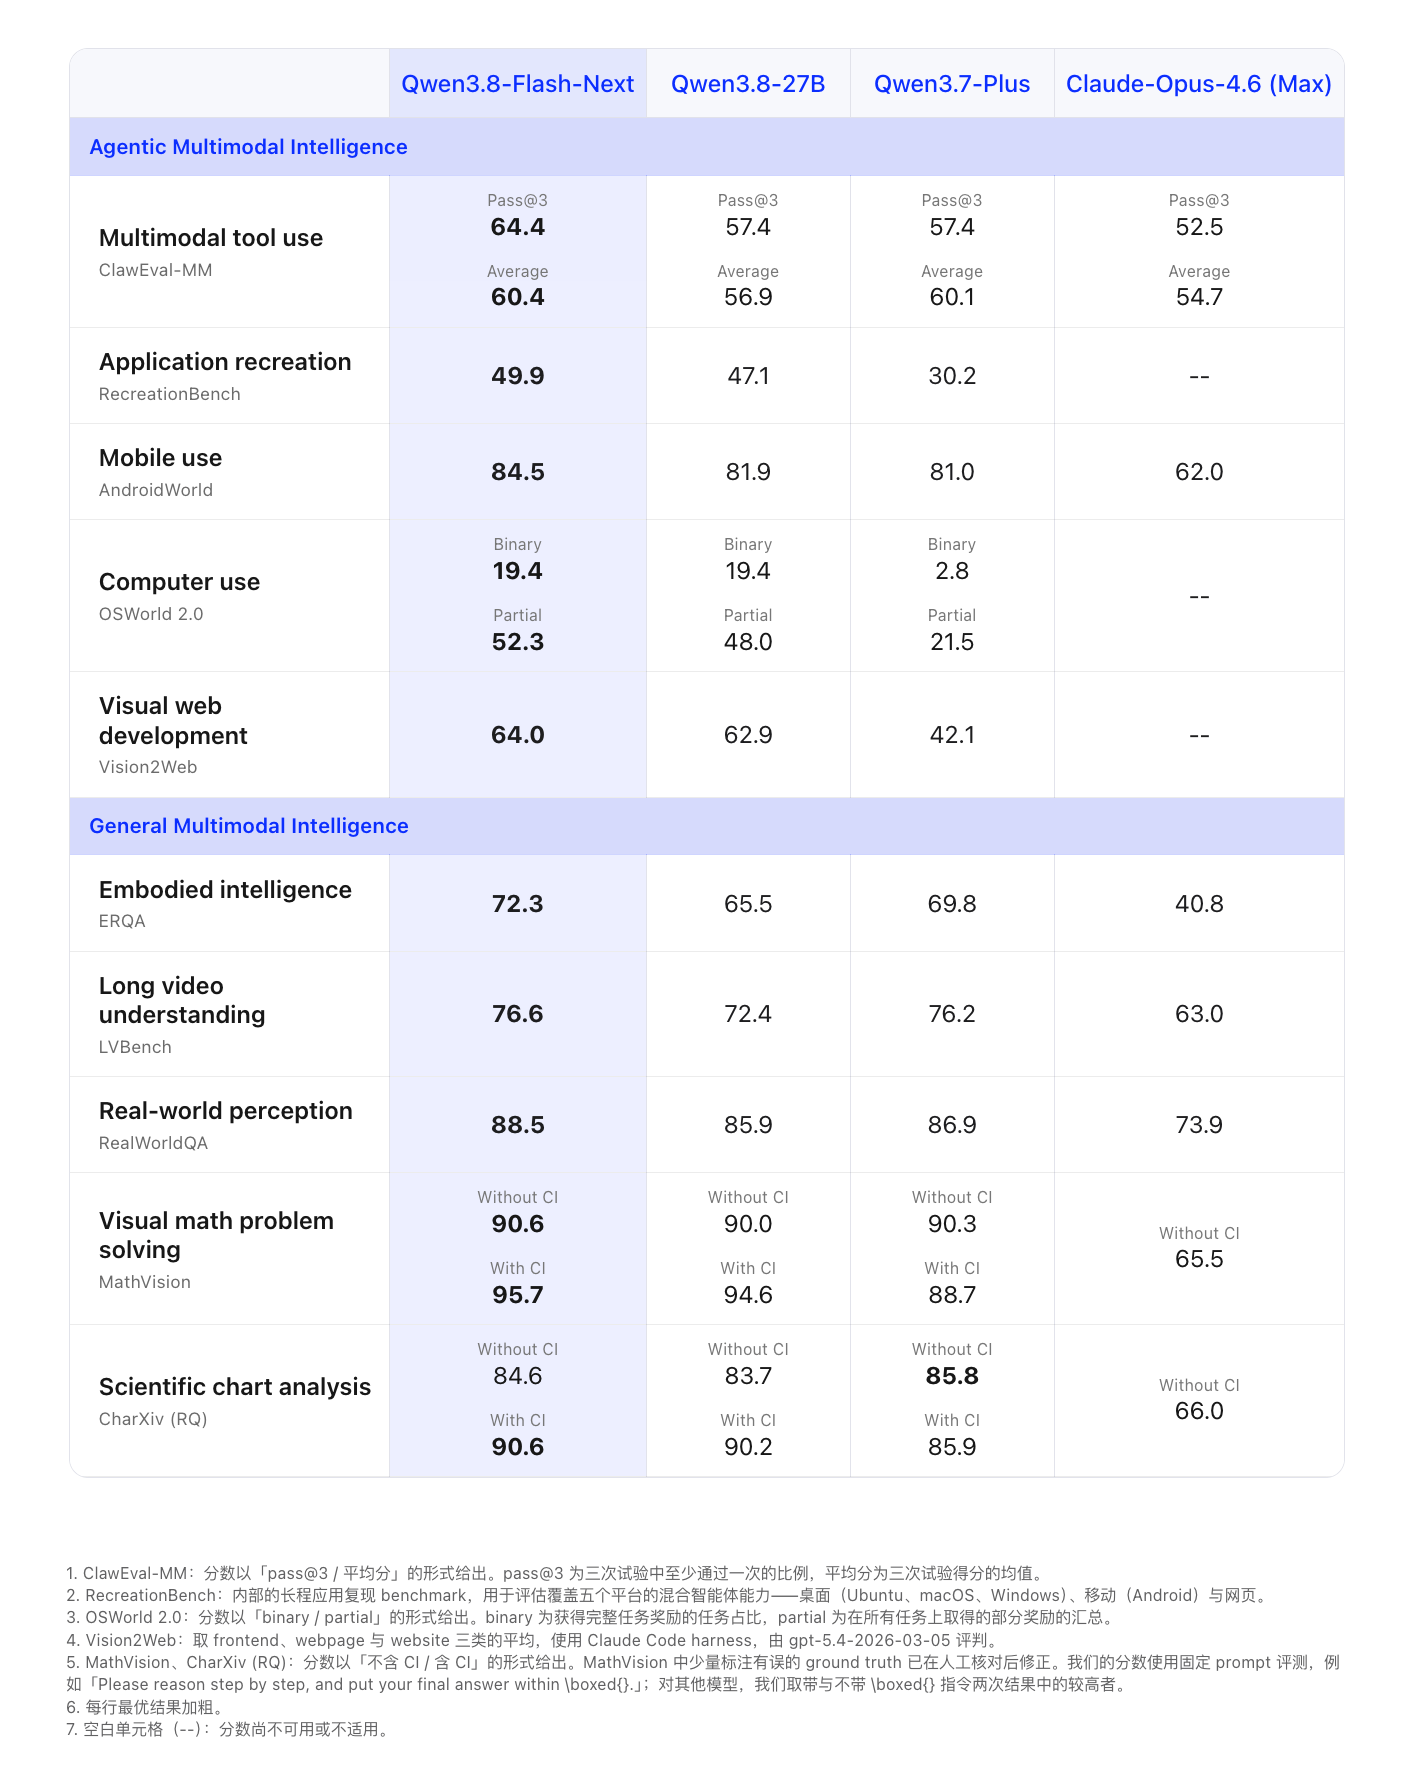
Multimodali:
Muundo wa modeli:
Utendaji wa modeli ya Base:
Qwen3.8-Flash itazinduliwa hivi karibuni kwenye jukwaa la Qwen AI na kutoa huduma za API kwa umma, kwa bei ya yuan 1 kwa kila tokeni milioni ya ingizo na yuan 3 kwa kila tokeni milioni ya towe.
Uzani wa muundo ulitolewa kwa chanzo huria saa 23:00 kwa saa za Beijing tarehe 26 Agosti kwenye majukwaa ya Hugging Face na ModelScope, pamoja na kutolewa kwa toleo lililopunguzwa kwa FP8. Qwen3.8-Flash-Next inaunga mkono muktadha wa 1M kwa chaguo-msingi na ina zana rasmi zilizojengewa ndani.
Marejeo:
Ripoti ya kiufundi: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
Blogu ya kiufundi: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next