

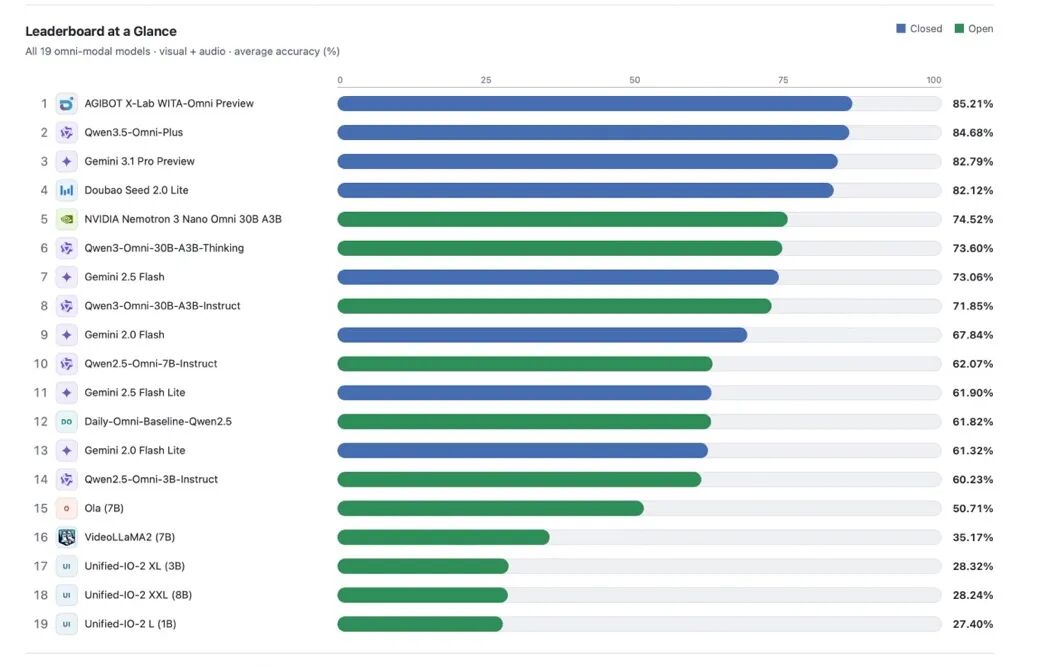
Kulingana na ujumbe wa WeChat wa Zhiyuan AGIBOT, matokeo ya hivi karibuni ya tathmini ya DailyOmni, orodha yenye mamlaka ya uelewa wa multimodali wa mwili, yametangazwa hivi karibuni. Mfano wa akili wa multimodali asilia kwa roboti wenye mwili WITA-Omni Preview, uliotengenezwa na Zhiyuan, umeongoza kwa alama ya jumla ya 85.21 kutokana na uwezo wake bora wa uelewa wa pamoja wa sauti na video na ufanyaji hoja wa mfuatano wa wakati. Umezipita modeli zinazoongoza ndani na nje ya nchi, zikiwemo Qwen, Gemini, Doubao na NVIDIA, na kushika nafasi ya kwanza katika vipimo sita kati ya vinane vya kina.
Kulingana na uelewa wa Nyumba ya IT, DailyOmni ni orodha huru yenye mamlaka inayotambuliwa na sekta kwa kupima ulinganifu wa mfuatano wa wakati wa sauti na video pamoja na uwezo wa kufanya hoja za pamoja kati ya miundo mbalimbali. Tofauti na kazi za kawaida za tathmini zinazolenga picha na maandishi au video fupi, orodha hii hutumia kwa kiasi kikubwa nyenzo za sauti na video kutoka mazingira halisi yaliyo wazi. Inalenga hasa kupima uwezo wa modeli kuunganisha picha za kuona na taarifa za sauti za mazingira, kutambua kwa usahihi uhusiano kati ya sauti na picha, mpangilio wa matukio na maana za miundo mbalimbali—uwezo wa msingi wa utambuzi unaolingana kwa karibu na mahitaji ya roboti wenye umbo la binadamu wanapofanya mwingiliano kati ya binadamu na mashine katika nafasi halisi za kimwili.
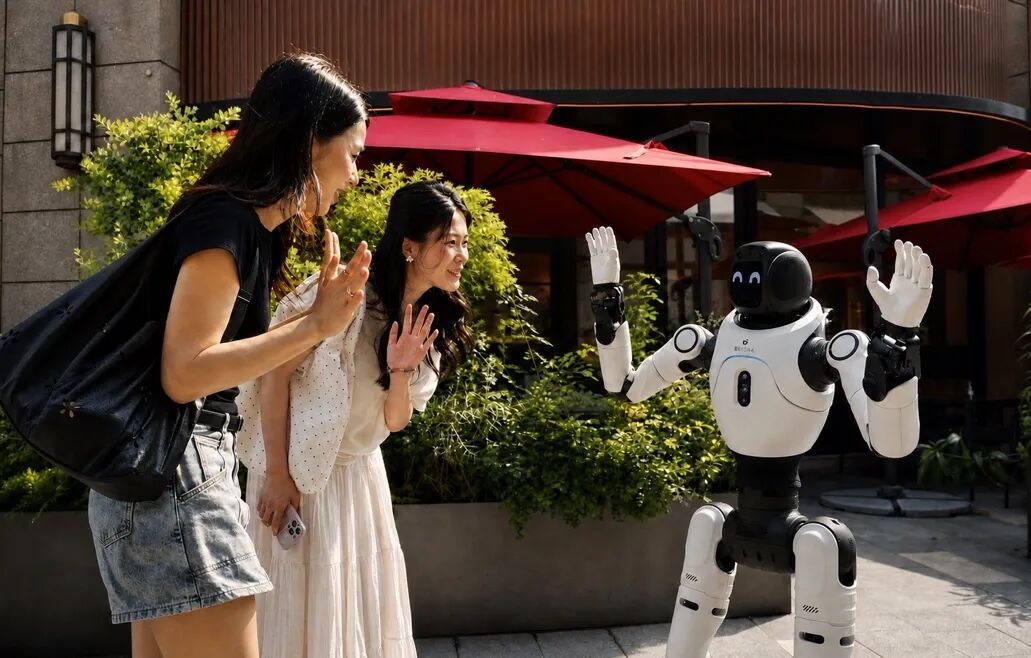
Rasmi wanasema kuwa ufunguo wa ubora wa WITA-Omni ni kwamba haikuwekwa tu kama modeli ya mazungumzo ndani ya roboti. Badala yake, inainua vitendo vya kimwili na sura za uso kuwa matokeo ya kiwango cha kwanza sambamba na sauti, na kutumia modeli asilia ya kutoka mwanzo hadi mwisho kuendesha kwa pamoja utambuzi, ufanyaji maamuzi na uwasilishaji. Hivyo, kutoka kwenye dhana ya Thinker–Talker, imepanuliwa zaidi kuwa usanifu wa Thinker–Talker–Actor unaolenga matokeo ya mwili.
Ubora wa WITA-Omni hautokani tu na ukubwa wa modeli, bali unatokana na mfumo wa data wa ngazi mbalimbali na mbinu za mafunzo zinazolenga mwingiliano wa multimodali wa mwili. Katika hatua ya mafunzo ya kati, WITA-Omni ilitumia data ya multimodali ya chanzo huria na ya ndani yenye jumla ya kiwango cha makumi ya mamilioni ya saa, na kuboresha zaidi msingi imara wa maandishi na picha kuwa modeli ya multimodali inayoweza “kusikia, kuelewa inachoona na kufanya hoja za pamoja za sauti na picha”.
Zaidi ya hayo, data ya sauti na video iliyo wazi kwa umma kwa kawaida hukosa mabadiliko ya zamu za mazungumzo, muda wa majibu, vitendo na taarifa za sura za uso zinazopatikana katika mwingiliano halisi, hivyo ni vigumu kuitumia moja kwa moja kufundisha modeli ya mwingiliano wa mwili kutoka mwanzo hadi mwisho. Kwa sababu hiyo, Zhiyuan ilijenga seti kubwa ya data ya multimodali yenye ubora wa juu, inayomlenga binadamu na mazingira halisi ya mwingiliano, huku ikihifadhi kikamilifu uhusiano wa asili wa mfuatano wa wakati kati ya sauti, picha, lugha, vitendo na sura za uso.