

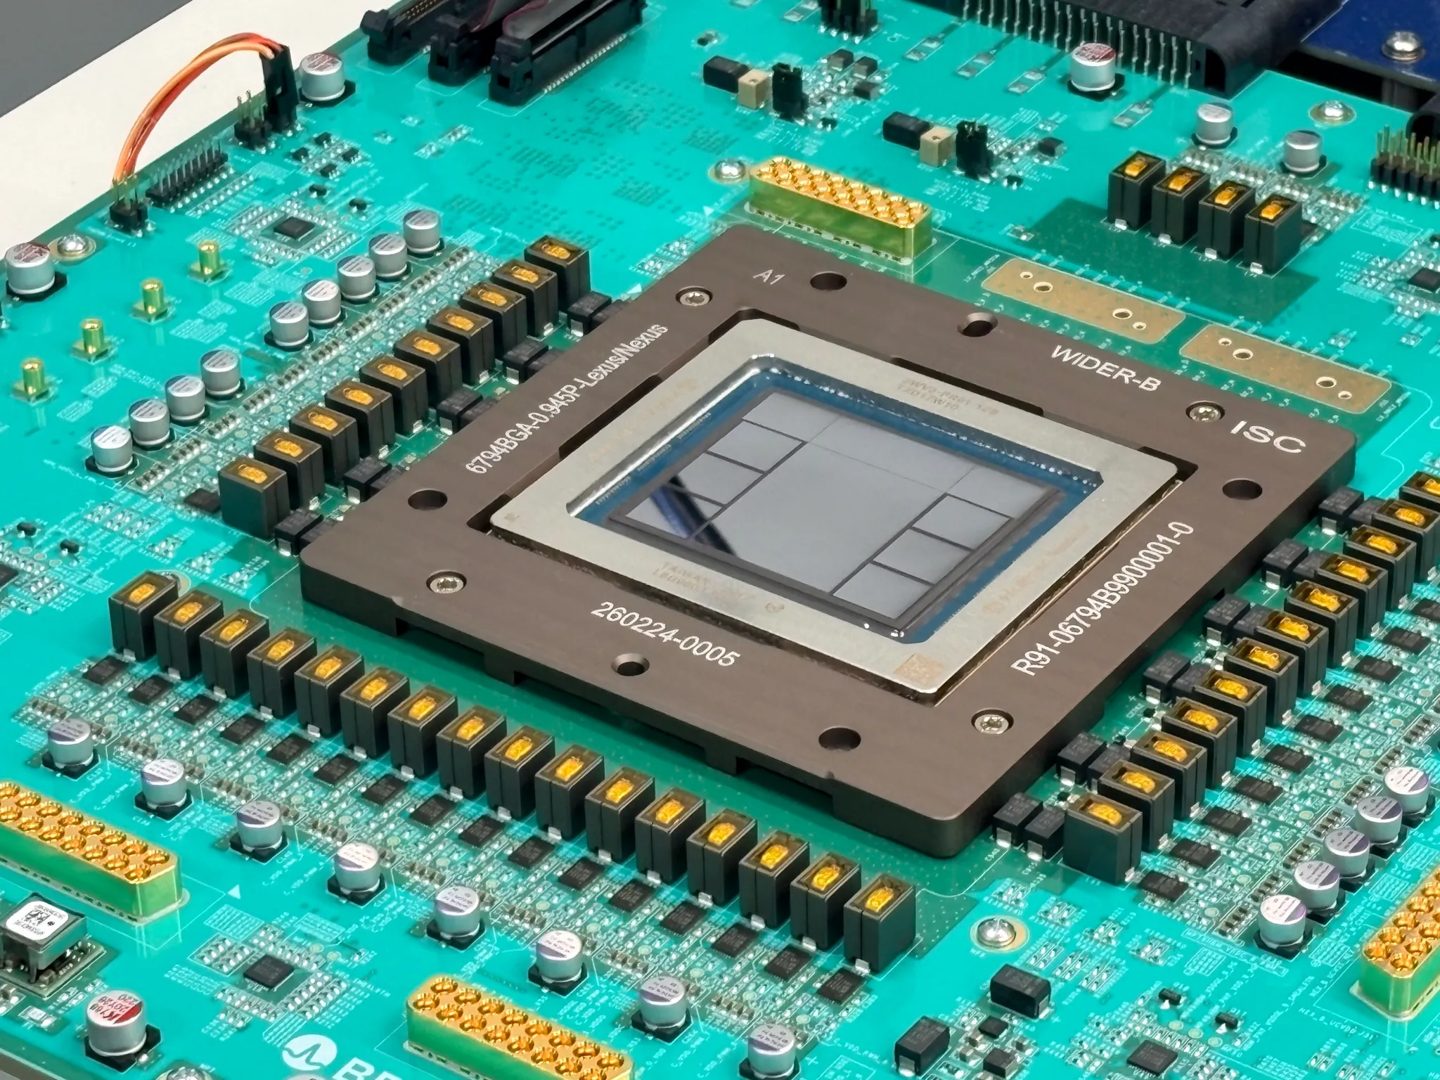
OpenAI ilifichua maelezo zaidi kuhusu mfumo wake mpya wa inference wa Jalapeño katika mkutano wa Hot Chips jana usiku (tarehe 25), na kwa mara ya kwanza ikatangaza matokeo ya vipimo vya utendaji. Katika jaribio la InferenceX la SemiAnalysis, Jalapeño imezidi vichakataji bora zaidi vya inference vilivyo sokoni kwa uchakataji wa tokeni kwa mtumiaji mmoja na kwa throughput kwa kila kilowati.
Richard Ho, mkuu wa maunzi wa OpenAI, alisema katika mkutano wa simu na vyombo vya habari: “Jambo muhimu zaidi katika matokeo ya vipimo ni kwamba Jalapeño imepata ongezeko kubwa sana la utendaji ikilinganishwa na bidhaa za kisasa zaidi kwa sasa. Inaweza kushughulikia mizigo mingi zaidi ya AI kwa kutumia kiwango kilekile cha umeme, huku ikitoa majibu kwa haraka zaidi. Jalapeño inafaa kuhudumia idadi kubwa ya watumiaji kwa ufanisi, na pia inaweza kudumisha latency ya chini sana.”
Jalapeño imetengenezwa kwa pamoja na OpenAI na Broadcom, huku miundo ya OpenAI yenyewe pia ikishiriki katika mchakato wa utafiti na maendeleo. OpenAI inatarajia kuibadilisha Jalapeño kuwa jukwaa la kiteknolojia linaloweza kuendelezwa kupitia vizazi kadhaa, ili bidhaa za AI, miundo, chipu na kumbukumbu zibuniwe kwa ushirikiano tangu mwanzo.
Chipu hii inahusika hasa na inference ya AI, yaani kuendesha kwa vitendo miundo ya AI ambayo tayari imefunzwa ili itekeleze kazi au kuendesha mawakala mahiri wa AI.
OpenAI ilitumia jukwaa la InferenceX kupima utendaji wa inference wa Jalapeño na kuulinganisha na mifumo ya superchip ya Nvidia GB200 na GB300. OpenAI ilisema kuwa kwenye miundo ya GPT-OSS 120B, DeepSeek R1 na Kimi K2.5 1T, kiasi cha kazi za AI ambacho Jalapeño inaweza kukamilisha kwa kila wati ni mara 1.5 hadi 1.9 ya mifumo ya kulinganisha, huku latency ya mwisho hadi mwisho ikiwa takribani 28% hadi 59% ya mifumo hiyo.
Uendelezaji wa pamoja wa mfumo mzima pia umeiwezesha OpenAI kuboresha moja kwa moja hatua zinazoelekea kupunguza kasi wakati wa inference. Jalapeño inalenga kupunguza latency katika hatua za prefill na mawasiliano, ambazo kwa mtazamo wa OpenAI mara nyingi huwa vikwazo vikuu vya utendaji wa inference.
Katika makala ya blogu iliyotangaza matokeo ya vipimo, OpenAI ilisema kuwa Jalapeño iliundwa tangu mwanzo kwa lengo la kupunguza uhamishaji wa data na latency ya mawasiliano kadiri iwezekanavyo. Hali za modeli kama akiba ya KV inayotumiwa wakati wa kutengeneza majibu zinaweza kuhifadhiwa na kubaki wazi katika eneo la ndani, kisha mfumo hugawa rasilimali zinazofaa za kompyuta, kumbukumbu na mtandao kulingana na hatua tofauti za inference.
Kulingana na IT之家, OpenAI inapanga kuanza kusambaza Jalapeño kwa kiwango kidogo kabla ya mwisho wa mwaka huu, kisha kuongeza hatua kwa hatua kiasi cha usambazaji mwaka 2027, lakini haijatangaza ni chipu ngapi hasa itakazowekeza mwaka ujao.
Marejeo
Makala rasmi ya OpenAI: Jalapeño’s first results show industry-leading speed and efficiency in AI inference