
- Ziara za kila mwezi
- 0
- Bei
- Haijawekwa
- Imeorodheshwa
- —
- Imesasishwa
- 2026-10-10
01TalkLikeYou ni nini
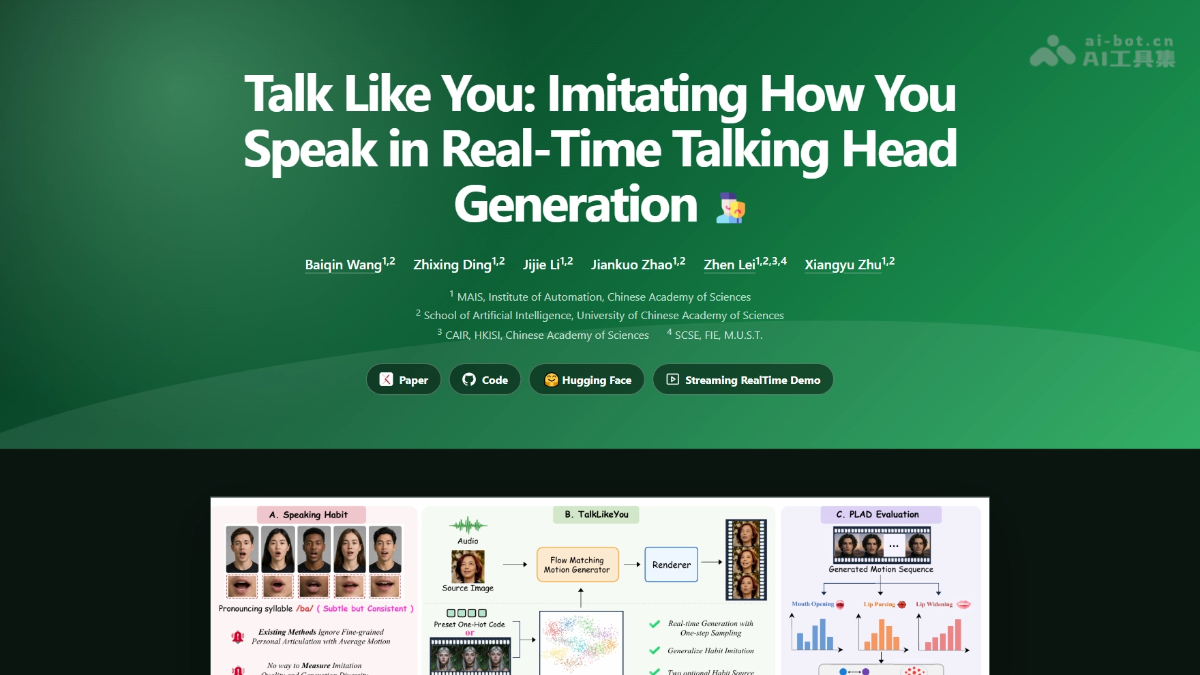
TalkLikeYou ni mfumo wa wazi wa binadamu wa kidijitali wa wakati halisi uliotengenezwa na Taasisi ya Uendeshaji Kiotomatiki ya Chuo cha Sayansi cha China. Ukipewa picha na sauti, unaweza kumfanya mtu aliye kwenye picha aanze kuzungumza, huku miondoko ya mdomo ikiiga tabia ya kuzungumza ya mtu halisi aliyechaguliwa. TalkLikeYou hutumia uundaji wa mfano wa nafasi ya mwendo na sampuli ya hatua moja ili kuzalisha video kwa wakati halisi. Inasaidia kubinafsisha tabia kupitia nambari iliyowekwa tayari au video ya marejeo, inapendekeza vipimo maalumu vya kupima ufanano wa uigaji, na msimbo pamoja na uzani wake vimewekwa wazi kikamilifu.
02Kazi kuu za TalkLikeYou
Picha inayozungumza: Pakia picha ya uso wa mtu na sauti, kisha utengeneze video ya mtu huyo akizungumza.
Uigaji wa tabia: Iga tabia ya kuzungumza ya mdomo ya mtu halisi aliyechaguliwa, kwa kutumia nambari iliyowekwa tayari au video ya marejeo ya sekunde 4.
Uzalishaji wa wakati halisi: Hutumia teknolojia ya sampuli ya hatua moja, kwa kasi ya hadi 32.43 FPS, na inasaidia utoaji wa mtiririko kwa wakati halisi.
Ubadilishaji wa sauti kwenye video: Badilisha miondoko ya mdomo ya mtu kwenye video huku ukihifadhi miondoko ya awali ya kichwa na mpangilio wa muda, jambo linalofaa kwa kuweka sauti katika lugha nyingi.
Binadamu wa kidijitali wa mazungumzo: Baada ya kuunganishwa na modeli kubwa pamoja na utambuzi na usanisi wa sauti, inaweza kutengeneza nakala ya kidijitali inayowasiliana kwa wakati halisi.
Uendeshaji wa mitindo: Inasaidia kuendesha picha za mitindo isiyo ya watu halisi, kama michoro, uchoraji wa mafuta, anime na wahusika wa 3D.
03Kanuni ya teknolojia ya TalkLikeYou
Mfuate WeChat na ujibu “开源” ili ujiunge na kundi la mawasiliano la miradi ya AI yenye msimbo wazi
Uundaji wa mfano wa nafasi ya mwendo: Tofauti na kuzalisha picha moja kwa moja katika nafasi ya pikseli, TalkLikeYou kwanza huchanganua picha kuwa vigezo vya mwendo, kisha hujifunza na kuzalisha vitendo vya kuzungumza kwenye tarakimu hizi nyepesi, na hatimaye huvitengeneza kuwa video kupitia kirekebishaji. Hivyo huunganisha kasi na uthabiti wa utambulisho.
Sampuli ya Flow Matching ya hatua moja: Hutumia Flow Matching kujifunza njia iliyonyooka kutoka kwenye kelele hadi lengwa, kisha hutumia upangaji upya wa vigezo kutabiri moja kwa moja mfuatano safi wa mwendo. Sampuli ya hatua moja hufikia ubora wa ulandanishi wa midomo unaokaribia ule wa hatua 50, na kufanikisha kasi ya wakati halisi ya 32.43 FPS.
Nafasi ya pamoja ya tabia: Huunda nafasi ya vekta za tabia yenye vipimo vichache inayoweza kuingiliana. Takwimu za miondoko ya midomo ya watu halisi kwenye data hukandamizwa kuwa usimbaji wa one-hot, huku video ya marejeo ikiingizwa kwenye nafasi hiyo hiyo kupitia kichota tabia. Njia hizi mbili zinaweza kubadilishana kwa uhuru au hata kuchanganywa kwa kuingiliana.
Mbinu ya mafunzo ya hatua mbili: Kwanza, hutumia one-hot kujifunza “tabia ni nini” kwenye HDTF yenye watu 380, kisha hutumia video za marejeo kwenye CelebV-HQ yenye kiwango kikubwa kujifunza uwezo wa jumla. Data ya one-hot huchezwa tena mara kwa mara ili kuzuia kusahau, na hivyo kuongeza ufanano wa tabia kutoka 0.33 hadi 0.64.
Kipimo cha PLAD: Hupanga mwendo wa mdomo kwenye mhimili mitatu ya matamshi: kiwango cha kufungua mdomo, kukunjamana kwa midomo na kunyooshwa kwa midomo. Hulinganisha histogramu za usambazaji na mtu wa marejeo ili kukokotoa ufanano, na kwa mara ya kwanza hutoa kiwango cha kupima ikiwa “tabia ya kuzungumza inafanana au la”.
04Jinsi ya kutumia TalkLikeYou
Maandalizi ya mazingira: Tumia mfumo wa Linux, sakinisha Python 3.10 + CUDA 12.1 + FFmpeg, na uhakikishe kuwa kadi ya NVIDIA ina angalau 12GB ya kumbukumbu ya video.
Pakua msimbo: Kloni hazina kuu ya TalkLikeYou kutoka GitHub.
Sakinisha utegemezi: Tekeleza conda env create -f environment.yaml ili kuunda na kuamilisha mazingira, au sakinisha mwenyewe PyTorch ya CUDA kisha utekeleze pip install -r requirements.txt.
Pakua uzani: Tumia amri ya Hugging Face hf download doubi-killer/TalkLikeYou kupakua uzani wa modeli kwenye mzizi wa hazina.
Andaa nyenzo: Andaa picha ya mtu (au video) na sauti; video ya kuingiza lazima iwe na 25 FPS.
Tekeleza uelekezaji: Tekeleza python -m talklikeyou --source picha --audio sauti --person-id 192 --sampling-steps 1 ili kuzalisha video. Badilisha --person-id ili kubadilisha tabia ya kuzungumza.
Badilisha tabia: Badilisha --person-id kuwa --habit-reference na uelekeze kwenye video ya marejeo yenye angalau fremu 100 ili kuiga tabia ya kuzungumza ya mtu kwenye video hiyo.
Kuweka sauti kwenye video: Elekeza --source kwenye faili la video na uongeze --pose-mode source; hii hubadilisha miondoko ya mdomo pekee huku ikihifadhi miondoko ya awali ya kichwa.
05Faida kuu za TalkLikeYou
Uigaji maalumu wa tabia ya kuzungumza: Mfumo wa kwanza wa wazi katika sekta unaochukulia tabia binafsi ya kuzungumza kwa mdomo kama kipengele muhimu cha uundaji wa mfano. Unaweza kubainishwa kwa nambari au video, na kuondoa tatizo la midomo inayofanana kwa kila mtu.
Kasi ya juu ya wakati halisi: Sampuli ya Flow Matching ya hatua moja hufikia 32.43 FPS, karibu mara mia zaidi ya Sonic ya njia ya usambazaji wa picha, huku ikitumia chini ya 4GB ya kumbukumbu ya video kwenye RTX 3090 moja.
Ubora wa picha na ulandanishi kwa pamoja: FID 7.71 ni chini ya theluthi moja ya mshindani wa pili, huku Sync-C 8.73 ikiwa ya juu zaidi, na hivyo kudumisha ulandanishi wa midomo pamoja na ubora wa picha.
Ufanano bora wa tabia: Kipimo cha PLAD kinaonyesha ufanano wa tabia wa 0.62, ulio juu kwa kiasi kikubwa kuliko MimicTalk (0.48), PC-Talk (0.39) na washindani wengine.
Njia mbili za ubinafsishaji: Inasaidia kubadilisha mitindo bila gharama kwa kutumia nambari rasmi zilizowekwa tayari, kujifunza kutoka kwa video yoyote ya marejeo, na kuunda tabia mpya kupitia uingiliano.
06Anwani za mradi wa TalkLikeYou
Tovuti rasmi ya mradi: https://bq-wang0511.github.io/TalkLikeYou/
Hazina ya GitHub: https://github.com/BQ-Wang0511/TalkLikeYou
Hazina ya modeli ya HuggingFace: https://huggingface.co/doubi-killer/TalkLikeYou
Makala ya kiufundi ya arXiv: https://arxiv.org/pdf/2610.06658
07Matukio ya matumizi ya TalkLikeYou
Mtangazaji wa mtandaoni / uuzaji wa moja kwa moja: Unda mtangazaji wa mtandaoni mwenye tabia binafsi ya kuzungumza kwa gharama ndogo. Inaweza kufanya kazi wakati halisi kwenye kompyuta ya ndani ikiwa na 4GB ya kumbukumbu ya video, bila mtu halisi kuonekana.
Kuweka sauti katika video za lugha nyingi: Badilisha miondoko ya mdomo ya mtu kwenye video huku ukihifadhi miondoko na mpangilio wa muda wa kichwa, ili mwendo wa midomo wa filamu zilizotafsiriwa au maudhui ya kimataifa uendane kiasili na lugha lengwa.
Nakala ya kidijitali / huduma kwa wateja ya mtandaoni: Unganisha modeli kubwa na usanisi wa sauti ili kuunda nakala ya mazungumzo ya wakati halisi, kwa matumizi katika huduma kwa wateja mtandaoni, mwongozo mahiri na matukio mengine yanayohitaji mwingiliano wa “ana kwa ana”.
Elimu / mafunzo yaliyobinafsishwa: Unda taswira ya kidijitali maalumu kwa mwalimu au mkufunzi, ukiiga mtindo wake wa kipekee wa kuzungumza kwa ajili ya kurekodi kozi au kufundisha kwa mbali.
© Kanusho: vikoa na maudhui yaliyounganishwa vinaweza kubadilika kadiri muda unavyopita. AIEZZ haidhibiti tovuti za wahusika wengine. Kagua maudhui na hatari za nje kwa kujitegemea.
Ukaguzi wa watumiaji0