
- Ziara za kila mwezi
- 0
- Bei
- Haijawekwa
- Imeorodheshwa
- —
- Imesasishwa
- 2026-10-15
01DMAD ni nini
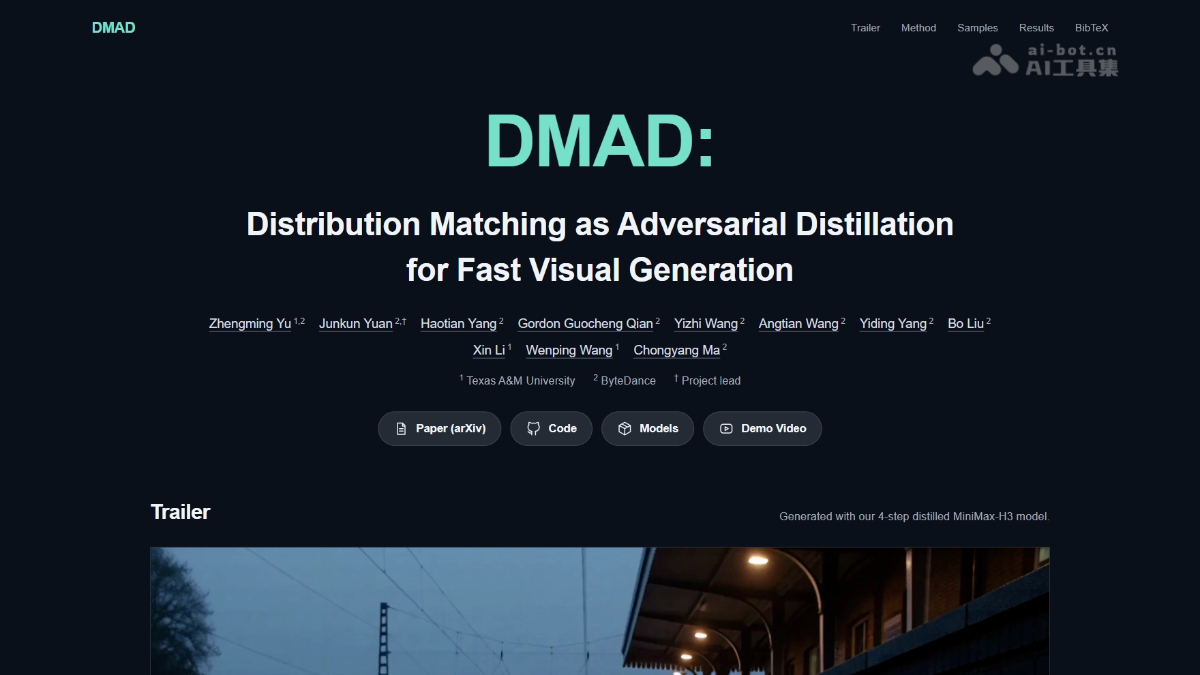
DMAD (Distribution Matching as Adversarial Distillation) ni mfumo wa kunereka kwa hatua chache uliotolewa kwa pamoja na ByteDance na Chuo Kikuu cha Texas A&M, unaolenga kuharakisha uzalishaji wa miundo ya diffusion. DMAD hufunza kibagua cha uainishaji wa madaraja mawili kujifunza moja kwa moja tofauti kati ya usambazaji lengwa na usambazaji wa mwanafunzi, hivyo kuondoa hitaji la modeli saidizi ya diffusion na kunereka modeli ya mwalimu ya hatua 50 kuwa modeli ya mwanafunzi ya hatua 4. Sasa inasaidia ImageNet, SDXL, Wan2.1 na MiniMax-H3-33B; GPU yenye 8GB VRAM inaweza kuzalisha video yenye sauti ya takribani sekunde 5 na ukubwa wa 1344×768.
02Vipengele vikuu vya DMAD
Uzalishaji wa picha kwa hatua chache: hunereka modeli ya EDM ya ImageNet-64 hadi sampuli ya hatua 1, ikiwa na FID ya chini hadi 1.04; SDXL huhitaji hatua 4 pekee kwa uzalishaji wa maandishi hadi picha.
Uzalishaji wa video kutoka maandishi kwa hatua chache: hunereka Wan2.1-T2V-14B kuwa modeli ya mwanafunzi ya hatua 4, na kufikia VBench ya 85.15.
Uzalishaji wa pamoja wa sauti na video: hunereka modeli ya mwalimu ya MiniMax-H3-33B yenye hatua 50 hadi hatua 4, na kutoa video ya 1344×768 pamoja na sauti asilia ya stereo ya 32kHz.
Usaidizi wa vifaa vya watumiaji: hutoa mtiririko wa ComfyUI kwa 8GB VRAM na uelekezaji wa mstari wa amri wenye matumizi madogo ya VRAM; GPU ya 8GB inaweza kuzalisha video yenye sauti ya takribani sekunde 5, na ya 12GB takribani sekunde 15.
Mafunzo na uelekezaji wa chanzo huria: hutoa mbinu ya kunereka, msimbo wa mafunzo, hati za uelekezaji na uzani wa LoRA wa miundo mingi, zikitumia mstari wa amri na ComfyUI.
03Kanuni ya kiteknolojia ya DMAD
Fuata akaunti ya WeChat na ujibu “开源” ili ujiunge na kikundi cha majadiliano cha miradi ya AI ya chanzo huria
Ulinganishaji wa usambazaji kama kunereka pinzani: DMAD hufunza kibagua cha uainishaji wa madaraja mawili kutofautisha sampuli lengwa na sampuli za mwanafunzi. Logit ya kibagua bora ni sawa na uwiano wa msongamano wa uwezekano wa logaritmi wa usambazaji miwili; gradient ya ingizo lake hutoa tofauti ya score, ikitoa moja kwa moja mwelekeo wa kusahihisha mwanafunzi na kuondoa modeli saidizi ya kukadiria score.
Msingi wa pamoja na vichwa viwili vya kibagua: kibagua hutumia msingi mmoja wa vipengele unaoshirikiwa na vichwa viwili vya uainishaji. Kichwa cha mwalimu hutofautisha sampuli za mwalimu na za mwanafunzi, huku kichwa cha data halisi kikitofautisha sampuli halisi na za mwanafunzi; vyote hufunzwa kwa entropia mtambuka ya binary. Mwanafunzi husasishwa kwa hasara ya mstari yenye uzani inayotumia logits mbili; wakati wa usasishaji, vigezo vya kibagua hugandishwa lakini uenezaji wa gradient huhifadhiwa.
Upimaji wa uzani kulingana na vipindi vya kelele: tofauti ya usambazaji kati ya sampuli za mwalimu na data halisi hubadilika kulingana na kiwango cha kelele. DMAD hutumia tofauti ya wastani ya logits ya kichwa cha data halisi kwenye aina mbili za sampuli kama ishara ya kimajaribio, na kufuatilia kila kipindi cha kelele kwa wastani unaosogea wa kielelezo wenye upunguzaji wa 0.99. Vipindi vyenye tofauti ndogo hupata uzani mkubwa zaidi wa mwalimu, kisha uzani huo hushirikishwa katika hasara ya mwanafunzi baada ya kusawazishwa.
Mafunzo ya haraka kwa sampuli za mwalimu za nje ya mtandao: mwalimu hutoa sampuli zilizozalishwa na kuhifadhiwa mapema pekee, hivyo hakuna haja ya kumwita mtandaoni wakati wa mafunzo. Kwa usanidi wa 4 H200 na LoRA ya MiniMax-H3 yenye rank-128, muda wa kila usasishaji wa mwanafunzi pamoja na usasishaji unaohusiana wa kibagua umepungua kutoka sekunde 818.1 hadi 233.3, na kufanikisha kasi ya mafunzo iliyo karibu mara 3.51.
04Jinsi ya kutumia DMAD
Clone hazina: endesha git clone https://github.com/Yzmblog/DMAD.git kisha uingie kwenye saraka ya mradi.
Unda mazingira: tumia conda kuunda mazingira ya Python 3.12 na kuyaamilisha.
Sakinisha utegemezi: sakinisha PyTorch 2.11.0 (cu126), torchvision na torchaudio kwa matoleo rasmi yaliyowekwa, kisha endesha pip install -r requirements.txt na pip install -U modelscope-hub.
Andaa vifaa: hakikisha una GPU ya NVIDIA inayotumia CUDA, pamoja na takribani 64GB ya kumbukumbu ya mfumo na 170GB ya nafasi ya diski.
Pakua modeli ya msingi: tumia modelscope download MiniMax/MiniMax-H3 kupakua modeli ya msingi ya MiniMax-H3.
Pakua uzani wa kunereka: pakua LoRA ya DMAD ya hatua 4 kutoka ModelScope.
Uelekezaji wa mstari wa amri: endesha inference.py na ubainishe njia ya modeli, LoRA, faili ya vidokezo, --steps 4, --height 768 --width 1344; chagua --low-vram 8 au --low-vram 12 kulingana na VRAM.
Angalia matokeo: saraka ya matokeo ina 0000.mp4, faili ya txt ya vidokezo na settings.json; baada ya kuthibitisha kuwa inafanya kazi, unaweza kubadilisha faili ya vidokezo na yako mwenyewe.
05Faida kuu za DMAD
Kuongeza kasi kubwa kwa uelekezaji: hunereka modeli ya mwalimu ya hatua 50 kuwa modeli ya mwanafunzi ya hatua 4, na kupunguza marudio ya kuondoa kelele kwa zaidi ya 92% huku ikidumisha ubora unaokaribia wa mwalimu.
Ufanisi mkubwa wa mafunzo: kibagua hujifunza moja kwa moja tofauti ya usambazaji, hivyo kuondoa modeli saidizi ya diffusion; kwenye 4 H200, masasisho ya mafunzo huharakishwa takribani mara 3.51.
Ubora bora wa uzalishaji: uzalishaji wa hatua moja kwenye ImageNet-64 hufikia FID ya 1.04, bora kuliko mbinu kama DMD2 na SiDA; katika tathmini za binadamu, kiwango cha upendeleo wa jumla dhidi ya DMD2 ni 79.1%, na dhidi ya rCM ni 84.6%.
Ufikiaji wa hali zote za multimodali: mfumo mmoja unaunga mkono picha, video kutoka maandishi na uzalishaji wa pamoja wa sauti na video.
06Anwani za mradi wa DMAD
Tovuti rasmi ya mradi: https://yzmblog.github.io/projects/DMAD/
Hazina ya GitHub: https://github.com/Yzmblog/DMAD
Hazina ya modeli ya HuggingFace: https://huggingface.co/ZhengmingYu/DMAD
Karatasi ya kiufundi ya arXiv: https://arxiv.org/pdf/2610.02188
07Matumizi ya DMAD
Uundaji wa maudhui ya video fupi: huzalisha video za sekunde 5–15 zenye sauti asilia kwa hatua 4; waundaji wanaweza kutumia GPU ya watumiaji yenye 8GB kuzalisha haraka nyenzo za mitandao ya kijamii, na kupunguza kwa kiasi kikubwa gharama za uzalishaji.
Uzalishaji wa nyenzo za matangazo na uuzaji: chapa zinaweza kutumia vidokezo kuzalisha kwa wingi video za maonyesho ya bidhaa na matukio, pamoja na sauti ya ubora wa juu, na kufupisha muda kutoka wazo hadi nyenzo ya mwisho ya tangazo.
Uigaji wa awali wa filamu na usanifu wa dhana (Previs): waongozaji na timu za sanaa wanaweza kutumia kunereka kwa hatua chache kuzalisha haraka uigaji wa awali wa shots, marejeo ya mandhari na rasimu za storyboard, na kuharakisha marudio ya ubunifu wa awali.
Uzalishaji wa mali za michezo na uhuishaji: huzalisha uhuishaji wa wahusika, picha za dhana za mandhari na nyenzo za mandhari zenye mwendo, na kusaidia studio huru za michezo na timu ndogo za uhuishaji kupunguza gharama za uzalishaji wa mali.
© Kanusho: vikoa na maudhui yaliyounganishwa vinaweza kubadilika kadiri muda unavyopita. AIEZZ haidhibiti tovuti za wahusika wengine. Kagua maudhui na hatari za nje kwa kujitegemea.
Ukaguzi wa watumiaji0