
- Ziara za kila mwezi
- 0
- Bei
- Haijawekwa
- Imeorodheshwa
- —
- Imesasishwa
- 2026-09-08
01LLaDA-Image ni nini
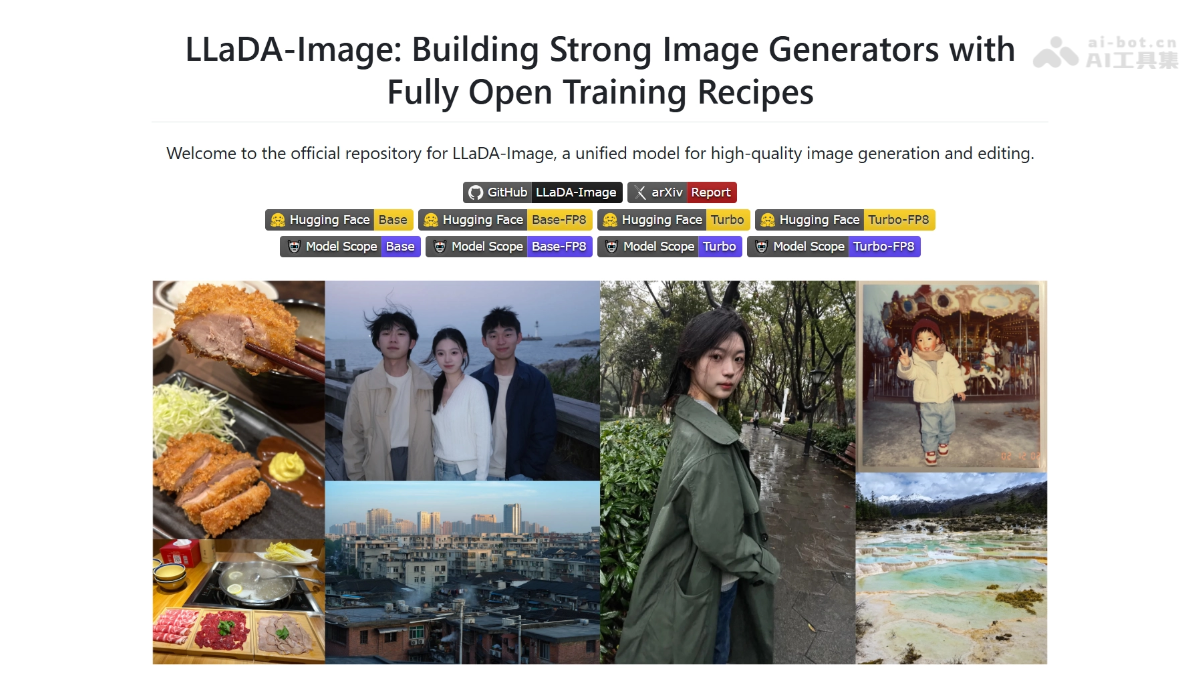
LLaDA-Image ni modeli ya umoja ya uzalishaji na uhariri wa picha yenye vigezo bilioni 6, iliyotolewa kama chanzo huria na inclusionAI ya Ant Group. Modeli hii hutumia mkakati bunifu wa kuanza na mafunzo ya awali ya picha tupu, kisha kuoanisha lugha, na usanifu kamili wa difyusheni (LLaDA2.0-mini kwa uelewa + 6B DiT kwa uzalishaji) ili kutekeleza ubadilishaji wa maandishi kuwa picha, uhariri kwa maagizo na uonyeshaji wa maandishi ya Kichina na Kiingereza. Toleo la Turbo huhitaji hatua 2–4 pekee kutengeneza picha, na limeongoza miongoni mwa modeli huria katika mashindano yote mawili ya Kichina na Kiingereza ya Qwen-Image-Bench.
02Kazi kuu za LLaDA-Image
Uzalishaji wa maandishi kuwa picha: Tengeneza picha zenye uhalisia wa hali ya juu, maelezo mengi na ubora wa picha halisi kulingana na maelezo ya lugha asilia.
Uhariri wa picha kwa maagizo: Pakia picha ya marejeleo na uweke maagizo ya lugha asilia ili kurekebisha eneo mahususi kwa usahihi huku sehemu nyingine zikibaki bila kubadilika.
Uonyeshaji wa maandishi ya Kichina na Kiingereza: Onyesha kwa usahihi maandishi ya Kichina na Kiingereza ndani ya picha zinazozalishwa, ukisaidia mabango, upangaji wa maandishi na usanifu wa maandishi ya kisanii.
Uzalishaji wenye masharti ya VQ: Tumia tokeni za quantization ya kuona (VQ) kama ingizo lenye masharti kwa ajili ya uzalishaji wa picha unaoweza kudhibitiwa.
Uhariri kwa picha ya marejeleo: Tumia picha iliyopakiwa kama marejeleo kwa uhamishaji wa mtindo, mabadiliko ya maudhui na shughuli nyingine za uhariri.
Uelekezaji wa haraka wa Turbo: Modeli iliyodistiliwa huhitaji sampuli 2–4 pekee ili kuzalisha picha za ubora wa juu za 1024×1024.
03Kanuni za kiufundi za LLaDA-Image
Fuatilia akaunti ya WeChat na ujibu “开源” ili kujiunga na kikundi cha mawasiliano cha miradi huria ya AI
Usanifu wa umoja wa difyusheni kamili: Modeli inaundwa na moduli ya uelewa LLaDA2.0-mini (modeli ya lugha ya difyusheni inayotegemea MoE) na moduli ya uzalishaji ya 6B DiT. Sehemu za nyuma za zote mbili ni modeli za difyusheni, na zinaunganishwa kupitia Connector, hivyo kutenganisha uelewa wa kisemantiki na uzalishaji wa pikseli.
Mkakati wa mafunzo wa hatua kwa hatua: Hutumia njia ya “jifunze kwanza kuchora, kisha jifunze kufuata maagizo”. Kwanza hufanya mafunzo ya awali ya picha tupu na mafunzo ya kati ili kujenga msingi thabiti wa uzalishaji wa kuona, kisha huongeza usimamizi wa lugha unaolingana ili kukamilisha uoanishaji wa maandishi na kuona.
Ujenzi wa data ya ubora wa juu: Mafunzo ya uzalishaji yalitumia takriban sampuli milioni 220, ambapo 98% ni picha halisi. Katika hatua ya uoanishaji wa lugha, maelezo ya picha na maandishi yalitengenezwa na kuthibitishwa na modeli kubwa za mfululizo wa Qwen, ili kuhakikisha usahihi wa kufuata maagizo.
Uboreshaji wa mafunzo kwa ufanisi: Msururu mzima hutumia RMSNorm isiyotegemea vigezo badala ya LayerNorm, pamoja na optimiza ya Muon, ili kuboresha uthabiti na ufanisi wa mafunzo ya kiwango kikubwa.
Udistilishaji wa haraka wa Twin-DMD: Toleo la Turbo hutumia teknolojia ya udistilishaji ya Twin-DMD kubana modeli ya Base. Sampuli 2–4 zinaweza kuzalisha picha za ubora wa juu za 1024×1024, zikisawazisha kasi na ubora.
04Jinsi ya kutumia LLaDA-Image
Usanidi wa mazingira: Sakinisha Python 3.11, PyTorch 2.8, Diffusers 0.39.0 na FlashAttention 2.8.3 pamoja na utegemezi mwingine, kisha unda mazingira ya uelekezaji ya ndani.
Upatikanaji wa uzani: Pakua faili za modeli za LLaDA-Image (toleo la uhalisia wa juu) au LLaDA-Image-Turbo (toleo la haraka) kutoka Hugging Face au ModelScope ya 魔搭.
Uzalishaji wa picha kutoka maandishi: Baada ya kupakia modeli, ingiza maelezo ya maandishi. Kwa toleo la Base, weka hatua 50 na guidance scale 5.0; kwa toleo la Turbo, weka hatua 2–4 na guidance scale 1.0 ili kuzalisha picha za 1024×1024.
Uhariri wa picha kwa maagizo: Pakia picha ya marejeleo na uweke maagizo ya uhariri ya lugha asilia (kama “badilisha mandharinyuma yawe ufukweni”). Modeli itaacha kiotomatiki maeneo ambayo hayajahaririwa bila mabadiliko.
Angalizo kuhusu vipimo: Vipimo vya ingizo kwa uzalishaji wa maandishi kuwa picha na uzalishaji wenye masharti ya VQ lazima viwe vizidisho vya 16; kazi za uhariri lazima ziwe vizidisho vya 32.
05Faida kuu za LLaDA-Image
Utendaji bora miongoni mwa modeli huria: Imeongoza miongoni mwa modeli huria katika mashindano yote mawili ya Kichina na Kiingereza ya Qwen-Image-Bench, na alama yake ya jumla imezidi modeli nyingine kuu huria kama FLUX.2 Max.
Uzalishaji na uhariri uliounganishwa: Modeli moja inasaidia kwa wakati mmoja uzalishaji wa maandishi kuwa picha wa ubora wa juu na uhariri wa picha kwa maagizo kwa usahihi, bila kuhitaji kubadilisha modeli.
Uelekezaji wa kasi ya juu: Toleo la Turbo lililodistiliwa huhitaji sampuli 2–4 pekee kuzalisha picha halisi za 1024×1024, hivyo kupunguza kwa kiasi kikubwa muda wa kusubiri.
Uonyeshaji wa maandishi ya Kichina na Kiingereza: Lina uwezo bora wa kuzalisha maandishi ya Kichina na Kiingereza, na linafaa kwa kazi za usanifu kama mabango, upangaji wa maandishi na maandishi ya kisanii.
Uhalisia wa kiwango cha picha: Kwa kutegemea data ya mafunzo ya awali yenye 98% ya picha halisi, matokeo yana mwangaza wa asili, maelezo mengi na uhalisia wa juu.
06Anwani za mradi wa LLaDA-Image
Hifadhi ya GitHub: https://github.com/inclusionAI/LLaDA-Image
Mkusanyiko wa modeli wa HuggingFace: https://huggingface.co/collections/inclusionAI/llada-image
Waraka wa kiufundi wa arXiv: https://arxiv.org/pdf/2609.03796
07Matukio ya matumizi ya LLaDA-Image
Usanifu wa picha za biashara ya mtandaoni: Tengeneza picha kuu za bidhaa kwa mbofyo mmoja kulingana na maelezo ya bidhaa, au badilisha mandharinyuma na kurekebisha mwangaza kwa maagizo ili kupunguza gharama za upigaji picha na uhariri wa baadae.
Utengenezaji wa mabango ya masoko: Tumia uwezo bora wa kuonyesha maandishi ya Kichina na Kiingereza ili kutengeneza moja kwa moja mabango ya kibiashara na picha za mitandao ya kijamii zenye kauli mbiu ya chapa na taarifa za tukio.
Uundaji wa maudhui ya mitandao ya kijamii: Wape wanablogu na waundaji uwezo wa kuzalisha picha halisi za watu, mandhari na mtindo wa maisha, pamoja na uhariri wa kimtindo na uzalishaji wa haraka.
Usanifu wa dhana za michezo na filamu: Tengeneza kwa haraka picha za dhana za wahusika na mandhari kutoka kwa maandishi, kisha rekebisha maelezo kwa maagizo ili kuharakisha mchakato wa ubunifu wa awali.
Uhariri wa picha binafsi: Pakia picha na utumie maagizo ya lugha asilia kuondoa vitu visivyohitajika, kubadilisha anga, kurekebisha rangi na kufanya shughuli nyingine, huku maeneo ambayo hayajabadilishwa yakibaki bila mabadiliko na hivyo kuchukua nafasi ya programu changamano za uhariri wa picha.
© Kanusho: vikoa na maudhui yaliyounganishwa vinaweza kubadilika kadiri muda unavyopita. AIEZZ haidhibiti tovuti za wahusika wengine. Kagua maudhui na hatari za nje kwa kujitegemea.
Ukaguzi wa watumiaji0