

DeepInfer-SM80 ni Nini?
DeepInfer-SM80 ni mkusanyiko wa moduli za Python, Triton na TileLang zilizoboreshwa kwa ajili ya kuendesha DeepSeek-V4.1 kwenye GPU za NVIDIA Ampere kupitia injini ya vLLM V1. Inahamisha mawazo ya msingi kutoka kwa DeepInfer ya DeepSeek, ambayo inalenga NVIDIA Blackwell, na kubuni upya njia muhimu ya utekelezaji kulingana na uwezo wa maunzi ya Ampere.
Badala ya kutegemea vipengele vinavyopatikana kwenye Blackwell pekee, kama vile maagizo ya warp-group tcgen05, Tensor Memory, maagizo ya maunzi ya kuongeza UE8M0, na KB 228 za shared memory kwa kila streaming multiprocessor, mradi huu hutumia Tensor Cores za Ampere za mma.sync.aligned.m16n8k16, upangaji unaozingatia SM, usimbuaji wa UE8M0 kwa integer bitshift, na utumiaji upya wa shared-KV wa YOCO.
Mradi huu unaauni GPU za kituo cha data za SM80 kama vile A100 na A800, pamoja na vifaa vya SM86 ikiwemo RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10 na A30. Kerneli zake hutumia si zaidi ya KB 48 za shared memory kwa kila CTA, hivyo zinaweza kufanya kazi ndani ya mipaka ya chini ya shared memory ya vifaa vya SM86.
Kwa Nini Uitumie?
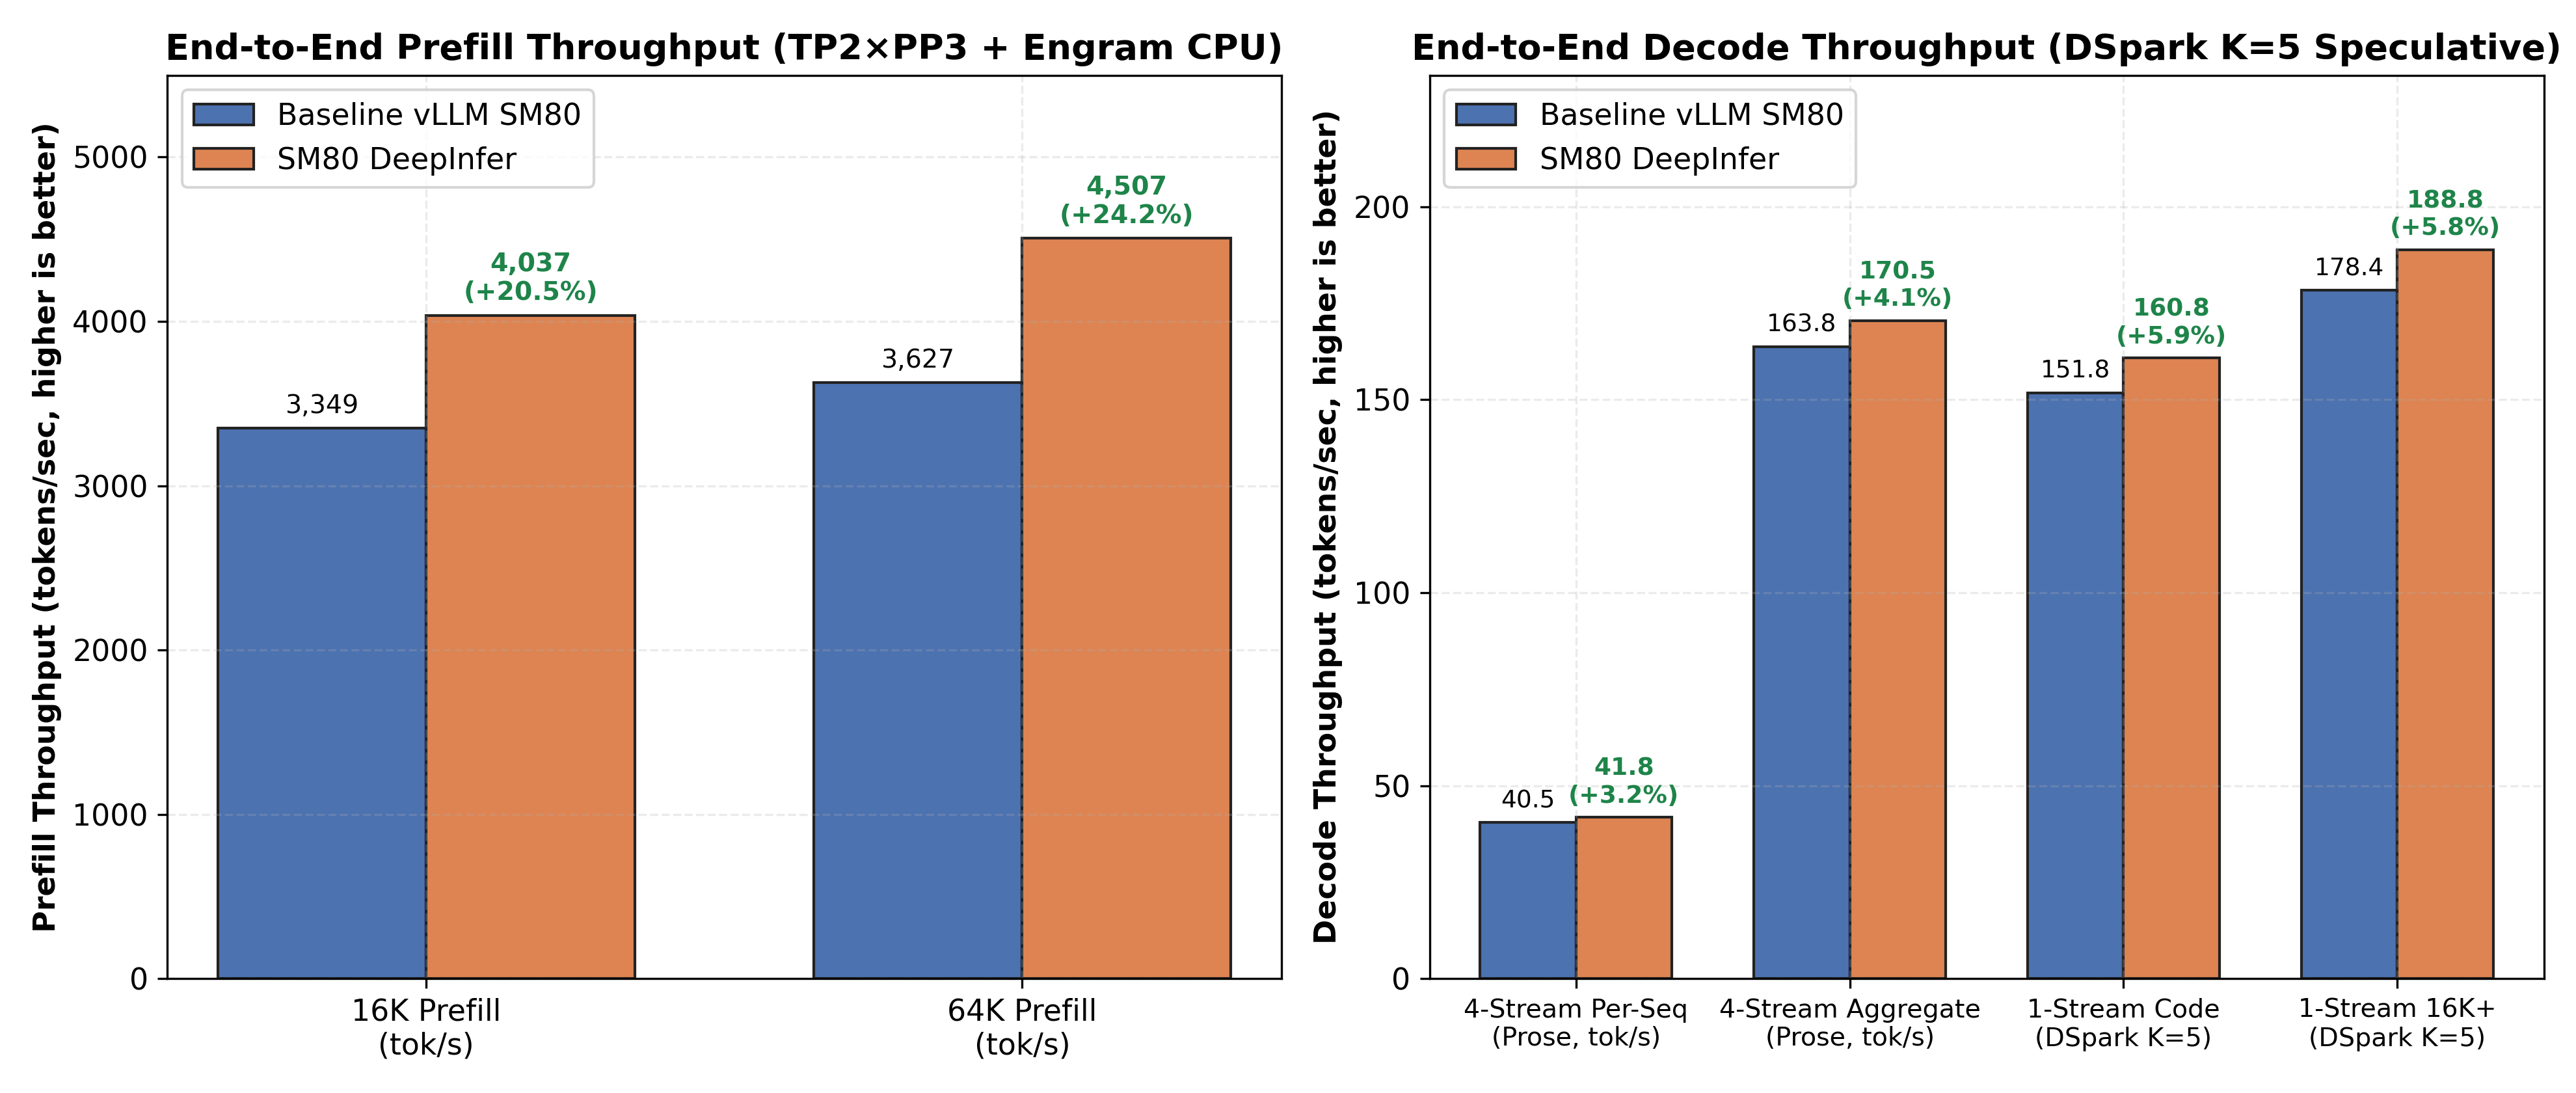
DeepInfer-SM80 inalenga shughuli zinazotumia rasilimali nyingi katika prefill ya DeepSeek-V4.1, sparse attention, ufikiaji wa KV-cache, uelekezaji wa mabaki, na inference yenye muktadha mrefu. Hazina hii inaripoti matokeo yafuatayo kutoka kwenye usanidi wa uzalishaji uliotumia GPU sita za GA100 zenye GB 64, TP2 × PP3, usimbuaji wa kubashiri wa DSpark wenye K=5, na urefu wa juu wa muktadha wa tokeni 1,048,576:
- Prefill baridi ya 16K: tokeni 4,037.0 kwa sekunde, kutoka tokeni 3,349.4 kwa sekunde.
- Prefill baridi ya 64K: tokeni 4,506.8 kwa sekunde, kutoka tokeni 3,627.3 kwa sekunde.
- Muda hadi tokeni ya kwanza kwa 64K: sekunde 10.7, kutoka sekunde 13.2.
- Usimbuaji wa kubashiri wa mitiririko minne: jumla ya tokeni 170.5 kwa sekunde, ikilinganishwa na tokeni 163.8 kwa sekunde.
- Usimbuaji wa mtiririko mmoja kwa msimbo wa Python: tokeni 160.8 kwa sekunde, ikilinganishwa na tokeni 151.8 kwa sekunde.
- Uwezo wa KV ulio kwenye GPU: tokeni 4,648,480, bila ongezeko la ziada la matumizi ya VRAM ikilinganishwa na msingi.
Vipimo hivi vinaeleza maunzi na usanidi wa utoaji huduma uliopimwa na hazina. Matokeo kwenye GPU nyingine za Ampere, usanidi wa modeli, mzigo wa kazi au mazingira mengine ya vLLM yanaweza kutofautiana.
Maboresho Muhimu
MLA Tenganishi Iliyounganishwa ya Vipimo 512
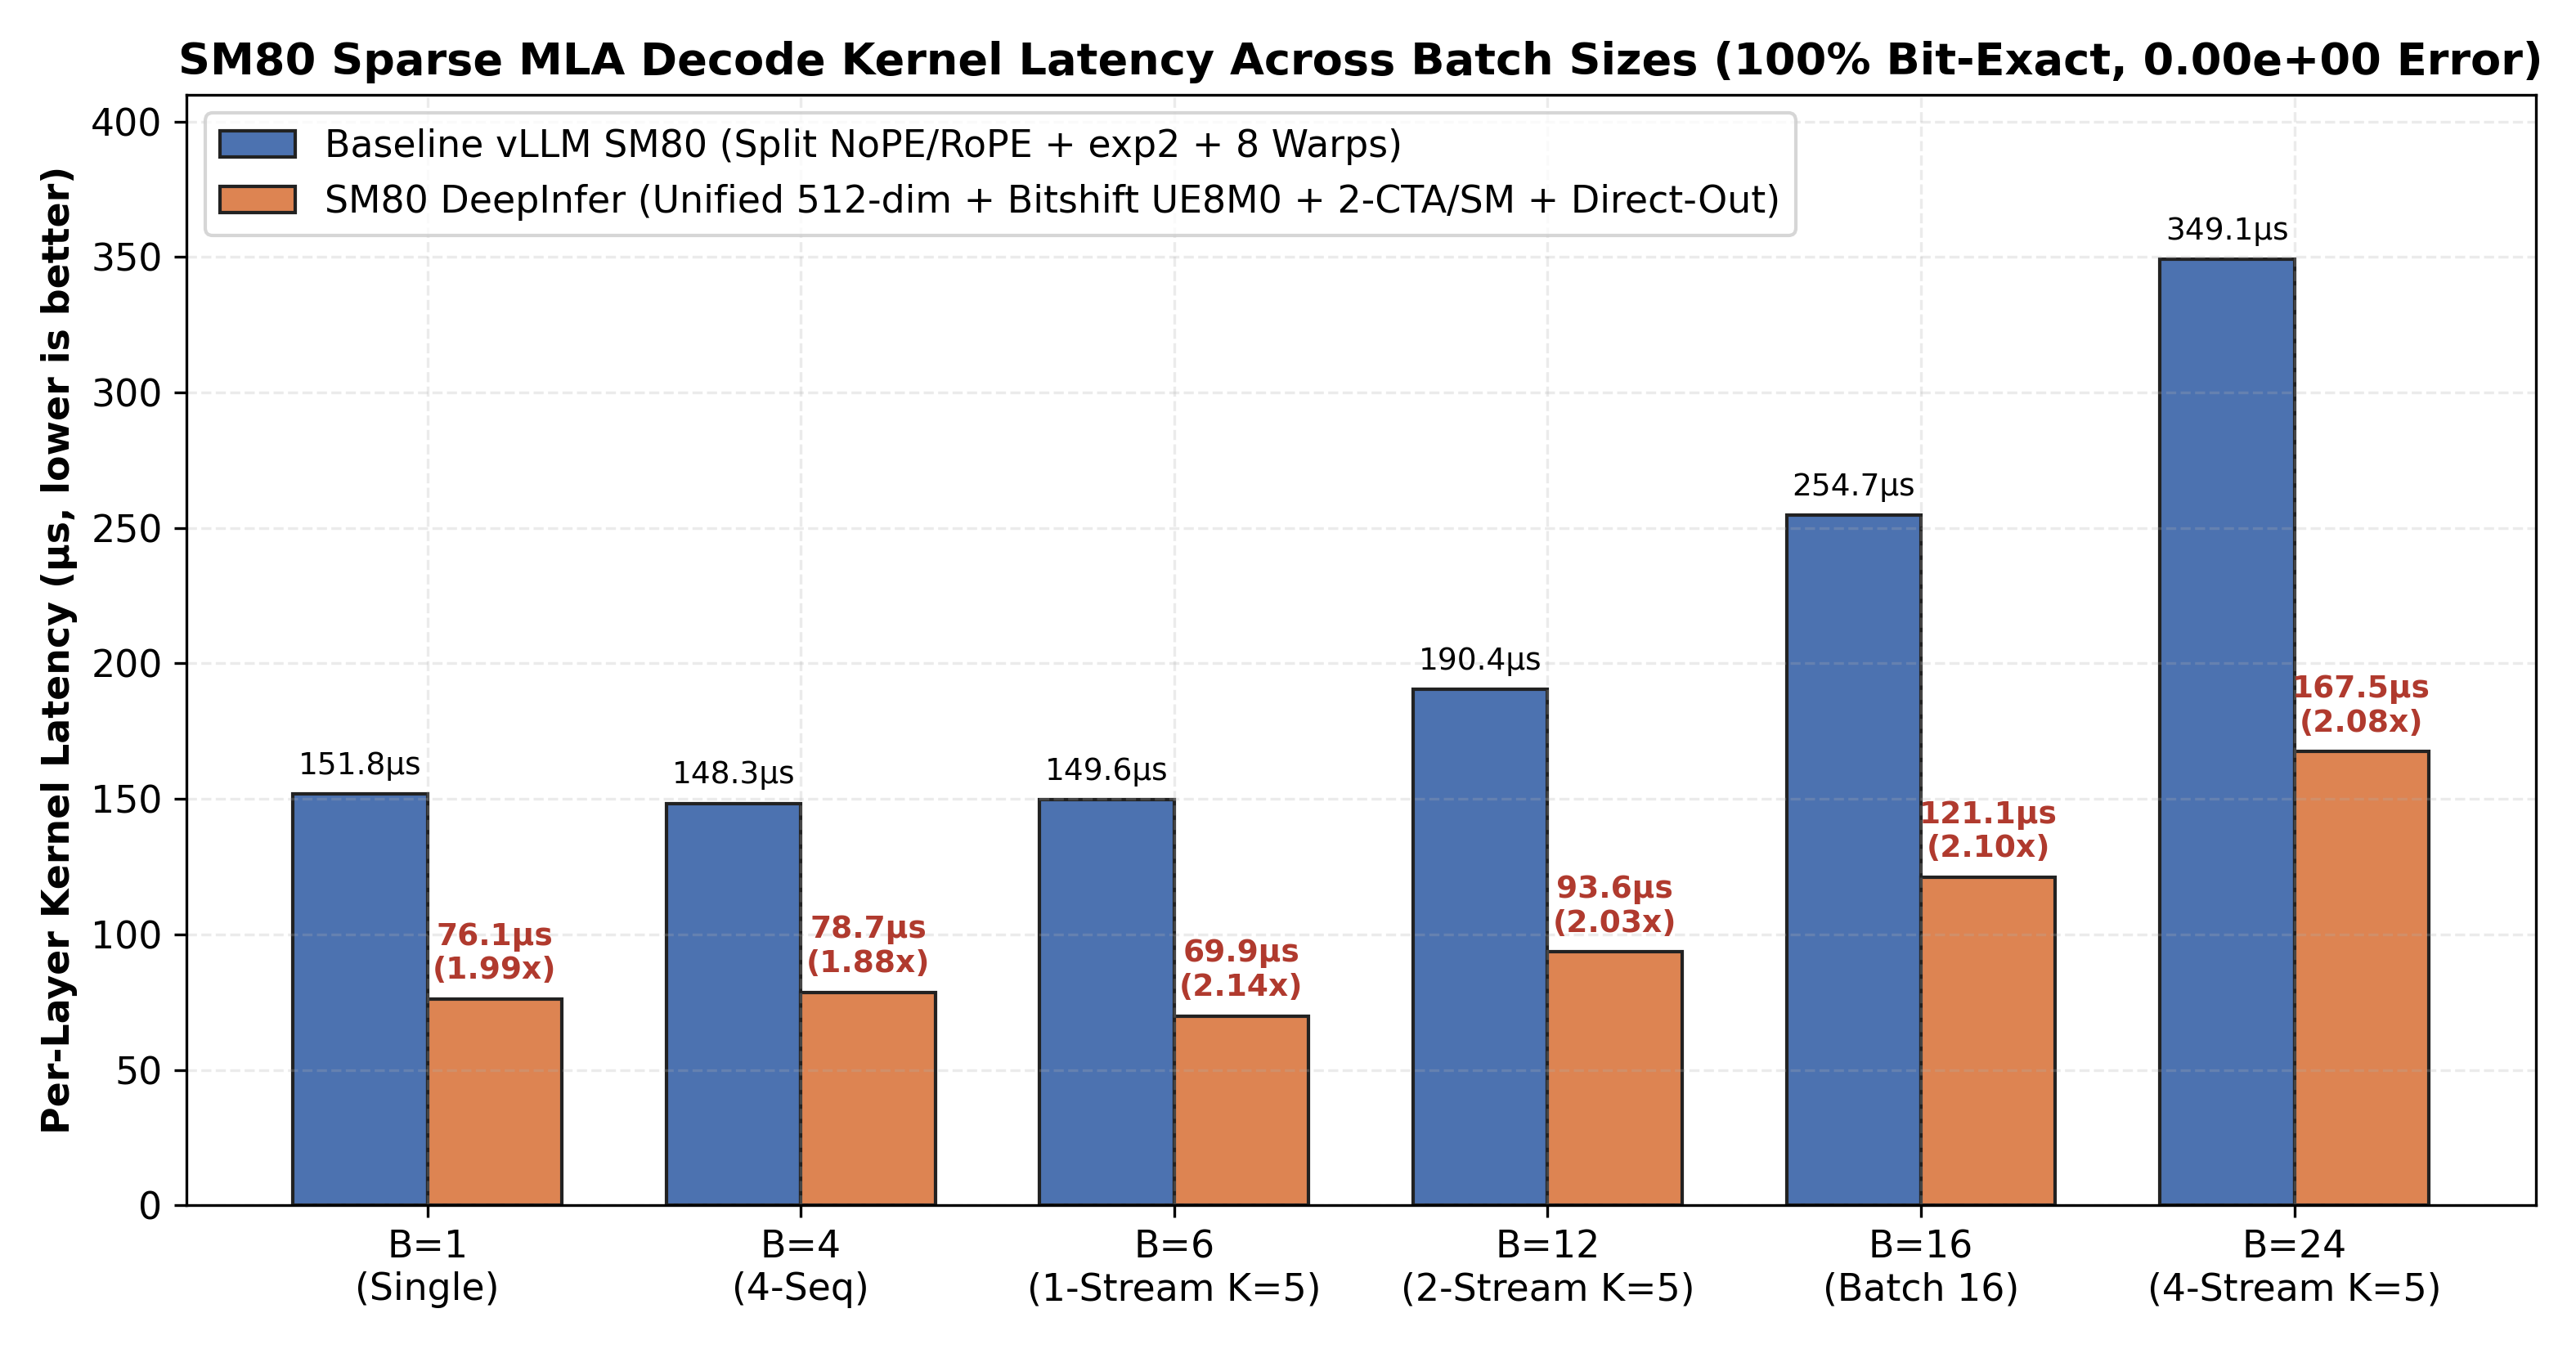
Uangalizi tenganishi wa DeepSelect wa DeepSeek-V4.1 huhifadhi latent ya NoPE yenye vipimo 448 katika float8_e4m3fn, kwa kutumia mizani ya vizuizi ya UE8M0 yenye nguvu za mbili, pamoja na kiambishi cha RoPE cha BF16 chenye vipimo 64. DeepInfer-SM80 hupakia kigae kamili chenye vipimo 512 na kukichakata kupitia njia moja ya bidhaa ya nukta ya Tensor Core badala ya kushughulikia sehemu za NoPE na RoPE kando.
Kernel hubadilisha ubadilishaji wa UE8M0 unaotegemea exp2 kwa bitshift ya integer ya IEEE-754:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)Kwa vielezi halali vya UE8M0, hii hutoa thamani za mizani za FP32 zinazofanana kabisa kwa kiwango cha biti, huku ikihamisha kazi kutoka kwa shughuli za transcendental hadi kwenye pipeline ya integer.
Usanidi ulioboreshwa hutumia BLOCK_N=64, num_warps=4 na num_stages=2. Kupunguza shinikizo la rejista huruhusu CTAs mbili kukaa kwenye kila streaming multiprocessor ya SM80. Wakati num_kv_splits == 1, kernel huandika moja kwa moja kwenye towe la mwisho na huepuka kuanzisha hatua tofauti ya kupunguza.
Mchanganyiko wa Top-K na Fahirisi za SWA kwa CTA Moja
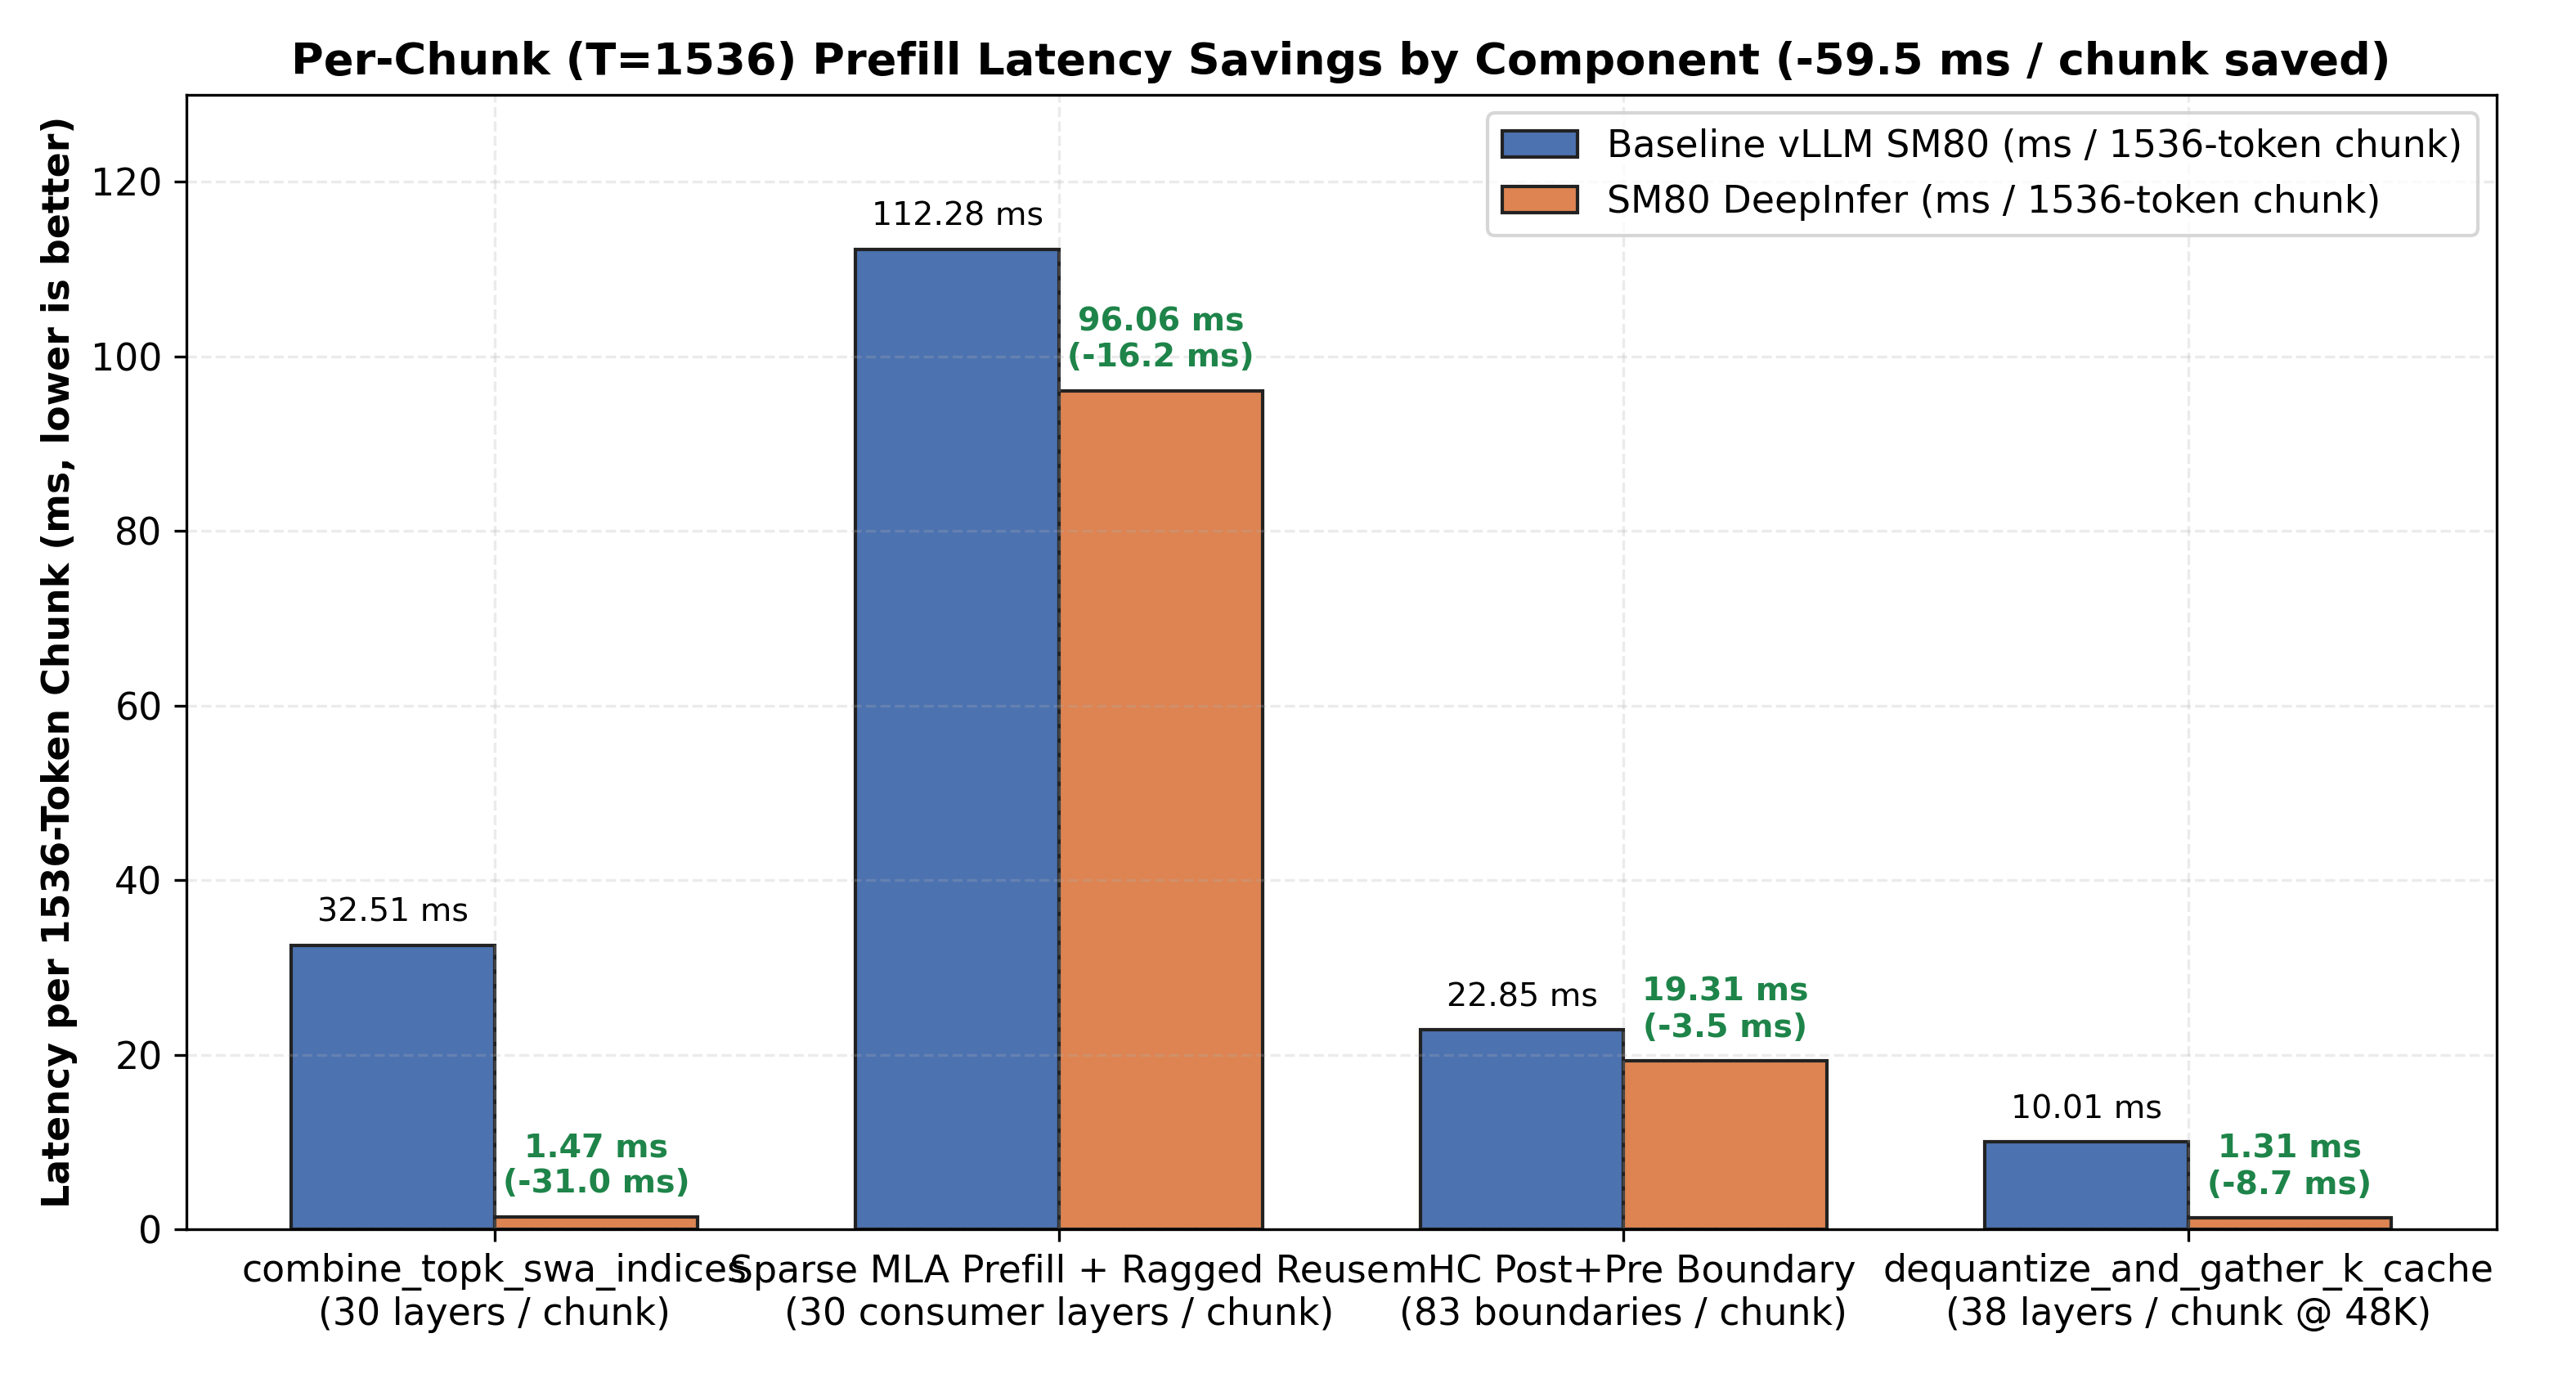
_combine_topk_swa_indices_kernel iliyoboreshwa hubadilisha mfululizo wa ugawaji na shughuli za PyTorch kwa kernel moja ya Triton inayotumia CTA moja kwa kila tokeni ya hoja. Katika T=1536, muda uliopimwa wa kusubiri hupungua kutoka mikrosekunde 1,083.72 hadi mikrosekunde 48.88, ikiwa ni ongezeko la kasi la 22.17×.
Ili kuepuka migongano ya uandishi kati ya warps, kila safu ya towe hugawanywa katika maeneo matatu yasiyopishana:
- Fahirisi zilizobanwa za Top-K huchukua
[0, topk_len). - Fahirisi za uangalizi wa dirisha linaloteleza huchukua
[topk_len, topk_len + swa_len). - Safu wima zilizosalia hujazwa
-1.
README inaripoti towe linalolingana kabisa kwa kiwango cha biti katika urefu wote wa mfuatano uliopimwa na uwiano wa mbano wa 0, 1 na 2.
Uondoshaji wa Quantization na Ukusanyaji wa KV-Cache kwa Kasi Zaidi
Njia ya dequantize_and_gather_k_cache hutumia ubadilishaji huo huo wa UE8M0 unaotegemea bitshift. Pia huandika kwa kutumia strides za lengwa zinazotolewa kwa kernel ya Triton, na hivyo kuondoa ugawaji wa kati wa torch.empty pamoja na shughuli zinazofuata za .copy_().
Ongezeko la kasi lililopimwa ni 4.02× katika muktadha wa 16K na 7.64× katika muktadha wa 48K, huku marejeo yakilingana kabisa kwa kiwango cha biti katika majaribio yaliyoripotiwa.
Uelekezaji wa Mabaki wa mHC Ulioboreshwa kwa SM80
DeepSeek-V4.1 hufanya uelekezaji wa hyper-connection wenye vikwazo vya manifold wa mitiririko minne katika mipaka 83 kwa kila upitishaji wa mbele. DeepInfer-SM80 huongeza jiometri iliyopangiliwa ya mgawanyo wa (6, 8, 128) kwa ukubwa wa ndani wa modeli wa 5,120. Kila moja ya vipande vinane ina vipengele 640, ambavyo vinagawanyika kwa 128.
Mradi pia hupunguza kizingiti cha matrisi ndogo kutoka 32 hadi 16, ili idadi ya tokeni ya angalau 16 iweze kutumia njia ya Tensor Core T.gemm. Ongezeko la kasi lililoripotiwa la mhc_fused_post_pre_delayed ni 2.89× katika T=12 na 1.30× katika T=6.
Utumiaji Upya wa Metadata ya YOCO
Katika usanifu wa DeepSeek-V4.1 wa You-Only-Cache-Once, tabaka 21 hadi 39 husoma kutoka akiba kamili ya KV ya tabaka la 20. Watumiaji hawa hushiriki urefu uleule uliopanuliwa wa mfuatano, jedwali la vizuizi, na uwiano wa mbano.
DeepInfer-SM80 huhifadhi metadata ya K iliyopangwa bila mpangilio katika muktadha wa forward wa vLLM inapochakata tabaka la 20. Kutumia tena data hiyo kwa tabaka 21 hadi 39 huondoa minyororo 19 isiyo ya lazima ya kernel za GPU za kujenga metadata kwa kila sehemu ya prefill.
Kabla ya Usakinishaji
Unahitaji mazingira ya vLLM V1 yatakayoendesha DeepSeek-V4.1 kwenye GPU ya NVIDIA Ampere inayotumika. Hifadhi hii inatoa kiraka kilichounganishwa na moduli sita mbadala, lakini README haitaji nambari mahususi za matoleo ya CUDA, Python, Triton, TileLang au vLLM. Tumia checkout ya vLLM inayooana na kiraka hicho na uwekaji wako uliopo wa DeepSeek-V4.1.
Makundi ya maunzi yanayotumika ni:
- GPU za SM80 za vituo vya data: A100 40 GB, A100 80 GB, GA100 64 GB, na A800 40 GB au 80 GB.
- GPU za SM86 za vituo vya kazi na watumiaji: RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10, na A30.
Programu hii inasambazwa chini ya Apache License 2.0.
Chaguo A la Usakinishaji: Tumia Kiraka Kilichounganishwa
Njia hii hutumia faili zote sita zilizobadilishwa kwenye checkout ya chanzo ya vLLM. Fungua kituo cha amri katika saraka kuu ya checkout hiyo na utekeleze:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patchBadilisha /path/to/Deepinfer-SM80 kwa eneo la mradi uliouclone au kuupakua. Kiraka hiki kina mabadiliko ya MLA iliyopunguzwa, ukusanyaji wa akiba, Top-K pamoja na SWA, mHC, warmup, na utumiaji tena wa metadata ya YOCO.
Chaguo B la Usakinishaji: Sakinisha Moduli za Drop-In
Ikiwa kubadilisha faili moja kwa moja kunafaa zaidi kwa mazingira yako, nakili mti wa moduli za vLLM wa mradi juu ya kifurushi cha vLLM kilichosakinishwa:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm/Badilisha /path/to/site-packages/vllm/ kwa saraka halisi ya kifurushi cha vLLM. Faili hizohizo zinaweza pia kuwekwa kama overlays za bind za kusomeka tu katika uwekaji wa Docker.
Mti wa drop-in hubadilisha maeneo haya ya utendaji:
model_executor/kernels/mhc/kwa utekelezaji wa mHC wa TileLang na warmup.models/deepseek_v4_1/amd/rocm.pykwa kiunganisha cha Triton Top-K na SWA.models/deepseek_v4_1/common/ops/cache_utils.pykwa ukusanyaji wa akiba ya KV.models/deepseek_v4_1/nvidia/model.pykwa utumiaji tena wa metadata ya YOCO.v1/attention/ops/rocm_aiter_mla_sparse.pykwa kernel za MLA iliyopunguzwa zilizounganishwa.
Ingawa faili mbili zilizoboreshwa bado zina
rocmauamdkatika njia zake, hifadhi hii inazitumia waziwazi kama sehemu ya muunganisho wa vLLM unaolenga Ampere. Hifadhi muundo wa saraka uliotolewa unapotumia faili za drop-in.
Matumizi ya Msingi: Thibitisha Kernel
Baada ya kusakinisha kiraka au moduli za drop-in, endesha vipimo vidogo vilivyotolewa kwenye GPU ya Ampere inayolengwa, kama A100, A800, RTX 3090, RTX A6000 au nyingine inayotumika:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
Faili za vipimo zinahusu kernel za MLA iliyopunguzwa na ukusanyaji wa KV, kernel za mHC za TileLang, na kiunganisha cha Top-K pamoja na SWA. Kusudi lake ni kupima ucheleweshaji wa kernel za eneo hilo na kuthibitisha matokeo yaliyoboreshwa dhidi ya marejeo ya msingi.
Tengeneza chati za vipimo za hifadhi hii kwa:
python3 benchmarks/generate_charts.pySeti kamili ya data ya vipimo inapatikana pia katika benchmarks/results/sm80_benchmark_summary.json.
Kuelewa Uthibitishaji wa Kihisabati
Njia kadhaa zilizoboreshwa zimeripotiwa kuwa sahihi kabisa kwa kiwango cha biti:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
Njia nyingine za Tensor Core zinaweza kutofautiana kidogo kwa sababu mlundikano wa BF16 au mpangilio wa utekelezaji wa MMA hubadilika. Tofauti za juu zilizoripotiwa ziko chini ya 1.9e-3 kwa usanidi wa mHC uliounganishwa uliopimwa na chini ya 4.8e-3 kwa usanidi wa prefill wa umakini uliopunguzwa uliopimwa.
Matokeo ya logprob hasi ya prompt yalibaki ndani ya kiwango cha kelele kilichoripotiwa kati ya uendeshaji na mwingine. Unapotathmini uwekaji, kagua utendaji na matokeo ya kihisabati badala ya kudhani kwamba kila opereta iliyoboreshwa lazima iwe sawa kabisa kwa kiwango cha biti.
Vidokezo vya Uwekaji wa Kina
Tumia TP2 × PP3 kwa Muundo wa Uzalishaji wa GPU Sita Uliojaribiwa
Kwa GPU sita za Ampere zenye 64 GB au 80 GB, hifadhi hii inapendekeza TP2 × PP3 yenye mgawanyo wa tabaka wa 14,14,12. Katika usanidi uliojaribiwa, mpangilio huu ulitoa tokeni 160.8 hadi 188.8 kwa sekunde kwa mzigo uliochaguliwa wa mkondo mmoja wa msimbo na uundaji mrefu, tokeni 4,506.8 kwa sekunde kwa prefill baridi ya 64K, na uwezo wa takriban tokeni za KV milioni 4.65 zilizo kwenye GPU.
Uwezo huu unalingana na takriban miktadha 4.43 ya tokeni milioni moja chini ya usanidi wa kipimo.
Elewa Mibadala
- PP6: hutoa uwezo wa takriban tokeni milioni 4.5 hadi 4.7, lakini README inaripoti decode ya mkondo mmoja yenye kasi ndogo zaidi kwa kiasi kikubwa kwa sababu parallelism ya tensor ni moja na maombi hupitia hatua sita za pipeline.
- TP2 pamoja na TP4 isiyolingana: huongeza uwezo unaokadiriwa hadi takriban tokeni milioni sita, lakini kugawanya ukubwa wa kati wa MoE wa 2,304 katika sehemu za TP4 zenye upana wa 576 hupunguza ufanisi wa vigae vya Marlin.
Angalia docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md kwenye hazina kabla ya kuchagua topolojia kwa uwekaji wa tokeni milioni moja.
Pima Mzigo Halisi wa Kazi
Maboresho makubwa zaidi hutokana na waendeshaji wanaoitwa mara kwa mara, lakini uboreshaji wa mwisho hadi mwisho hutegemea urefu wa prompt, ulinganifu wa maombi, decoding ya kubashiri, topolojia, na modeli ya GPU. Endesha kwanza vipimo vilivyotengwa, kisha linganisha mzigo kamili wa huduma ukitumia prompt, ukubwa wa muktadha, na viwango vya ulinganifu vinavyolingana na programu yako ya uzalishaji.
Dumisha Njia ya Haraka ya Matokeo ya Moja kwa Moja
Uboreshaji wa sparse MLA decode huruka uzinduzi wa pili wa reduction wakati num_kv_splits == 1. Ukibadilisha upangaji wa attention au tabia ya split, pima tena kernel kwa sababu njia ya matokeo ya moja kwa moja ni sehemu muhimu ya uboreshaji wa decode ulioripotiwa.
Weka Metadata ya YOCO Kwenye Muktadha wa Forward
Akiba ya metadata ya layer 20 ni muhimu kwa sababu watumiaji wote wa layer 21–39 hushiriki chanzo chake cha KV. Mabadiliko kwenye utekelezaji wa modeli au ushughulikiaji wa muktadha wa forward yanapaswa kuhifadhi utumiaji huu tena; vinginevyo, injini inaweza kujenga upya metadata ileile ya ragged kwa kila layer ya mtumiaji.
Hitimisho
DeepInfer-SM80 hutoa njia mahususi ya kuharakisha DeepSeek-V4.1 kwenye NVIDIA Ampere bila kuongeza matumizi ya VRAM ya akiba ya KV. Maboresho yake yanachanganya attention sparse inayozingatia Ampere, decoding ya bitshift UE8M0, matokeo ya moja kwa moja ya akiba ya KV, kichanganyaji cha Top-K na SWA kisicho na mashindano ya data, uelekezaji wa mHC uliopangiliwa, na utumiaji tena wa metadata ya YOCO.
Anza kwa kutumia patch iliyounganishwa au kusakinisha moduli sita za drop-in. Endesha seti zote tatu za vipimo vidogo ili kuthibitisha muda wa kusubiri na tabia ya nambari kwenye maunzi yako, kisha tathmini mazingira yaliyoboreshwa ya vLLM kwa mzigo wako halisi wa huduma. Kwa uwekaji wa GPU sita wenye muktadha wa tokeni milioni moja, tumia usanidi wa TP2 × PP3 uliojaribiwa na hazina kama sehemu kuu ya marejeo.