

NamiGPT ni nini
NamiGPT ni mafunzo ya msingi kuhusu mifano mikubwa ya lugha yaliyoundwa kwa ajili ya wanaoanza kujifunza kwa Kichina. Inatumia PyTorch kutekeleza GPT-2 kuanzia mwanzo, bila kutumia moduli zilizotengenezwa tayari za Transformer, na inaweza kupakia uzito rasmi wa awali wa OpenAI kwa ajili ya kufanya inferensi na kutengeneza maandishi.
Mradi huu hauweki ufanisi wa mafunzo kuwa lengo kuu, bali unasisitiza uelewa: modeli kuu iko katika gpt2/model.py, ikiwa na mistari isiyozidi 200; mafunzo yanatumia mfano wa maneno matatu “猫吃鱼” kama mwongozo wa kuvunja hatua kwa hatua tokenization, vekta, matriki za attention na mchakato wa mwisho wa utengenezaji.
Jina NamiGPT linatoa heshima kwa nanoGPT ya Karpathy. Linaelekeza zaidi kwenye ufundishaji wa wanaoanza bila msingi wa Kichina, likieleza kila hatua ya GPT-2 kupitia mifano midogo.
Utajifunza nini
- Jinsi Tokenizer hubadilisha maandishi kuwa vitambulisho vya token.
- Jinsi Embedding na usimbaji wa nafasi huunda ingizo la modeli.
- Jinsi Self-Attention na Multi-Head Attention huhesabiwa.
- Majukumu ya muunganisho wa mabaki, LayerNorm, FFN na kazi za uamilisho.
- Jinsi Transformer Block nyingi huunganishwa kuunda GPT-2.
- Jinsi ya kupakia uzito rasmi wa OpenAI kwenye modeli iliyoandikwa kwa mkono.
- Jinsi ya kutumia mikakati ya greedy, temperature na top-k kutengeneza maandishi.
- Jinsi ya kuthibitisha kupitia majaribio kwamba utekelezaji wa mkono unaendana na utekelezaji wa HuggingFace.
Sifa kuu za mradi
Utekelezaji wa vipengele vya msingi kuanzia mwanzo
NamiGPT haitumii moja kwa moja moduli zilizotengenezwa tayari za Transformer. Kiini cha modeli kina vipengele vya LayerNorm, Attention, FFN, Block na GPT, hivyo kinafaa kusomwa mstari kwa mstari ili kuelewa jinsi data na tensor zinavyopita.
Scripti za sura zinaweza kuendeshwa kwa kujitegemea
Sehemu ya inferensi ina mada 15 zinazopanda hatua kwa hatua, zikiwemo tokenizer, Embedding, usimbaji wa nafasi, self-attention, multi-head attention, muunganisho wa mabaki, normalization ya tabaka, mtandao wa mbele, kazi za uamilisho, Transformer Block, uunganishaji wa tabaka, upakiaji wa uzito, utengenezaji wa maandishi na ufasiri. Kila mada ya mafunzo ina scripti yake inayoweza kuendeshwa.
Inatoa taswira shirikishi
Mradi unatoa taswira inayohuishwa ya usanifu wa Transformer na taswira kamili ya matriki ya inferensi. Wakati msimbo au fomula ni ngumu kuelewa, unaweza kuona jinsi vipengele vya matriki katika mfano wa “猫吃鱼” vinavyohesabiwa kimoja baada ya kingine.
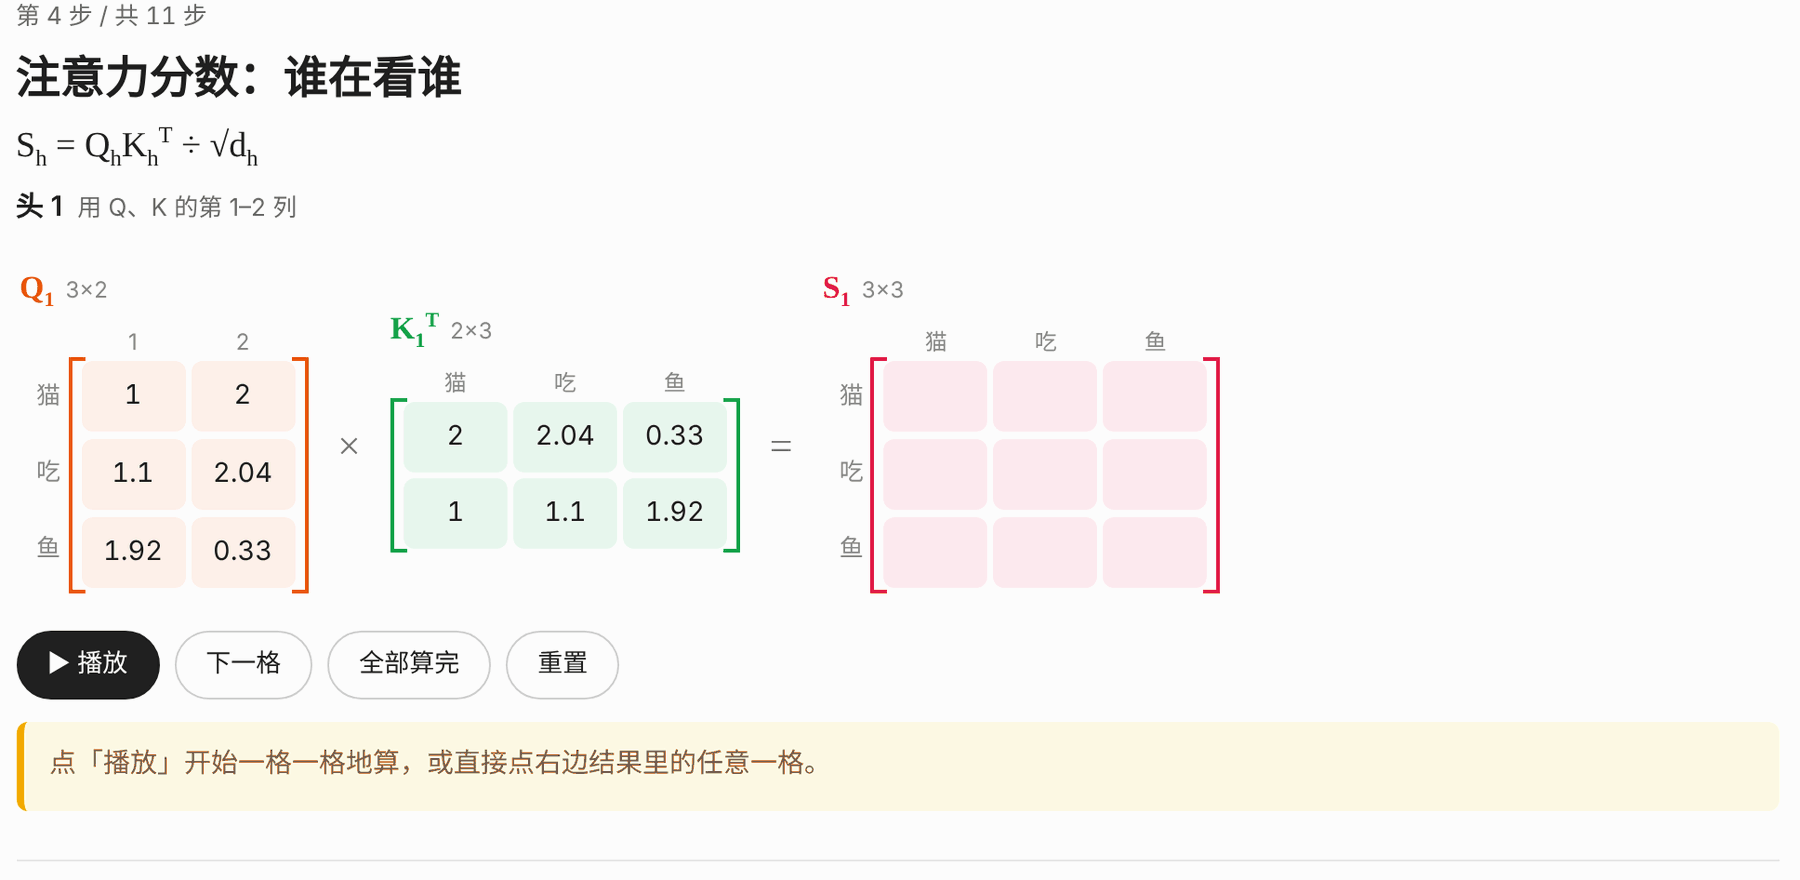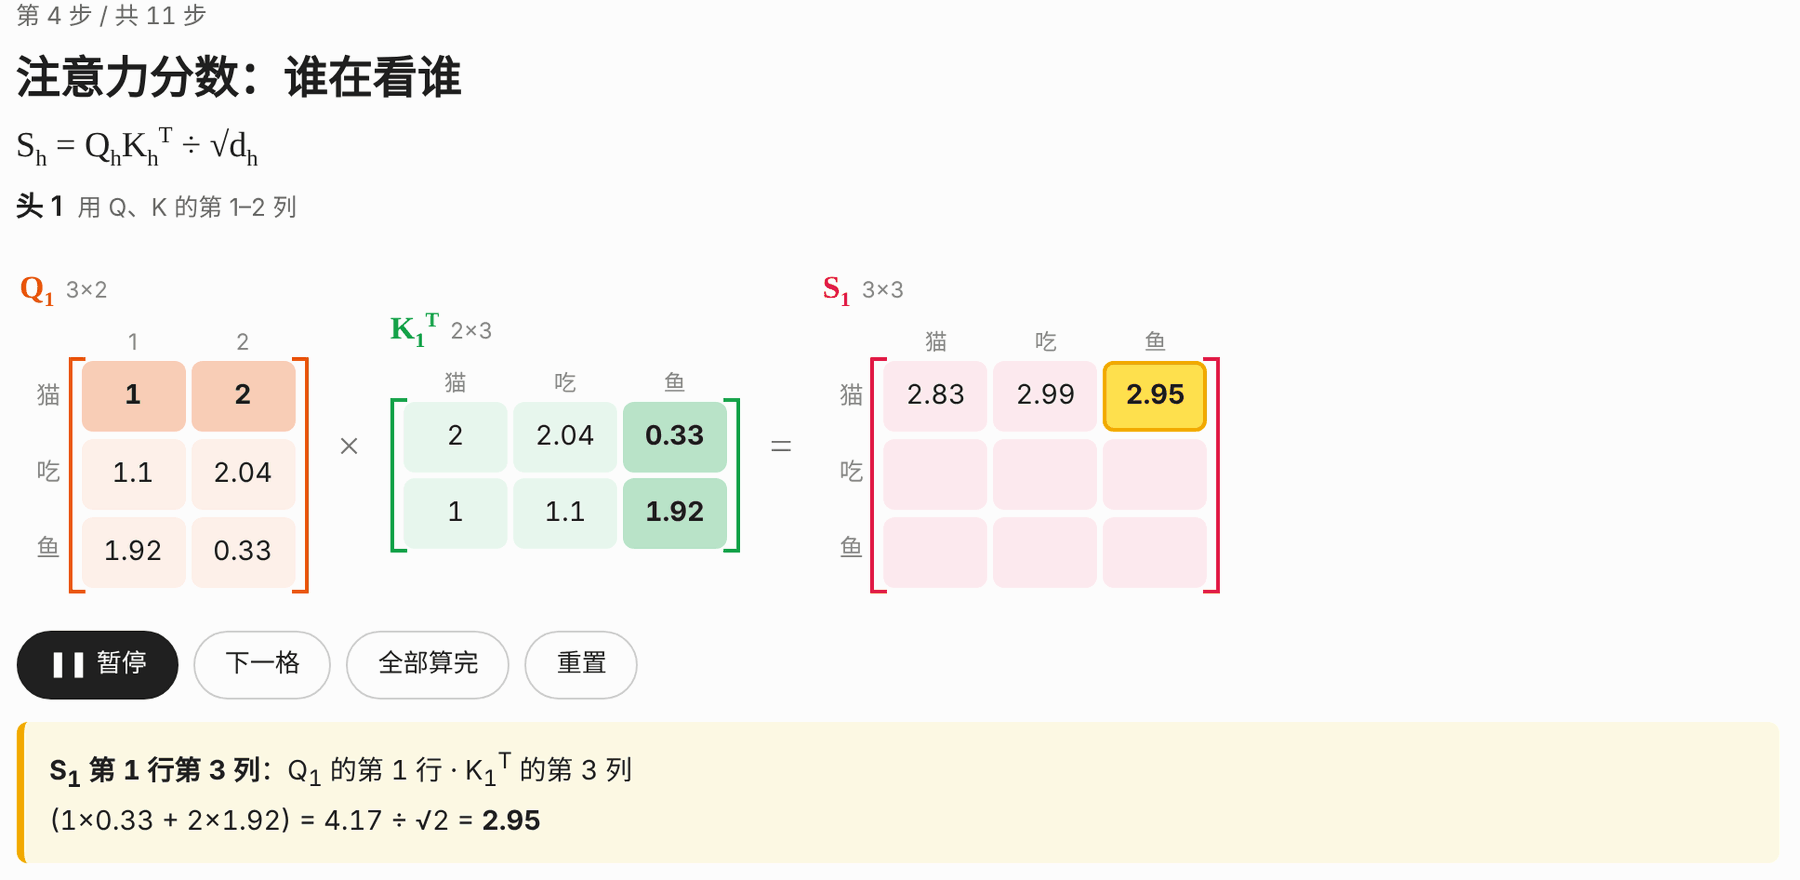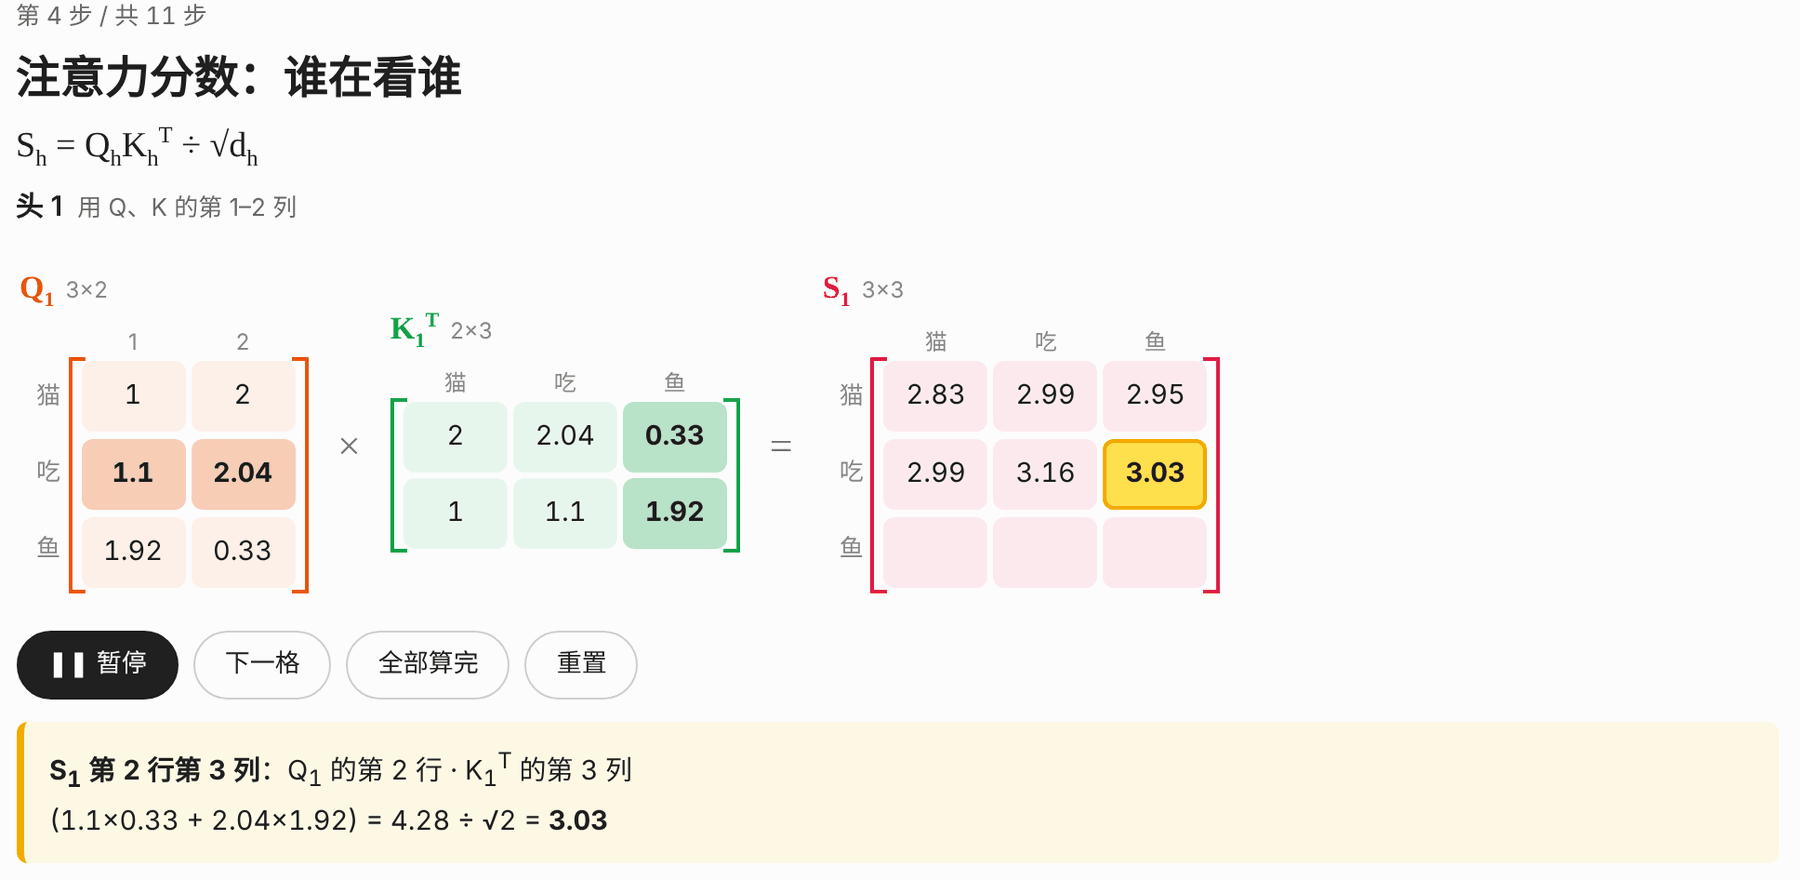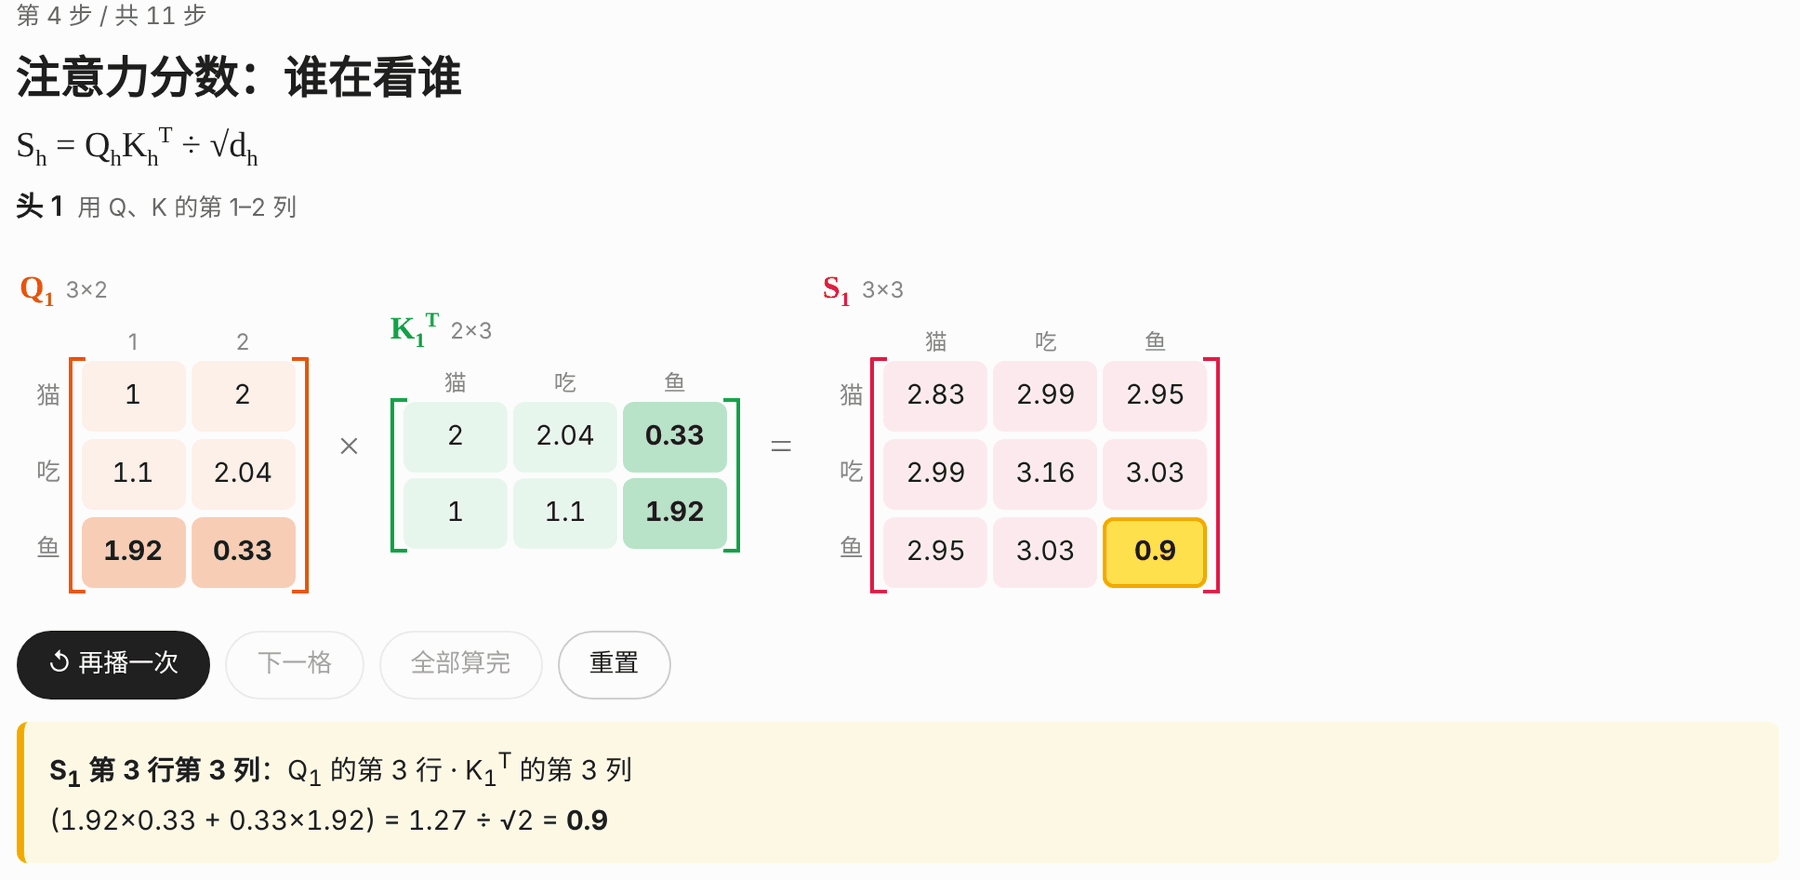
Inapendekezwa kwanza uangalieTransformer kwa picha moja, kisha utumietaswira ya inferensi ya modeli kubwa kulinganisha na msimbo wa sura.
Ulinganifu na matokeo ya HuggingFace
Hifadhi ina ukaguzi wa maumbo pamoja na majaribio ya kulinganisha na utekelezaji rasmi wa HuggingFace. Mbali na ulinganisho wa haraka kwa kutumia uzito wa nasibu, unaweza pia kupakua uzito halisi wa GPT-2 kwa uthibitishaji wa ziada.
Maandalizi kabla ya usakinishaji
Kabla ya kuanza, unahitaji uwezo wa msingi wa kusoma Python na kuelewa dhana za msingi za aljebra ya mstari kama kuzidisha matriki. Mazingira yaliyotajwa ya uendeshaji wa mradi ni Python 3.9 au zaidi na PyTorch 2.x.
Kwanza kloni hifadhi, ingia kwenye saraka ya mradi na usakinishe vitegemezi:
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
Iwapo mtandao umewekewa vikwazo wakati wa kupakua uzito rasmi kutoka HuggingFace, unaweza kuweka anwani ya kioo katika terminal ya sasa:
export HF_ENDPOINT=https://hf-mirror.comKioo hiki kinatumika tu kupakua uzito rasmi. Baadaye unapoitumia from_pretrained, muundo wa modeli bado unatoka kwenye utekelezaji ulioandikwa kwa mkono wa NamiGPT.
Hatua ya kwanza: kuelewa GPT-2 kwa kufuata sura
Njia inayofaa zaidi kwa wanaoanza si kusoma modeli kamili mara moja, bali kujifunza sura baada ya sura kulingana na mtiririko wa data wa inferensi:
- Hatua ya ingizo: Kwanza elewa Tokenizer, Embedding na usimbaji wa nafasi.
- Hatua ya attention: Elewa Self-Attention, kisha panua uelewa hadi Multi-Head Attention.
- Hatua ya moduli: Jifunze muunganisho wa mabaki, LayerNorm, FFN na kazi za uamilisho.
- Hatua ya modeli: Unganisha vipengele kuwa Transformer Block, kisha virundike kuwa GPT-2 kamili.
- Hatua ya matumizi: Pakia uzito rasmi, tengeneza maandishi na uangalie matokeo ya ufasiri.
Kila scripti inaweza kuendeshwa kivyake. Kwa mfano, endesha sura ya multi-head attention:
python chapters/01-inference/ep06_multi_head_attention.pyMaudhui kamili yenye picha na maandishi yanaweza kutazamwa katikamafunzo ya picha na maandishi ya NamiGPT, huku rasimu ya awali katika hifadhi ikiwa kwenye docs/01-inference/.
Hatua ya pili: kupakia GPT-2 na kutengeneza maandishi
Baada ya usakinishaji kukamilika, unaweza kuagiza moja kwa moja kiolesura cha kupakia modeli na kutengeneza maandishi kinachotolewa na NamiGPT. Mfano ufuatao unatumia tokenizer ya GPT-2, ukisimba kidokezo cha Kiingereza kuwa vitambulisho vya token, kisha kupakia modeli iliyoandikwa kwa mkono pamoja na uzito rasmi wa 124M:
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
Mtiririko wa utekelezaji wa msimbo
tiktoken.get_encoding("gpt2")hupata encoder inayotumiwa na GPT-2.enc.encode(...)hubadilisha maandishi ya kidokezo kuwa vitambulisho vya token.torch.tensorhufunga vitambulisho kuwa tensor ya kundi inayohitajika na modeli.from_pretrained("gpt2")huunda GPT-2 iliyoandikwa kwa mkono na kupakia uzito rasmi wa 124M.generatehutengeneza hadi token 30 mpya baada ya maandishi ya kidokezo.enc.decodehubadilisha vitambulisho vya token za matokeo kuwa maandishi.
Angalizo: GPT-2 haijafanyiwa urekebishaji wa mazungumzo; ina uwezo mkubwa wa kuendelea kuandika kulingana na maudhui yaliyopo, si kujibu maswali kama modeli ya mazungumzo. Data yake ya mafunzo kwa kiasi kikubwa ni ya Kiingereza, hivyo inapendekezwa kuanza kwa kutumia vidokezo vya Kiingereza.
Hatua ya tatu: kuelewa vigezo vya utengenezaji
Mfano umetumia vigezo viwili muhimu vya usampulishaji:
temperature=0.8: Hutumika kurekebisha mgawanyo wa uwezekano wa token zinazoweza kuchaguliwa. Moduli ya utengenezaji ya mradi inaunga mkono mkakati wa temperature.top_k=50: Huchagua tu kutoka kwa token 50 za mwanzo zenye uwezekano mkubwa. Mradi pia unaunga mkono utengenezaji wa greedy na top-k.
Wakati wa kujifunza, unaweza kuweka maandishi ya kidokezo bila kubadilika, ukarekebisha tu temperature au top-k, kisha kulinganisha matokeo ya mwendelezo. Hii hukuwezesha kuona moja kwa moja jinsi mkakati wa utengenezaji unavyoathiri matokeo, lakini vigezo maalum vinapaswa kuchaguliwa kulingana na lengo la jaribio lako.
Hatua ya nne: kuanzisha onyesho la wavuti la Gradio
Iwapo ungependa kuingiza kidokezo kwenye kivinjari na kuona matokeo ya mwendelezo pamoja na uwezekano wa maneno mbadala katika kila hatua, unaweza kusakinisha Gradio na kuanzisha programu ya onyesho iliyoko kwenye hifadhi:
pip install gradio
python demo/app.py
Onyesho la wavuti linafaa kwa kuchunguza utabiri wa modeli katika kila hatua, huku scripti za sura zikifaa zaidi kuchunguza mchakato wa hesabu wa kipengele kimoja. Kuzitumia pamoja kunakuruhusu kuhusisha maandishi ya mwisho na mabadiliko ya uwezekano wa ndani.
Hatua ya tano: kuendesha majaribio
Inapendekezwa kuendesha majaribio baada ya kurekebisha attention, upakiaji wa uzito au mantiki ya utengenezaji. Kwa chaguo-msingi, majaribio hutumia uzito wa nasibu kwa ulinganisho, hayahitaji kupakua modeli iliyofunzwa awali na kwa kawaida hukamilika haraka:
pytest tests/ -vIwapo pia ungependa kutumia uzito halisi wa GPT-2 kwa ulinganisho wa ziada, endesha:
TEST_PRETRAINED=1 pytest tests/ -vAmri ya pili itapakua uzito halisi wa ziada, hivyo wakati wa kwanza wa kuendesha utahitaji kusubiri upakuaji ukamilike.
Muhtasari wa muundo wa hifadhi
gpt2/config.py: Usanidi wa modeli, unaojumuisha ukubwa wa 124M, 355M, 774M na 1.5B.gpt2/model.py: LayerNorm, Attention, FFN, Block na kiini cha modeli ya GPT.gpt2/load_weights.py: Kupakia uzito rasmi kwenye modeli iliyoandikwa kwa mkono.gpt2/generate.py: Mantiki ya utengenezaji wa greedy, temperature na top-k.chapters/01-inference/: Scripti za maonyesho zinazoambatana na kila mafunzo.docs/01-inference/: Rasimu za awali za makala za mafunzo.demo/app.py: Onyesho la wavuti la Gradio.tests/: Ukaguzi wa maumbo na majaribio ya ulinganifu na HuggingFace.
Mbinu za hali ya juu: maelezo matatu muhimu ya kulinganisha na HuggingFace
1. Tumia kwa usahihi kinyago cha causal
GPT-2 ni modeli ya lugha ya autoregressive. Kila neno katika mfuatano linaweza kusoma neno lenyewe na maneno yaliyotangulia tu, haliwezi kuona token zinazofuata mapema. Ukikosa kinyago cha causal, hata ukifanikiwa kupakia uzito rasmi, matokeo ya modeli yatakuwa si sahihi.
2. Shughulikia transposition wakati wa kuhamisha uzito
Utekelezaji wa awali wa GPT-2 hutumia Conv1D, ambayo umbo la uzito wake ni [in, out]; nn.Linear ya PyTorch hutumia [out, in]. Kwa hiyo, unapopakia vigezo rasmi kwenye tabaka la mstari lililoandikwa kwa mkono, lazima uvigeuze.
Zaidi ya hayo, c_attn huunganisha pamoja vigezo vya Query, Key na Value. Unapolinganisha na utekelezaji wa mkono, lazima kwanza uvigawanye katika sehemu tatu zinazolingana, kisha uviweke kwenye sehemu sahihi.
3. Tumia toleo la GELU linalokaribia kwa tanh
GPT-2 hutumia toleo la GELU linalokaribia kwa tanh, ilhali nn.GELU() ya PyTorch kwa chaguo-msingi hutumia toleo sahihi. Ili kupata ulinganifu wa kipengele kwa kipengele, weka:
nn.GELU(approximate="tanh")Maelezo haya matatu yanaweza kuonekana madogo, lakini huathiri moja kwa moja ikiwa modeli iliyoandikwa kwa mkono inaweza kuzalisha matokeo ya utekelezaji rasmi. Unapotafuta chanzo cha hitilafu, unaweza kukagua kinyago, maumbo ya vigezo na toleo la kazi ya uamilisho kwa mpangilio huo.
Mbinu zinazopendekezwa za kujifunza na kutatua hitilafu
- Anza kwa kuelewa kupitia taswira ya usanifu kwamba GPT-2 hutumia sehemu ya decoder ya Transformer pekee na jinsi uhusiano huo ulivyo kwa ujumla.
- Endesha scripti ya sura ya sasa, kisha rekodi maumbo ya ingizo, matokeo na tensor za kati.
- Wakati matriki ya attention ni ngumu kuelewa, linganisha na taswira ya matriki mtandaoni na ukague kila kipengele.
- Baada ya kukamilisha kipengele kimoja, soma utekelezaji unaolingana katika
gpt2/model.py. - Baada ya kurekebisha utekelezaji, endesha kwanza majaribio yenye uzito wa nasibu, kisha kwa mahitaji endesha majaribio yenye uzito halisi.
- Mwishowe, tumia mfano wa utengenezaji wa maandishi na ukurasa wa Gradio kuchunguza tabia ya modeli kamili.
Mpangilio huu huunganisha mchoro wa usanifu, hesabu za matriki, msimbo wa sura, modeli kamili na matokeo ya mwisho, na kuzuia kuzidiwa na muundo wa GPT-2 wenye tabaka nyingi tangu mwanzo.
Hitimisho
NamiGPT inatoa njia ya kujifunza kutoka kwenye hesabu za msingi za matriksi hadi uendeshaji kamili wa GPT-2. Unaweza kwanza kuendesha hati za sura zinazojitegemea ili kuelewa kila kipengele, kisha kupakia uzani rasmi wa OpenAI ili kukamilisha maandishi ya Kiingereza, na mwishowe kuthibitisha uelewa na marekebisho yako kupitia taswira na majaribio ya ulinganifu ya HuggingFace.
Msimbo wa mradi umetolewa chini ya leseni ya MIT; makala zilizo katika saraka ya docs/ zimetolewa chini ya leseni ya CC BY-NC 4.0. Unapochapisha upya, lazima utaje chanzo, na matumizi ya kibiashara hayaruhusiwi.