

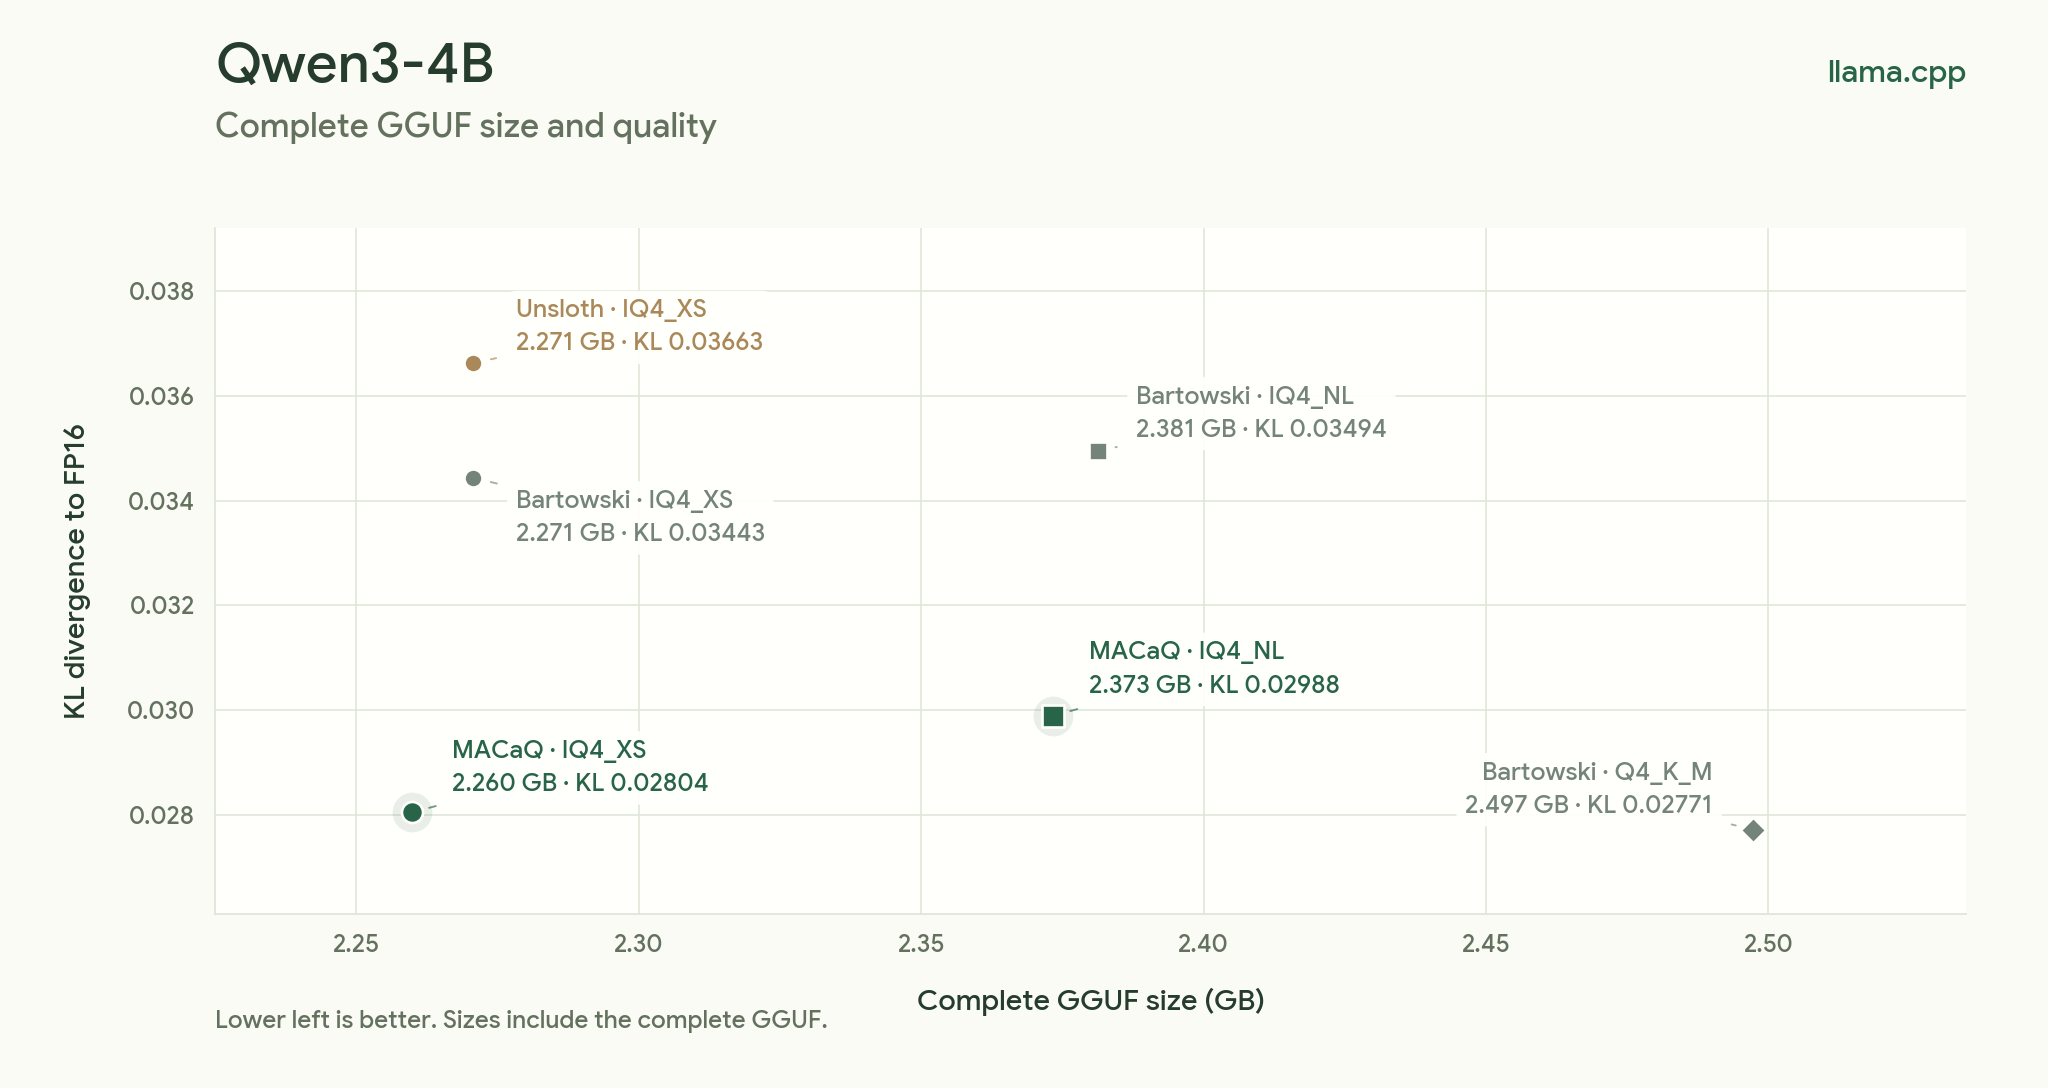
MACaQ ni mradi wa ujanibishaji uliosawazishwa usiotegemea aina ya modeli, unaolenga kupunguza mahitaji ya kumbukumbu na uwezo wa kuchakata ya modeli za kisasa za AI. Unaunga mkono mtiririko wa kazi wa maandishi, picha, video na sauti kupitia llama.cpp, vLLM, Diffusers, na PyTorch.
Mradi unalenga uzani na uamilishaji uliosawazishwa wa usahihi mdogo, huku ukidumisha uoanifu wa kivitendo wa uelekezaji. Kulingana na README, MACaQ inaweza kujanibisha modeli yenye vigezo bilioni 122 kwa dakika 64 kwa kutumia GB 32.5 za kumbukumbu ya kifaa. Pia inaripoti perplexity ya chini kuliko MR-GPTQ na DuQuant++ katika baadhi ya ulinganisho, au perplexity inayolingana na Llama-3-8B huku ikitumia muda mfupi zaidi wa ujanibishaji.
Chagua backend sahihi ya MACaQ
Anza kwa kuchagua backend inayolingana na modeli yako na lengo la upelekwaji. Tumia mazingira tofauti kwa kila backend na Python 3.12.
- Diffusers: janibisha modeli za kutengeneza picha, video na sauti kuwa checkpoint za safetensors za W4A4.
- llama.cpp: janibisha modeli za maandishi kuwa faili za GGUF za biti 2, 3 au 4 na ziendeshe ndani ya kifaa chako, ikiwemo kwenye CPU.
- vLLM: janibisha modeli za maandishi kwa ajili ya utengenezaji au huduma ya HTTP kwa miundo ya W4A4 au ya uzani pekee.
- PyTorch: janibisha modeli za kutengeneza matamshi kuwa checkpoint za W4A4 na utengeneze sauti ya WAV.
Hifadhi ya msimbo ina maelekezo mahususi kwa kila backend kuhusu usakinishaji, usawazishaji, ujanibishaji na utengenezaji. Fungua mwongozo wa backend uliyochagua kabla ya kuanza:
- Usakinishaji na mtiririko wa kazi wa Diffusers
- Usakinishaji na mtiririko wa kazi wa llama.cpp
- Usakinishaji na utoaji wa huduma kwa vLLM
- Mtiririko wa kazi wa matamshi wa PyTorch
Andaa mazingira yako
Tumia Python 3.12 na uunde mazingira yaliyotengwa kwa backend unayopanga kutumia. Kutenganisha mazingira husaidia kuepuka migongano ya utegemezi kati ya llama.cpp, vLLM, Diffusers na PyTorch.
Clone hifadhi ya msimbo ya MACaQ na uingie kwenye saraka yake.
Unda mazingira pepe ya Python 3.12 kwa backend iliyochaguliwa.
Fuata README ya backend hiyo ili kusakinisha utegemezi wake na runtime yoyote inayohitajika.
Andaa modeli asilia, data ya usawazishaji na saraka ya matokeo iliyoainishwa na mwongozo wa backend.
Amri kamili za usakinishaji hutegemea backend na familia ya modeli, kwa hivyo tumia README iliyounganishwa badala ya kutumia amri moja ya jumla ya usakinishaji kwa kila mtiririko wa kazi.
Janibisha modeli za uzalishaji kwa kutumia Diffusers
Backend ya Diffusers hushughulikia diffusion transformers na huhifadhi checkpoint za safetensors zilizojanibishwa. Inaunga mkono utengenezaji wa picha, video, picha hadi video na sauti.
Hifadhi ya msimbo inatoa mitiririko ya kazi kwa modeli zikiwemo black-forest-labs/FLUX.2-klein-4B, Wan-AI/Wan2.2-TI2V-5B-Diffusers, na ylacombe/stable-audio-1.0. Kwa modeli za picha hadi video, usawazishaji unaweza kutumia picha za masharti ili mchakato wa ujanibishaji uakisi muundo uliokusudiwa wa ingizo.
Fungua mwongozo wa Diffusers na uchague mtiririko wa kazi wa picha, video au sauti.
Sakinisha mahitaji ya backend katika mazingira maalum ya Python 3.12.
Pakua au tambua modeli chanzo na uandae maingizo ya usawazishaji yanayohitajika na kichocheo kilichochaguliwa.
Tekeleza amri iliyoandikwa ya ujanibishaji ili kuhifadhi checkpoint ya safetensors ya W4A4.
Tumia amri inayolingana ya utengenezaji ili kutoa matokeo ya picha, video au sauti.
Janibisha modeli za maandishi kwa kutumia llama.cpp
Backend ya llama.cpp hutengeneza faili ndogo za GGUF kwa ajili ya utengenezaji wa maandishi. Inaunga mkono miundo ya GGUF ya biti 2, biti 3 na biti 4, na inajumuisha runtime ya kutengeneza maandishi kutoka kwa modeli inayotokana.
Hifadhi ya msimbo inaandika kuhusu modeli mnene kama Qwen/Qwen3-4B, modeli mseto kama Qwen/Qwen3.8-27B, na modeli za wataalamu mchanganyiko kama Qwen/Qwen3-30B-A3B na Qwen/Qwen3-Coder-30B-A3B-Instruct. Pia inajumuisha mapishi ya Qwen3.6-35B-A3B na Qwen3.8-Flash-Next.
Mtiririko wa kawaida wa ujanibishaji
Fungua mwongozo wa llama.cpp na uchague kichocheo kinacholingana na usanifu wa modeli yako.
Sakinisha backend ya llama.cpp na utegemezi wake katika mazingira maalum ya Python 3.12.
Andaa modeli asilia ya Hugging Face na maandishi ya usawazishaji yaliyoelezwa na kichocheo kilichochaguliwa.
Tekeleza mtiririko wa kazi wa ujanibishaji wa MACaQ ulioandikwa na uhifadhi matokeo ya GGUF.
Tumia runtime iliyojumuishwa au usakinishaji unaooana wa llama.cpp ili kutengeneza maandishi.
Kwa maelezo mahususi ya modeli, fuata sehemu ya dense, hybrid, mixture-of-experts, au Flash-Next katika README ya backend. Maelekezo haya yanazingatia tofauti kati ya usanifu wa modeli.
Endesha modeli ya GGUF
Baada ya faili ya GGUF kuundwa, iendeshe kwa kutumia mteja wa mstari wa amri wa llama.cpp:
llama cli -m models/model-macaq-r.ggufPia unaweza kutoa huduma kwa modeli kupitia llama.cpp:
llama serve -m models/model-macaq-r.ggufBoresha faili zilizopo za GGUF kwa MACaQ-R
MACaQ-R huboresha misimbo ya uzito katika faili ya GGUF iliyopunguzwa ukubwa, huku ikihifadhi fomati zake asilia na vipimo vya vizuizi. Faili inayotokana hubaki sambamba na usakinishaji wa kawaida wa llama.cpp.
Hii ni muhimu ikiwa tayari una modeli iliyopunguzwa ukubwa na unataka kuboresha ubora wake au kuibadilisha kwa mzigo fulani wa kazi bila kubadilisha fomati ya GGUF. README inatoa modeli ya Qwen3.6-35B-A3B MACaQ-R kwenye Hugging Face na inaripoti KL divergence ya chini kuliko faili ya Unsloth UD-Q4_K_XL iliyolinganishwa, kwa ukubwa uleule uliotajwa.
Ili kuboresha GGUF ya MoE iliyopunguzwa ukubwa, toa modeli iliyopunguzwa ukubwa, modeli yake asilia inayolingana ya Hugging Face, faili ya mwalimu ya FP16, maandishi ya kalibresheni, njia ya kutoa matokeo, na saraka ya kazi:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
Uboreshaji ukikamilika, pakia matokeo kwa kutumia llama.cpp ya kawaida:
llama cli -m models/model-macaq-r.ggufKwa mtiririko kamili wa MACaQ, ikijumuisha mabadiliko ya kuwezesha, tumia mwongozo wa runtime uliounganishwa.
Punguza ukubwa na toa huduma kwa modeli ukitumia vLLM
Backend ya vLLM huunda checkpoints fupi za modeli za maandishi kwa ajili ya uzalishaji au utoaji wa huduma kupitia HTTP. W4A4 ndiyo hali chaguo-msingi ya inference, na backend pia inasaidia upunguzaji wa ukubwa wa uzito pekee.
Fungua mwongozo wa vLLM na uchague mtiririko wa kazi wa modeli ya maandishi ya hybrid au modeli ya maandishi ya mixture-of-experts.
Sakinisha backend ya vLLM katika mazingira yake ya Python 3.12.
Andaa modeli chanzo na data ya kalibresheni inayohitajika na maelekezo yaliyochaguliwa.
Endesha amri ya upunguzaji ukubwa iliyoandikwa ili kuunda checkpoint fupi.
Pakia checkpoint kwa uzalishaji wa ndani au anzisha seva ya HTTP iliyoandikwa.
README inaripoti ulinganisho wa Qwen3.8-27B ambapo MACaQ W4A4 inafikia perplexity ya 2.8994 ikilinganishwa na 2.8463 ya BF16, huku ikiripoti vipimo vya haraka zaidi vya prefill na decode katika usanidi wa majaribio uliotajwa.
Punguza ukubwa wa jenereta za sauti kwa PyTorch
Backend ya PyTorch inalenga uzalishaji wa sauti na huhifadhi checkpoints za W4A4. Baada ya checkpoint kuhifadhiwa, inaweza kupakiwa bila kurudia kalibresheni.
Mtiririko wa kazi ulioandikwa unahusu Qwen3-TTS na Chatterbox Turbo.
Fungua mwongozo wa PyTorch na uchague modeli ya sauti.
Sakinisha vitegemezi vinavyohitajika vya PyTorch katika mazingira tofauti ya Python 3.12.
Endesha kalibresheni na upunguzaji ukubwa kwa kutumia maelekezo mahususi ya modeli.
Hifadhi checkpoint ya W4A4.
Pakia checkpoint iliyohifadhiwa na uzalishe sauti ya WAV bila kufanya kalibresheni tena.
Tumia MACaQ na maunzi ya Ascend
Kernel za MACaQ W4A4 za kuzidisha matriki dense na zilizopangwa kwa vikundi zinapatikana kupitia pull request zinazohusiana na CANN. README inaelekeza kwenye kernel za PTO-ISA katika pull request 12568 ya ops-nn na kernel za TileLang zenye backend ya CCE katika pull request 44 ya ops-tilelang.
Fuata maelekezo ya ujenzi katika miradi hiyo kwa matoleo yanayooana ya CANN, PyTorch, na torch_npu. Uendeshaji wa modeli nzima unahitaji muunganisho na runtime ya inference ya Ascend.
Vidokezo vya vitendo vya kuboresha mtiririko wa kazi
- Linganishia backend na lengo la uwekaji. Chagua GGUF na llama.cpp kwa inference ya maandishi ya ndani inayobebeka, vLLM kwa utoaji wa huduma za maandishi, Diffusers kwa uzalishaji wa multimodal, na PyTorch kwa modeli za sauti.
- Tumia maelekezo mahususi ya modeli. Modeli dense, hybrid, na mixture-of-experts zinaweza kuhitaji hatua tofauti za maandalizi na upunguzaji ukubwa.
- Hakikisha data ya kalibresheni inalingana na matumizi. Kwa mfano, mtiririko wa picha-hadi-video wa Diffusers hutumia picha za masharti wakati wa kalibresheni.
- Tenganisha mazingira. README inapendekeza wazi mazingira tofauti kwa kila backend na Python 3.12.
- Linganisha ubora, si ukubwa wa faili pekee. Mradi hutumia ulinganisho wa perplexity na KL divergence kutathmini modeli zilizopunguzwa ukubwa dhidi ya FP16 au mbinu nyingine za upunguzaji ukubwa.
- Tumia MACaQ-R ikiwa tayari una GGUF. Inaweza kuboresha faili iliyopo iliyopunguzwa ukubwa huku ikihifadhi uoanifu wa kawaida wa llama.cpp.
Hitimisho
MACaQ hutoa mbinu moja ya uquantishaji kwa mizigo kadhaa ya kazi za AI, kutoka miundo ya maandishi ya GGUF hadi miundo ya picha, video na sauti ya Diffusers, checkpoint za utoaji huduma za vLLM, na jenereta za usemi za PyTorch. Anza na README maalum ya backend, tumia Python 3.12 katika mazingira yaliyotengwa, fuata mapishi ya modeli kwa ajili ya urekebishaji, na thibitisha checkpoint inayotokana na runtime unayokusudia kutumia.
Kwa utafiti au nyaraka za kiufundi, angalia karatasi ya MACaQ. Mradi umetolewa chini ya Leseni ya Apache 2.0.