

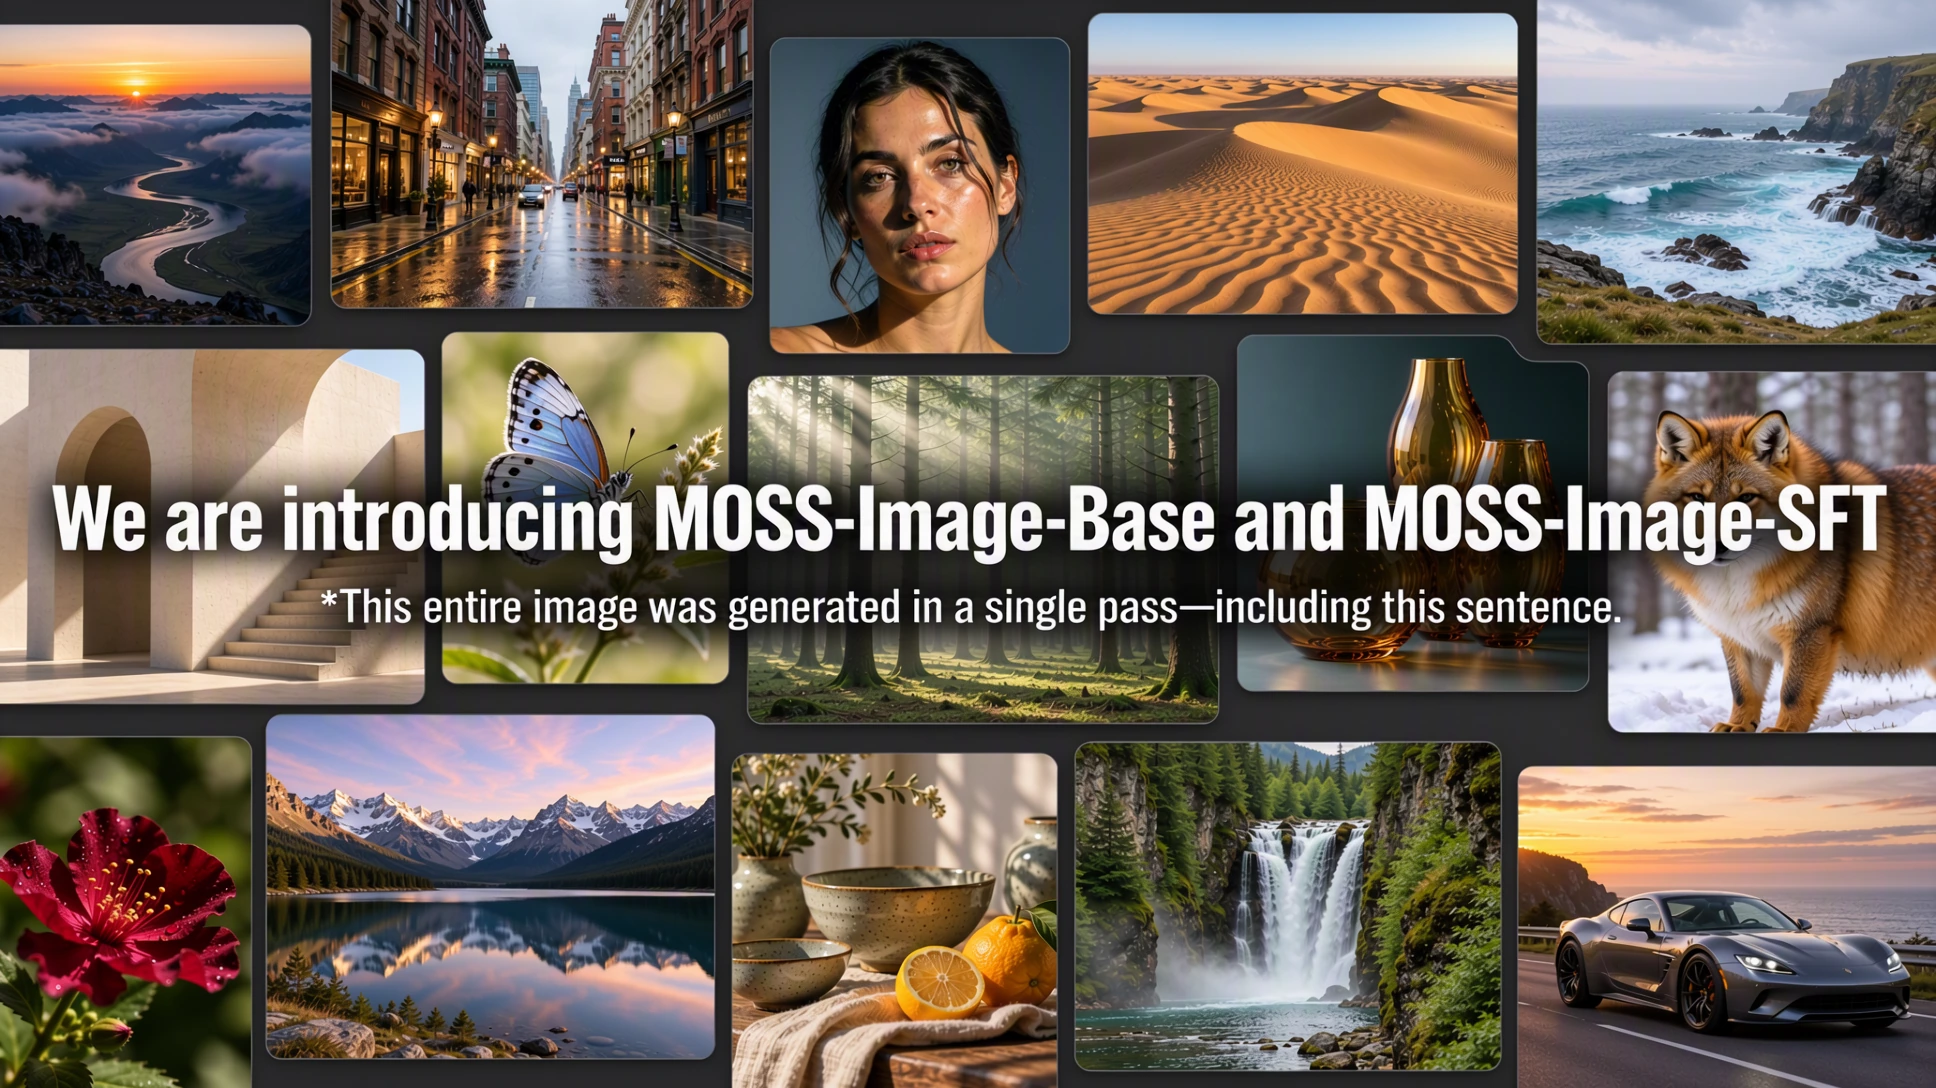
MOSS-Image ni nini?
MOSS-Image ni mradi huria wa kutengeneza picha kutoka kwa OpenMOSS Team. Unatoa modeli msingi ya kubadilisha maandishi kuwa picha na modeli iliyoboreshwa kwa mafunzo yanayosimamiwa, pamoja na pipeline maalum ya Diffusers, kiolesura cha Gradio, programu-jalizi asilia ya ComfyUI, na zana za kuandaa vidokezo vya kina.
Mradi huu umeundwa kwa ajili ya tungo zinazochanganya vipengele vya kuona na maandishi yanayosomeka. Unaunga mkono vidokezo vya hadi tokeni 4K na unaweza kutengeneza mitindo kuanzia anime hadi picha zenye uhalisia wa picha. Kiini chake cha 5B kinalenga kutoa utengenezaji wa picha ulio thabiti na wenye ufanisi.
Vipengele muhimu
- Udhibiti wa mpangilio: Weka maandishi na vipengele vya kuona kwa kutumia ingizo la JSON lenye muundo na visanduku vya mipaka.
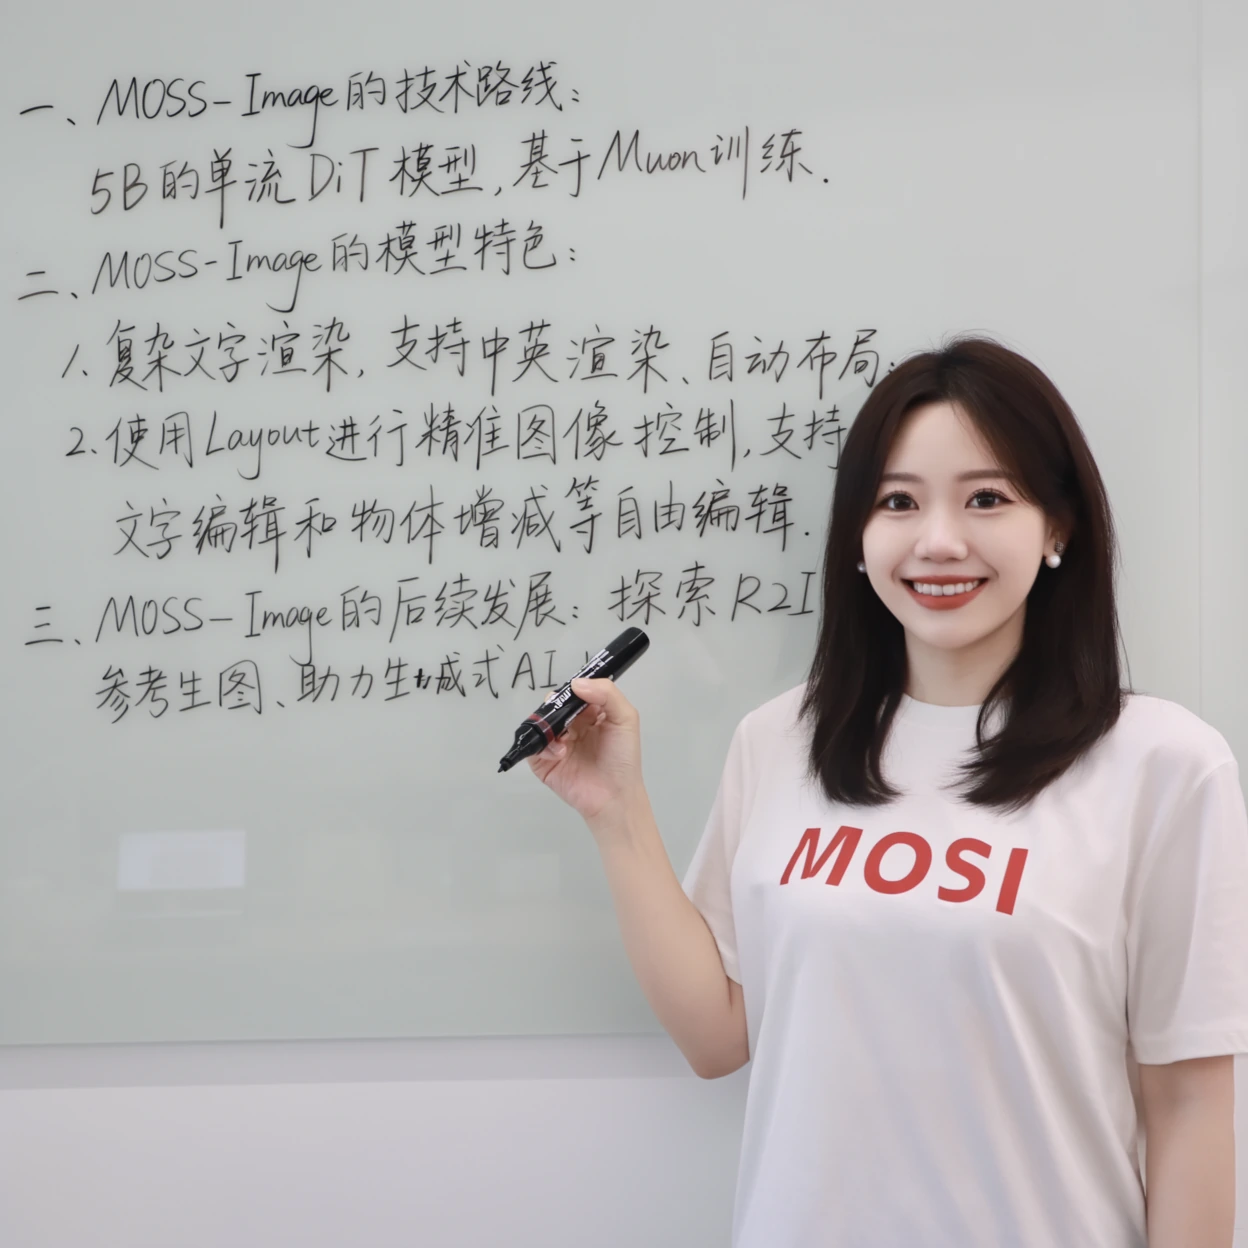
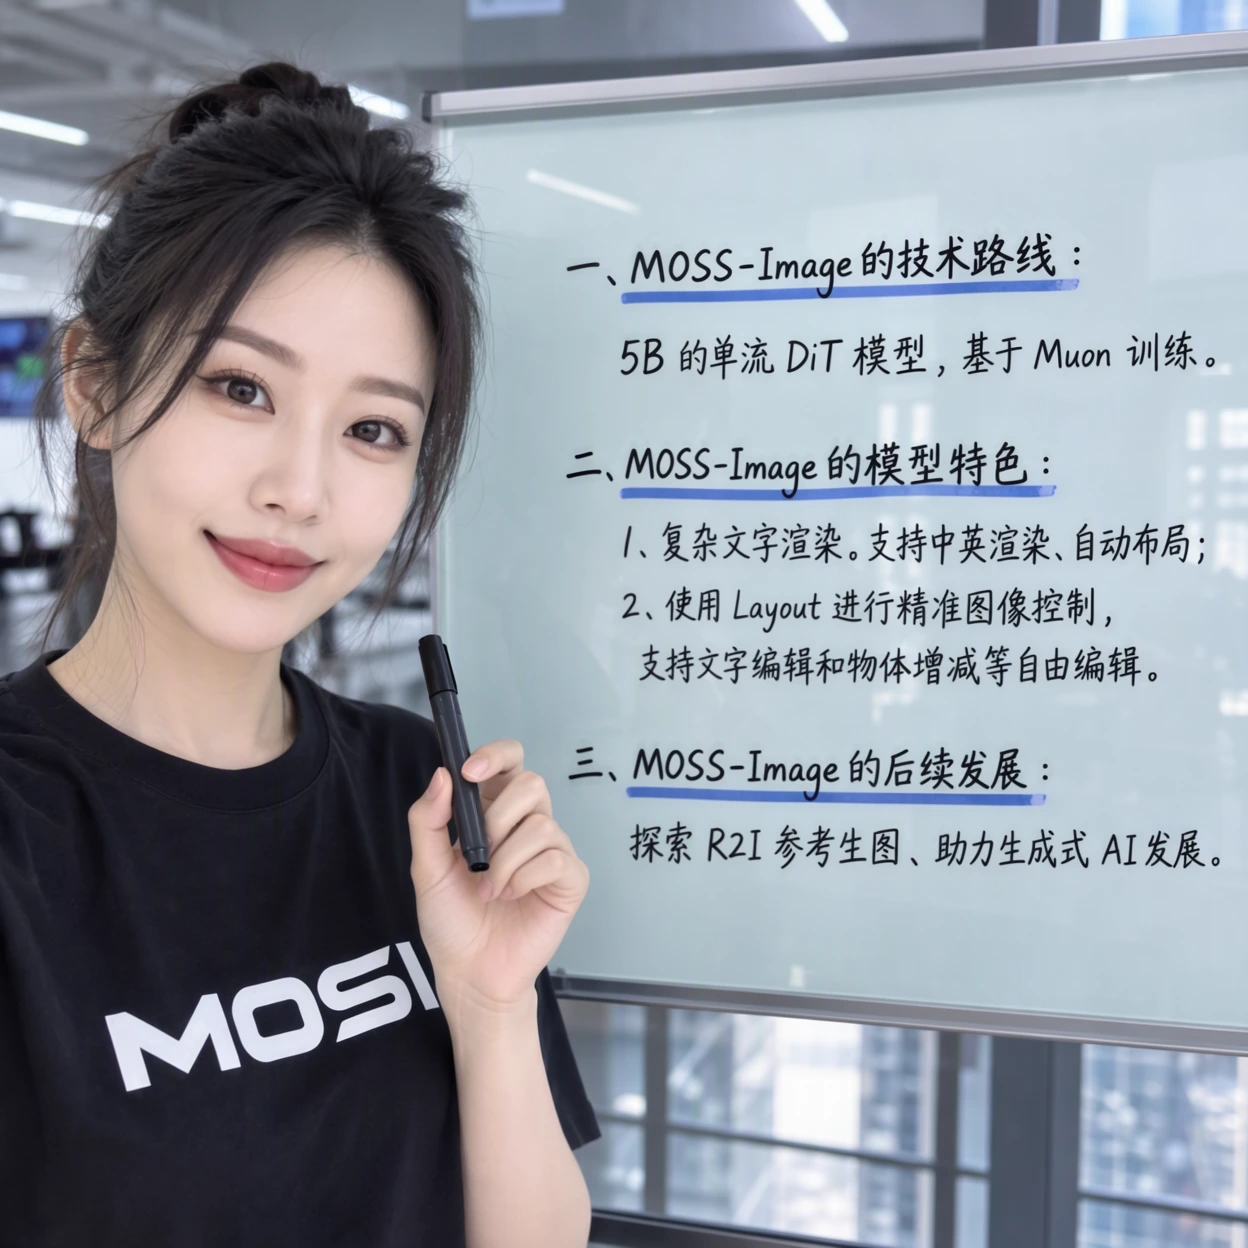
- Uchoraji wa maandishi: Tengeneza maandishi yaliyo wazi ndani ya mabango, madokezo, ubao mweupe na tungo nyingine za picha.
- Vidokezo virefu: Wasilisha vidokezo vya maandishi vyenye hadi tokeni 4K.
- Mitindo mbalimbali: Unda picha za mtindo wa anime na zenye uhalisia wa picha.
- Usaidizi wa uboreshaji maalum: Badilisha modeli msingi kwa kazi na nyanja maalum.
- Muundo wenye ufanisi: Tengeneza picha kwa kutumia kiini cha 5B.
- Violesura mbalimbali: Tumia Python, Gradio, ComfyUI au ujuzi tofauti wa kuboresha vidokezo.
Chagua modeli
MOSS-Image inapatikana katika matoleo mawili:
- MOSS-Image-Base: Modeli msingi ya kubadilisha maandishi kuwa picha. Uzito wake unapatikana kwenye Hugging Face na ModelScope.
- MOSS-Image-SFT: Toleo lililoboreshwa kutoka kwa modeli msingi kwa kutumia data iliyochaguliwa. Uzito wake unapatikana kwenye Hugging Face na ModelScope.
Kulingana na ulinganisho uliotolewa na mradi, modeli ya SFT hutengeneza upangaji wa maandishi ulio wazi zaidi na mpangilio wa ubao mweupe ulio nadhifu zaidi. Anza na modeli ya Base unapohitaji checkpoint ya awali ya matumizi ya jumla au unapopanga kuiboresha. Tumia SFT wakati uwasilishaji wa maandishi yenye muundo ni muhimu hasa.
Sakinisha MOSS-Image
Clone hazina, ingia kwenye saraka yake, unda mazingira pepe, iwashe, kisha sakinisha mahitaji:
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python -m venv .venv
source .venv/bin/activate

pip install -r requirements.txt
Mifano hutumia CUDA na kuhamisha pipeline kwenye GPU kwa kutumia pipe.to("cuda"). Hakikisha mazingira yako ya PyTorch yamewekwa kwa jukwaa la GPU unalopanga kutumia kwa inference.
Tengeneza picha kwa Python
MOSS-Image hupakiwa kupitia Diffusers kwa kutumia pipeline yake maalum. Mfano ufuatao unaomba modeli itengeneze mandhari ya jikoni yenye kikumbusho cha Kichina kilichoandikwa kwa mkono:
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "OpenMOSS-Team/MOSS-Image-Base",
    custom_pipeline="pipeline_moss_image",
    trust_remote_code=True,
    torch_dtype={"default": torch.bfloat16, "vae": torch.float32},
)
pipe.scheduler = type(pipe.scheduler).from_config(pipe.scheduler.config)
pipe.to("cuda")

prompt = (
    "A wide view of a refrigerator beside a kitchen counter with a fruit bowl. "
    "A small sticky note on the refrigerator door is handwritten in Chinese:“\n"
    "记得买牛奶和鸡蛋!\n牛奶两盒,鸡蛋一打。\n顺便带一袋面包。”"
)

image = pipe(
    prompt,
    height=1456,
    width=1456,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("refrigerator_note.png")
Elewa hoja muhimu
custom_pipeline="pipeline_moss_image"huchagua pipeline ya MOSS-Image.trust_remote_code=Truehuruhusu Diffusers kupakia utekelezaji maalum wa pipeline ya modeli.torch_dtypehutumia bfloat16 kwa chaguo-msingi huku ikihifadhi float32 kwa VAE.heightnawidthhuamua vipimo vya matokeo.num_inference_steps=50hufuata pendekezo chaguo-msingi la sampuli la mradi.guidance_scale=3.0hutumia thamani inayopendekezwa ya uelekezaji usiotegemea kiainishi.uncond_skip_layers=[22]huwezesha kuruka tabaka la tawi hasi kwenye tabaka la 22.manual_seed(42)hufanya utekelezaji unaorudiwa wenye usanidi uleule uweze kutoa matokeo yanayofanana zaidi.
Endesha kiolesura cha Gradio
Sakinisha vitegemezi vya hiari vya kiolesura cha mtumiaji na uanzishe programu iliyojumuishwa:
pip install -e '.[ui]'
python gradio_app.py --model OpenMOSS-Team/MOSS-Image-Base
Fungua anwani ya ndani iliyoripotiwa na Gradio, ingiza kidokezo chanya, chagua vipimo vya picha, kisha uanze utengenezaji. Ili kujaribu checkpoint iliyoboreshwa, badilisha hoja ya modeli kuwa OpenMOSS-Team/MOSS-Image-SFT.
Mipangilio inayopendekezwa ya sampuli
- Sampler: Flow-matching Euler
- Hatua: 50
- CFG: 3
- Shift: 5
- Kuruka tabaka: Kuruka tawi hasi kwenye tabaka la 22
- Kidokezo hasi cha API ya Python: Tupu
Hizi ni mipangilio chaguomsingi iliyoandikwa ya mradi na zinatoa mwanzo wa kivitendo. Rejelea mwongozo wa mtumiaji kwa Kiingereza wa hazina kwa mapendekezo zaidi kuhusu vidokezo na sampuli.
Dhibiti muundo kwa kutumia mipangilio ya JSON
Vidokezo vya kawaida hueleza kile ambacho picha inapaswa kuwa nacho, lakini havibainishi kwa usahihi mahali kila kipengele kinapaswa kuwekwa. Badala yake, MOSS-Image inaweza kupokea mpangilio wa JSON unaoeleza mandhari yote, vipengele mahususi vya maandishi au vitu, pamoja na visanduku vyake vya mipaka.
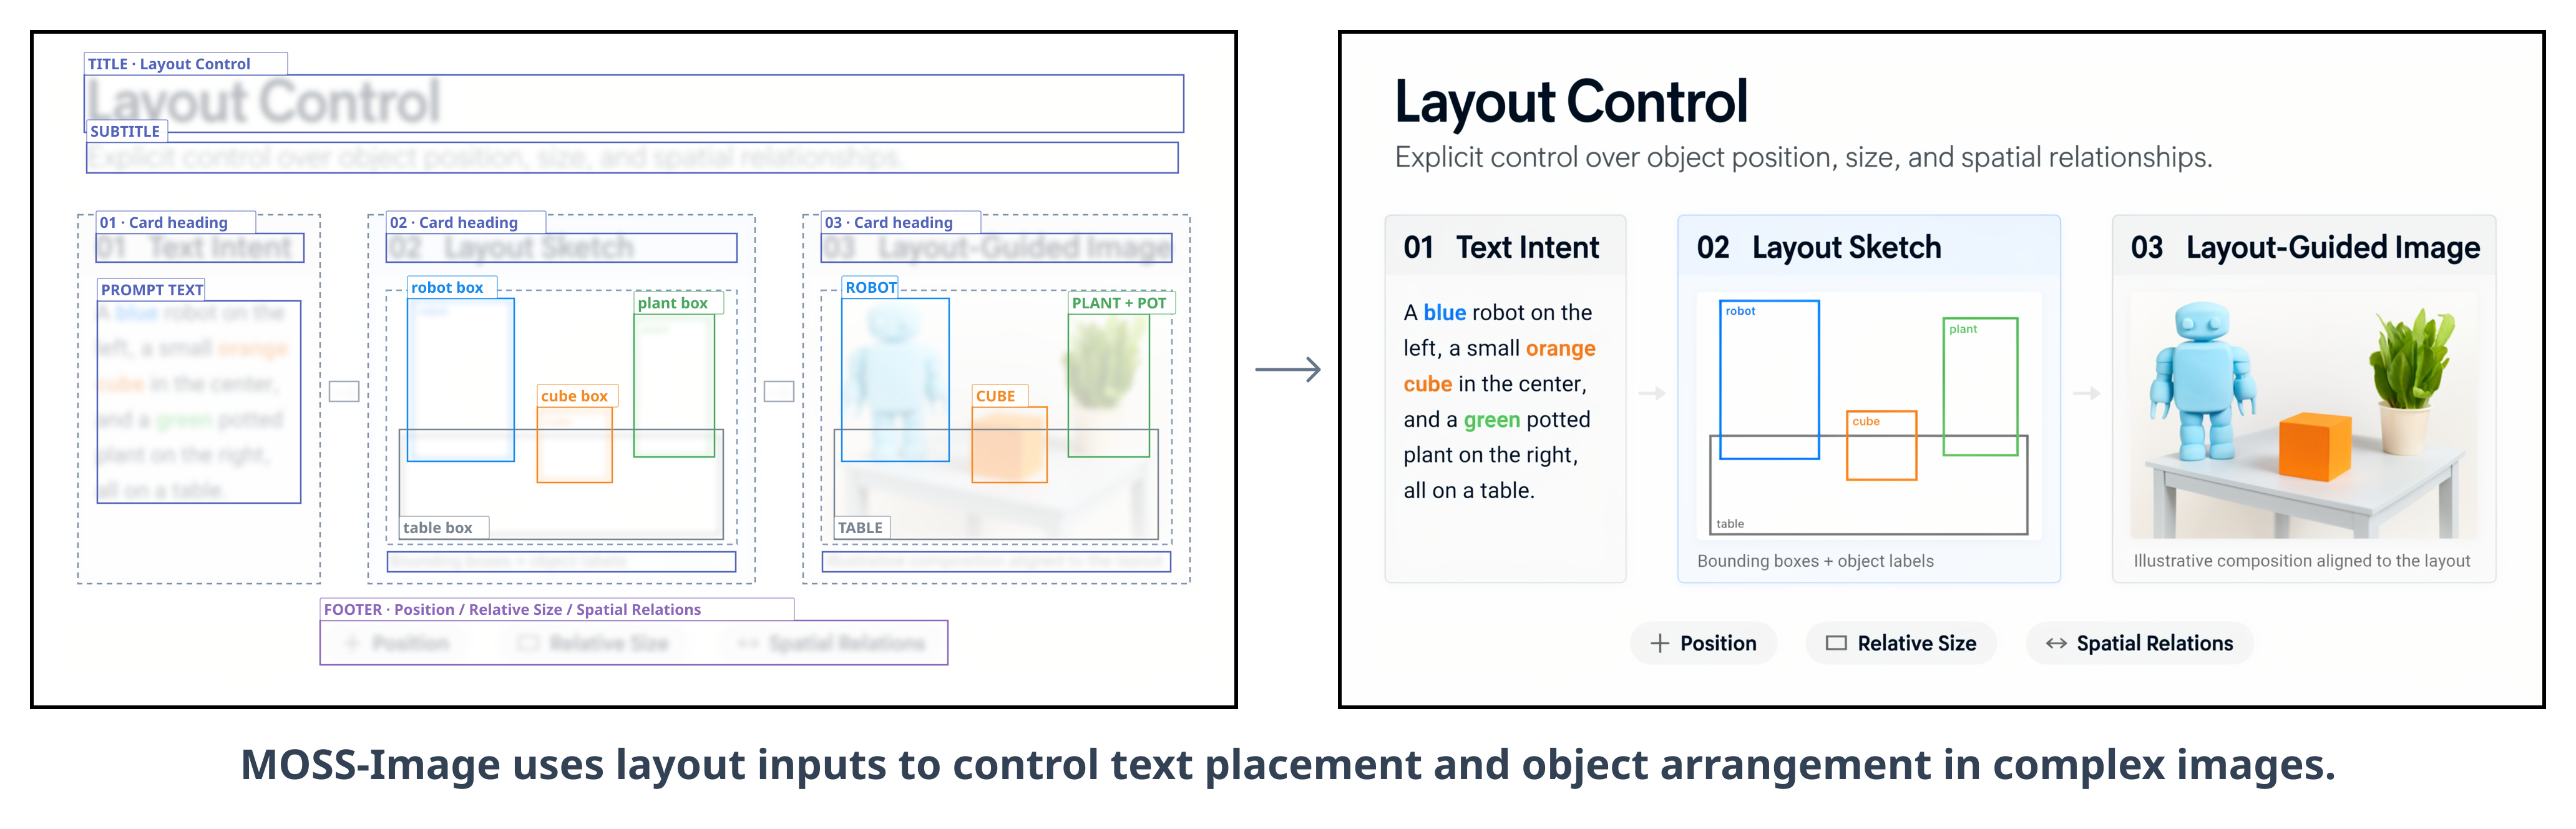
Mpangilio ufuatao unaeleza bango dogo la kusafiri lenye ukubwa wa 1024 kwa 1024. Liweke kama layout.json ikiwa unataka kulipakia kutoka Python, au libandike moja kwa moja kwenye sehemu ya Prompt ya Gradio.
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "Bango dogo la kusafiri lenye mandharinyuma ya rangi ya krimu, mchoro wa mlima wa buluu, na kichwa EXPLORE juu."
  },
  "items": [
    {
      "label": "text",
      "caption": "Kichwa kikubwa cha herufi kubwa za buluu iliyokolea, kilichowekwa katikati juu.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    },
    {
      "label": "object",
      "caption": "Mchoro bapa wa mlima wa buluu katika sehemu ya chini katikati.",
      "bbox": [-192, -288, 384, 288]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Jinsi umbizo la mpangilio linavyofanya kazi
summary.captionhueleza mandhari nzima na mtindo wake wa kuona.itemshuwa na vipengele vya maandishi na vitu vilivyowekwa kivyake.labelhutambulisha kipengele kuwa maandishi au kitu.captionhueleza mwonekano na jukumu la kipengele.texthuwa na maneno kamili ambayo kipengele cha maandishi kinapaswa kuonyesha.bboxhufafanua nafasi na ukubwa wa kipengele.bbox_format: "yxyx"inamaanisha kwamba kila kisanduku hupangwa kama[y_min, x_min, y_max, x_max].bbox_coord_space: "abs_centralized"inamaanisha kwamba viwianishi hupimwa kutoka katikati ya turubai.
Kwenye turubai ya 1024 kwa 1024, mhimili wote huanzia -512 hadi +512. Kiwianishi cha x huongezeka kuelekea kulia, huku kiwianishi cha y kikiongezeka kuelekea chini. Ili kubadilisha viwianishi vya kawaida vya turubai, toa nusu ya upana wa turubai kutoka kwenye thamani za x na nusu ya urefu wa turubai kutoka kwenye thamani za y.
Tumia kila mara vipimo vya uundaji vinavyolingana na vipimo ambavyo mpangilio uliandaliwa kwa ajili yake. Kutolingana hubadilisha mfumo wa viwianishi na kunaweza kuhamisha vipengele kutoka kwenye nafasi vilizokusudiwa.
Wasilisha mpangilio kupitia Python
Pakia faili la JSON, libadilishe kuwa mfuatano, kisha upitishe mfuatano huo kama kidokezo cha pipeline:
import json
import torch

with open("layout.json", "r", encoding="utf-8") as file:
    layout = json.load(file)

layout_prompt = json.dumps(layout, ensure_ascii=False)

image = pipe(
    layout_prompt,
    height=1024,
    width=1024,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]

image.save("travel_poster.png")
Unaweza kurekebisha muundo bila kuandika upya kidokezo kizima. Hariri maandishi, maelezo, au kisanduku cha mipaka cha kipengele kimoja, kisha tengeneza picha tena. README pia inaeleza kwamba mbinu hii iliyopangwa inaweza kusaidia uhariri unaodhibitiwa na zana rafiki za kupanga muundo.
Dhibiti kumbukumbu ya GPU
Kiolesura cha Gradio hutoa hali tatu za kumbukumbu chini ya mipangilio ya Advanced:
- GPU resident: Huweka modeli nzima kwenye GPU kwa ufikiaji wa moja kwa moja.
- Component: Huhamisha vipengele vya modeli kati ya CPU na GPU inapohitajika.
- Sequential fallback: Hupunguza matumizi ya kumbukumbu kwa gharama ya uundaji wa polepole zaidi.
Ikiwa modeli haiwezi kutoshea kwenye kumbukumbu ya GPU inayopatikana, chagua hali ya Sequential au punguza ukubwa wa picha ya matokeo. Ukusanyaji wa DiT umezimwa kwa chaguomsingi na haupatikani katika hali ya Sequential.
Tumia MOSS-Image na ComfyUI
Hazina hii inajumuisha programu-jalizi asilia ya MOSS-Image kwa ComfyUI. Tafuta MOSS-Image katika ComfyUI Manager ili kuisakinisha. Mradi pia hutoa mtiririko wa mfano unaoweza kuagizwa kama mwanzo.
Mradi unaendelea kufanyia kazi ujumuishaji katika hazina rasmi ya ComfyUI. Hadi wakati huo, fuata maelekezo ya kusakinisha na kutumia ComfyUI ya hazina.
Uandishi wa vidokezo wa hali ya juu kwa Prompt Enhancer
Prompt Enhancer iliyojumuishwa ya MOSS-Image hubadilisha wazo la msingi la picha kuwa maelezo ya kina au kidokezo cha mpangilio wa anga. Imeundwa kwa mawakala wa familia ya GPT-6 walio na zana za faili za ndani na Python.
- Sakinisha folda ya
skills/moss-image-prompt-enhancerkwenye saraka ya ujuzi ya wakala wako. - Washa
$moss-image-prompt-enhancerpamoja na wazo la picha. - Eleza ikiwa unataka maelezo ya kina au matokeo ya Layout.
- Toa vipimo vya turubai vinavyokusudiwa unapounda mpangilio.
- Bandika matokeo yaliyokusanywa kwenye kidokezo chanya cha MOSS-Image.
- Kwa matokeo ya Layout, tengeneza picha kwa vipimo vilevile vya turubai vilivyotumika wakati wa ukusanyaji.
Skripti iliyojumuishwa hubadilisha michoro ya viwianishi vya pikseli kuwa JSON fupi kwa kutumia viwianishi kamili vilivyowekwa katikati. Hutayarisha vidokezo pekee na haiwasiliani na huduma ya kutengeneza picha.
Vidokezo vya vitendo
- Anza na chaguo-msingi zilizoandikwa: Tumia hatua 50, CFG 3, shift 5, na kuruka tawi hasi kwenye safu ya 22 kabla ya kufanya majaribio.
- Weka maandishi yanayoombwa wazi: Weka maneno kamili kwenye kidokezo au kwenye sehemu ya
textya kipengee. - Tumia miundo iliyopangwa kwa miundo changamano: Mabango, michoro, na mandhari yenye maandishi mengi hunufaika kutokana na vipengele vilivyoelezwa kando na visanduku vya mipaka.
- Linganisha vipimo kwa uangalifu: Viwianishi vya mpangilio vinahusishwa na upana na urefu wa turubai iliyochaguliwa.
- Funga seed unapofanya marekebisho: Kudumisha seed ileile hukusaidia kulinganisha mabadiliko ya kidokezo, modeli, na mpangilio.
- Punguza ukubwa wa picha kumbukumbu inapokuwa ndogo: Hii ni mojawapo ya suluhisho zilizopendekezwa waziwazi na mradi.
- Linganisha Base na SFT: Kipimo cha SFT kinaweza kufaa zaidi wakati upangaji ulio wazi na mpangilio wa maandishi uliopangwa vizuri ni vipaumbele.
Hitimisho
MOSS-Image inachanganya utengenezaji wa jumla wa picha kutoka kwenye maandishi na uonyeshaji bora wa maandishi pamoja na udhibiti wa utungaji uliopangwa. Unaweza kuanza na mchakato wa Python au kiolesura cha Gradio, kisha kuhamia kwenye mipangilio ya JSON wakati uwekaji sahihi ni muhimu. Muunganisho wa ComfyUI, hali za kumbukumbu, na ujuzi wa kuboresha vidokezo hutoa njia za ziada za kuingiza modeli kwenye mitiririko ya kazi ya kuona. Msimbo wa mchakato wa kujitegemea unapatikana chini ya Leseni ya Apache 2.0.