

Vifikishaji Vidogo Hufanya Nini
tiny-classifiers ni mwongozo wa vitendo wa kufunza vifikishaji vidogo vya maandishi vinavyolenga kazi mahususi. Hutumia kisanifu cha Ettin-17M chenye vigezo milioni 17, huboresha uzani wake wote, na huhifadhi matokeo kama modeli ya kawaida ya Hugging Face.
Mradi huu umeundwa kwa kazi za uainishaji kama vile kuelekeza ujumbe wa benki, kuweka habari katika makundi, kutambua dhamira ya mtumiaji, kugundua hisia, au kuainisha hati za kisheria katika kategoria zilizobainishwa awali. Ikiwa huna mifano ya kutosha yenye lebo, modeli kubwa ya lugha inaweza kuwa mwalimu na kuweka lebo kwenye seti ya mafunzo.
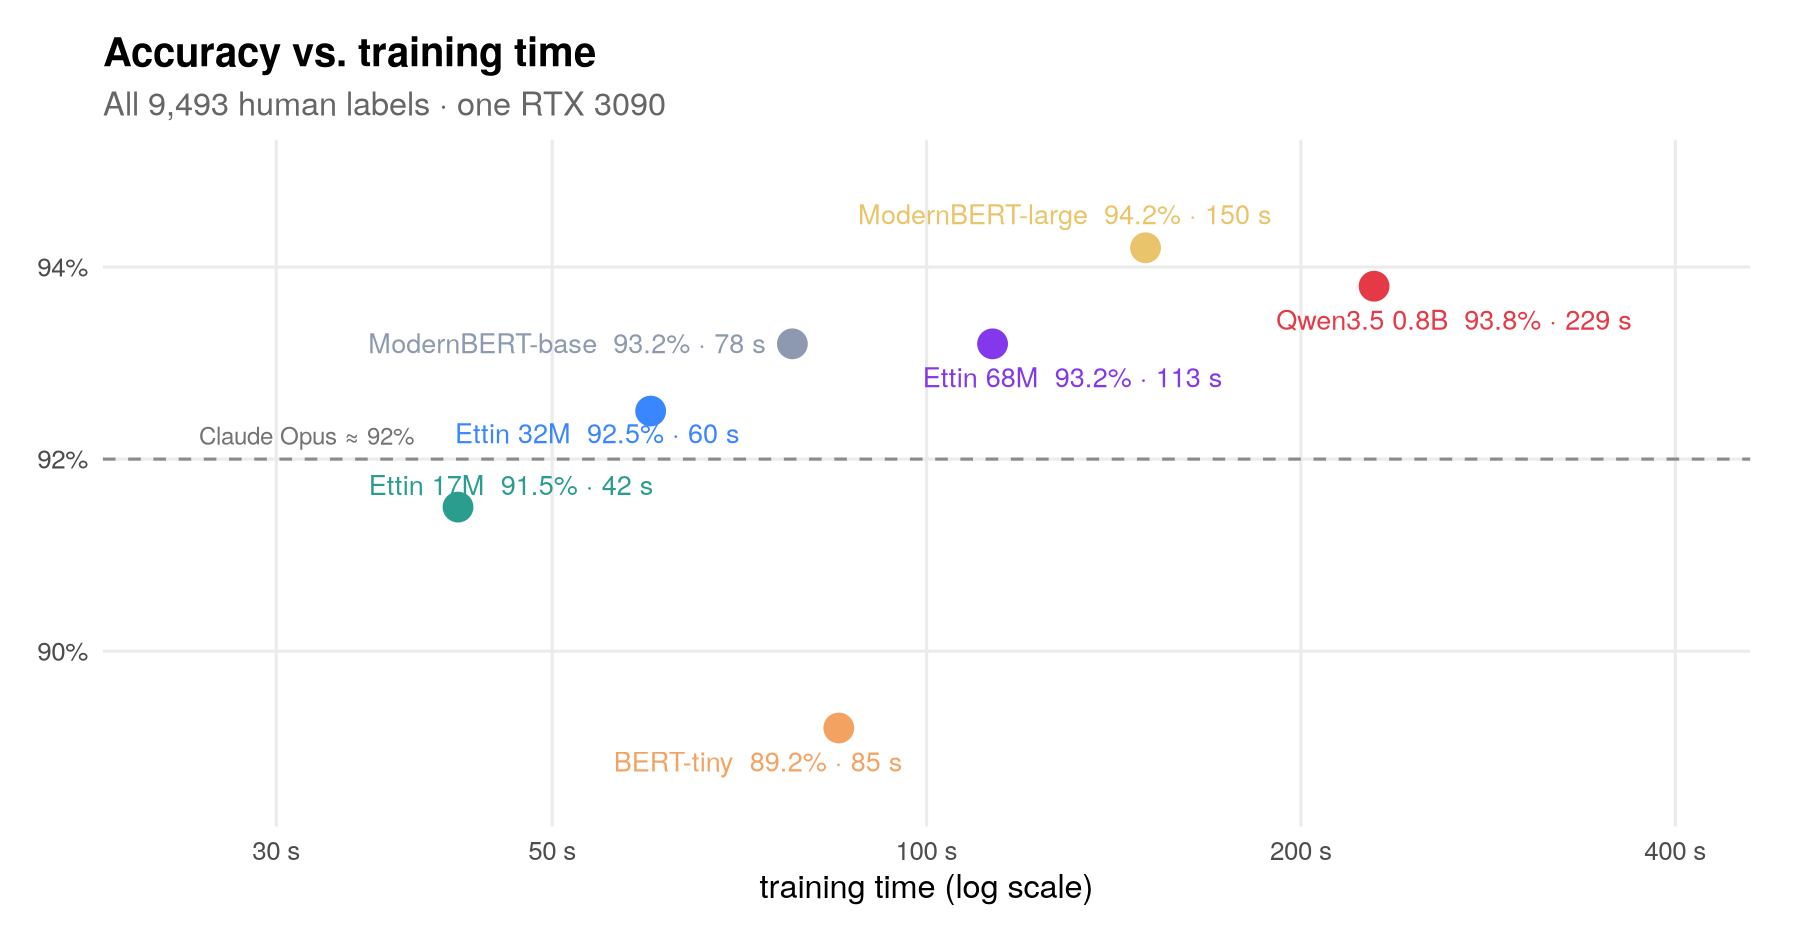
Katika jaribio la Banking77 kwenye hazina, Ettin-17M ilifikia usahihi wa 91.5%, ikilinganishwa na 92% wa Claude Opus. Mafunzo yalichukua sekunde 42 kwenye GPU moja ya michezo, huku ukisiaji ukichukua takriban milisekunde 5 kwa kila ujumbe. Mafunzo pia yalifanya kazi kwenye CPU ya kompyuta mpakato kwa takriban dakika 11 na kwenye GPU ya simu kwa takriban dakika 21.
Usahihi wa Banking77 ukilinganishwa na muda wa mafunzo.
Vipengele Muhimu
- Modeli ndogo ya ndani: Ettin-17M ina vigezo milioni 17 na hutoa alama moja kwa kila kategoria.
- Lebo za binadamu au mwalimu: Funza kwa lebo zilizothibitishwa au mwombe Kimi K3 kuweka lebo kwenye ujumbe ambao hauna lebo.
- Mafunzo kwa GPU na CPU: Skripti ya mafunzo inasaidia mazingira yote mawili.
- Matokeo ya modeli ya kawaida: Vifikishaji vilivyofunzwa vinaweza kupakiwa kupitia pipeline ya Hugging Face
transformers. - Uwekaji lebo unaoweza kuendelea: Skripti ya uwekaji lebo inasaidia majaribio tena, ulinganifu unaobadilika, kushughulikia maombi yanayochelewa, na bajeti za watoa huduma.
- Tathmini iliyojengewa ndani: Mafunzo huripoti usahihi wa jaribio, huku uwekaji lebo wa mwalimu ukiweza kupima usahihi wa mwalimu kwenye seti ya jaribio yenye lebo.
- Uchambuzi wa gharama: Skripti ya usawa wa gharama hukadiria ni lini uwekaji lebo na mafunzo huwa nafuu kuliko kulipia uainishaji kupitia API.
- Maandalizi ya data yanayoweza kutumika tena: Mradi unaweza kuandaa seti kumi za data za uainishaji wa umma kwa kutumia muundo mmoja thabiti.
Jinsi Mbinu ya Mafunzo Inavyofanya Kazi
Ettin-17M ni kisimbaji huria kutoka Johns Hopkins na kinahusiana na modeli za aina ya BERT. Tofauti na modeli zalishi inayozalisha maandishi tokeni baada ya tokeni, husoma ingizo lote na kumpa kila kategoria inayopatikana alama.
Hazina huongeza towe moja kwa kila kategoria na huboresha kila uzani wa modeli. Mbinu yake chaguomsingi hutumia ukubwa wa kundi wa 32, AdamW yenye kiwango cha ujifunzaji cha 1e-4, upunguzaji wa uzani wa 0.01, upashaji joto wa 5% unaofuatwa na upunguzaji wa cosine, ukataji wa gradient kwenye 1.0, na hasara ya cross-entropy.
Kwa takriban ujumbe 9,500, mafunzo hupitia data mara sita. Ikiwa kuna mifano 2,000 pekee, hutumia idadi ileile ya hatua za uboreshaji, inayolingana na takriban mapitio 28. README inasisitiza kuwa mipangilio hii haijarekebishwa kivyake kwa kila kazi.
Usakinishaji na Usanidi
1. Sakinisha uv
Skripti hutumia uv kuunda mazingira yanayohitajika na kusakinisha utegemezi kiotomatiki wakati wa kwanza kuendesha. Sakinisha uv kwa kufuata maelekezo ya mfumo wako wa uendeshaji, kisha fungua terminal kwenye saraka kuu ya hazina.
2. Andaa seti za data za umma
Endesha skripti ya maandalizi:
uv run recipe/prepare.pyHii hupakua Banking77, CLINC150, MASSIVE kwa Kiingereza na Kifaransa, TREC, AG News, SST-5, Financial PhraseBank, LEDGAR, na seti ya data ya matamshi ya chuki kwenye twiti kutoka Hugging Face Hub.
Kwa kila kazi, skripti huunda saraka chini ya data/tasks/. Huunda ufafanuzi wa kazi, ujumbe 2,000 wa mafunzo, mgawanyo mkubwa zaidi wa mafunzo wenye hadi mifano 150 kwa kila kategoria, na seti ya majaribio.
3. Sanidi mtoa huduma wa uwekaji lebo
Ikiwa unataka modeli ya mwalimu itengeneze lebo, weka ufunguo wa API wa mtoa huduma mmoja au zaidi wanaoungwa mkono:
export OPENROUTER_API_KEY=...Mbinu hii pia hutambua funguo za watoa huduma zinazohusishwa na Fireworks, Together, DeepInfra, na Parasail. Kagua bei za sasa, sera za matumizi, na masharti ya modeli ya mtoa huduma husika kabla ya kutuma data au kutumia majibu yaliyotengenezwa kwa mafunzo.
Mafunzo ya Msingi: Funza Kivishaji cha AG News
Hatua ya 1: Tengeneza lebo kwa Kimi K3
Baada ya kuandaa seti za data, weka lebo kwenye ujumbe 2,000 wa mafunzo wa AG News:
uv run recipe/label.py data/tasks/agnewsKatika uendeshaji ulioripotiwa, Kimi K3 iliweka lebo kwenye mifano 2,000 kwa takriban sekunde 20 kwa gharama ya takriban $1. Muda na gharama halisi vinaweza kutofautiana kulingana na mtoa huduma. Skripti inaweza kuendelea baada ya kukatizwa, kwa hivyo kazi ya uwekaji lebo iliyokatizwa haihitaji kuanza upya.
Hatua ya 2: Boresha Ettin-17M kwa lebo za mwalimu
Pitisha faili la lebo lililotengenezwa kwenye skripti ya mafunzo na uchague saraka ya matokeo:
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnewsSkripti huboresha kivishaji, hukitathmini kwenye seti ya majaribio, huchapisha usahihi wa jaribio, na kuhifadhi modeli inayooana na Hugging Face chini ya models/agnews.
Hatua ya 3: Funza msingi wenye lebo za binadamu
Endesha skripti ileile ya mafunzo bila hoja ya lebo za mwalimu ili kufunza kwa lebo asili za binadamu za seti ya data:
uv run recipe/train.py data/tasks/agnewsUlinganisho huu husaidia kubaini ni kiasi gani cha utendaji kilipotea wakati wa uhamishaji wa maarifa. Katika uendeshaji wa mafunzo wa hazina, lebo za binadamu zilitoa usahihi wa 89.2%, lebo za Kimi K3 zilitoa 85.1%, na lebo za Qwen3.8-27B zilitoa 81.8%.
Hatua ya 4: Ainisha maandishi mapya
Pakia modeli iliyohifadhiwa kwa kutumia pipeline ya Hugging Face:
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
Matokeo ni orodha iliyo na lebo iliyotabiriwa na alama yake. Kwa mfano huu, kategoria inayotarajiwa ni Sci/Tech. Modeli ya AG News iliyoripotiwa ilichakata ujumbe ndani ya takriban milisekunde 6 kwenye CPU.
Tumia Vainishi Vidogo kwa Data Yako Mwenyewe
1. Unda saraka ya kazi
Unda folda inayofuata mpangilio sawa na data/tasks/agnews/. Kila kazi maalum inahitaji faili za task.json, train.jsonl, na test.jsonl.
2. Bainisha kategoria
Faili ya task.json lazima iwe na jina, sentensi moja ya maagizo, na orodha kamili ya lebo:
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}Tumia majina ya lebo yaliyo tofauti na yenye maana. Maagizo yanapaswa kueleza kwa uwazi uamuzi wa uainishaji ambao modeli au mwalimu anapaswa kufanya.
3. Ongeza rekodi za mafunzo na majaribio
Hifadhi kitu kimoja cha JSON kwa kila mstari. Rekodi yenye lebo ina muundo huu:
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}Ikiwa modeli ya mwalimu itaweka lebo kwenye data ya mafunzo, rekodi katika train.jsonl zinaweza kuacha sehemu ya label:
{"id":"msg-002","text":"The application closes whenever I upload a file."}Rekodi za majaribio zinapaswa kuwa na lebo zilizokaguliwa ili uweze kupima usahihi wa mwalimu na mwanafunzi. Mradi unapendekeza kukagua mwenyewe jumbe mia kadhaa za majaribio kabla ya kuamini modeli katika uzalishaji.
4. Weka lebo, fundisha, na tathmini
Badilisha saraka yako katika amri za kawaida:
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
  --save models/support-routing
Pia unaweza kufundisha moja kwa moja kwa kutumia lebo za binadamu kwa kuacha --labels. Ili kutumia encoder nyingine badala ya Ettin-17M, pitisha modeli kupitia chaguo la --model la hati ya mafunzo.
Pima Wakati Uboreshaji Maalum Unapokuwa na Faida
Endesha uchanganuzi wa usawa wa gharama na faida baada ya kuandaa kazi:
uv run recipe/breakeven.pyHati hii inakadiria ni jumbe ngapi lazima ziainishwe kabla ya gharama za awali za kuweka lebo na mafunzo kurejeshwa, ikizingatia pesa na muda. Ikilinganishwa na API ya uainishaji wa bila mifano ya Jev, hazina ilipata viwango vya usawa wa gharama na faida vya takriban jumbe 50,000 hadi 500,000, kutegemea kazi.
Ikiwa ujazo wako ni mdogo au hauna uhakika, API inaweza kuwa chaguo rahisi zaidi. Uboreshaji maalum huvutia zaidi wakati kazi ni thabiti, data ya tathmini ipo, na ujazo wa uainishaji ni mkubwa.
Vidokezo vya Juu
Tanguliza ubora wa lebo
Majaribio yalibaini kuwa lebo zina umuhimu zaidi kuliko ukubwa wa modeli. Mikondo ya ujifunzaji iliendelea kuimarika kadiri mifano zaidi yenye lebo ilivyoongezwa. Mwanafunzi aliyefundishwa na mwalimu kwa kawaida alibaki chini ya mwalimu wake kwa pointi chache za usahihi, huku lebo za binadamu zikiweza kuvunja kikomo hicho.
Kagua kategoria zenye utata, sahihisha makosa ya kimfumo ya uwekaji lebo, na ongeza mifano wakilishi kabla ya kubadilisha usanifu au kurekebisha vigezo vingi vya hyperparameter.
Tathmini mwalimu kando
Mwanafunzi hawezi kufidia kwa kutegemewa mwalimu anayefanya vibaya kwenye kazi hiyo. Matokeo ya kazi kumi yalionyesha kuwa modeli zilizowekewa lebo na mwalimu zilipoteza kiwango pale mwalimu mwenyewe alipokuwa dhaifu. Hifadhi seti ya majaribio iliyokaguliwa na binadamu na pima usahihi wa mwalimu kabla ya kulipia uwekaji lebo wa mkusanyiko mkubwa zaidi.
Hesabu tofauti za majaribio
README inaripoti tofauti ya takriban ±0.5 ya pointi za asilimia kutokana na mbegu za nasibu na ±1.5 hadi 2 ya pointi kutokana na ukubwa wa seti ya majaribio. Majedwali yaliyochapishwa yanatumia wastani wa majaribio matatu. Tumia majaribio yanayorudiwa na seti za majaribio zenye ukubwa wa kutosha wakati tofauti ndogo za usahihi zinaathiri maamuzi ya uwekaji wa mfumo.
Heshimu leseni na masharti ya mtoa huduma
Fanya mafunzo kwa majibu yaliyoundwa pekee wakati leseni ya modeli ya mwalimu na masharti ya mtoa huduma yanaporuhusu. Hazina ilitumia Kimi K3, lakini baadhi ya modeli na API zinakataza kutumia matokeo yao kufundisha modeli nyingine. Seti za data za umma pia zinaendelea kuwa na leseni zao; hazina huzipakua badala ya kuzisambaza tena.
Chunguza maunzi mbadala
Hati kuu ya mafunzo inasaidia uendeshaji wa CPU na GPU. Hazina pia inajumuisha utekelezaji tofauti wa simu unaofundisha kupitia Chrome kwa kutumia WebGPU na jax-js. Chukulia mtiririko wa kazi wa simu kama utekelezaji maalum na fuata maagizo katika saraka ya phone/ ya mradi.
Shughulikia tatizo lililoandikwa la NixOS
Ikiwa mafunzo kwenye NixOS yanashindwa kwa sababu /sbin/ldconfig haipatikani, weka njia ya maktaba ya CUDA kabla ya kuendesha mafunzo:
export TRITON_LIBCUDA_PATH=/run/opengl-driver/libHitimisho
tiny-classifiers hutoa mtiririko mfupi wa kazi wa kubadilisha maandishi yenye lebo kuwa vainishi ya haraka ya ndani: andaa kazi, pata lebo kutoka kwa binadamu au mwalimu, boresha Ettin-17M, tathmini dhidi ya mifano iliyokaguliwa, na kadiria kama uendeshaji wa ndani una faida ya kiuchumi kuliko API.
Somo muhimu zaidi ni kuwekeza katika lebo na data ya tathmini zinazoaminika. Hizo zikishapatikana, encoder yenye vigezo milioni 17 inaweza kutoa usahihi thabiti wa uainishaji, uendeshaji wa kiwango cha milisekunde, na gharama zinazotabirika za ndani bila kuita modeli kubwa kwa kila ujumbe.