
- 月流量
- 0
- 产品收费
- 未设置
- 收录时间
- —
- 更新时间
- 2026-10-08
01VoxMem是什么
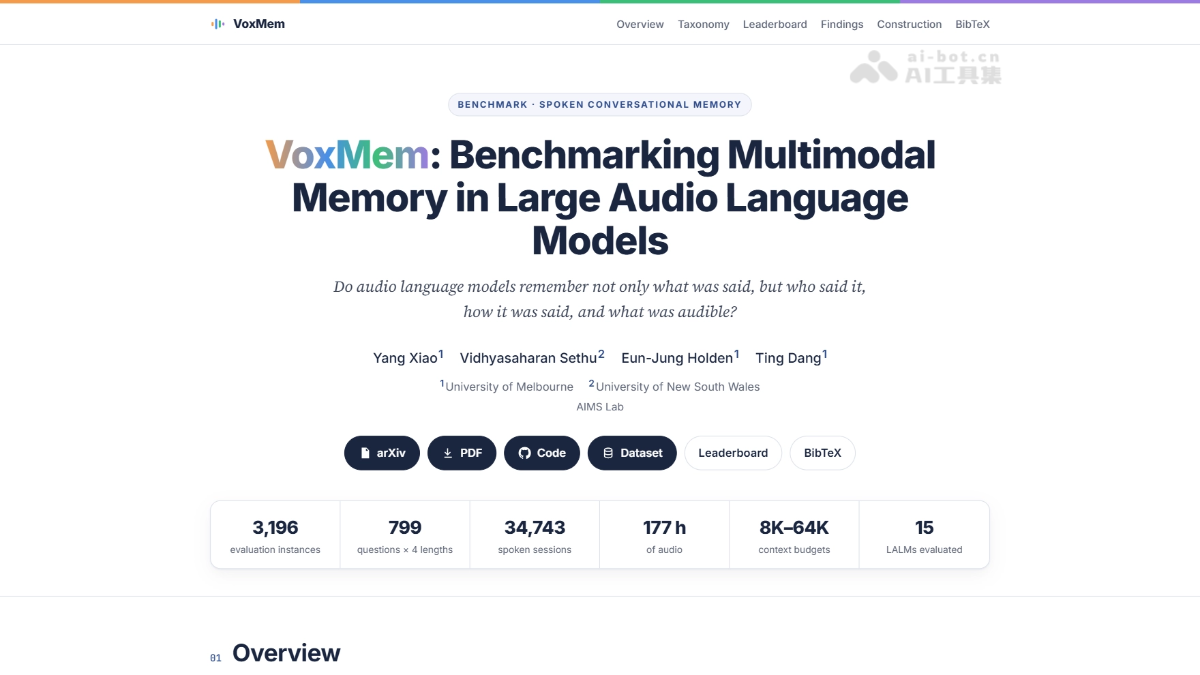
VoxMem是墨尔本大学和新南威尔士大学团队推出的音频大模型记忆基准。首创4类声学证据,语义、说话人、语气、环境声 × 4 种记忆操作,抽取、跨会话推理、时序追踪、拒答的二维评测框架,覆盖8K至64K token多会话历史。对15个模型的测试显示,32K下无一模型整体准确率超过40%,模型能记住说了什么,却难以记住谁说的、怎么说的,仅靠延长音频上下文不足实现持久语音交互。
02VoxMem的主要功能
多会话语音记忆评测:在多会话、跨时长的语音历史设置下,系统测试大音频语言模型能否记住并回溯此前的对话内容。
四类声学证据覆盖:同时考察语音语义、说话人身份、副语言线索、环境声,后三类是转写无法恢复的”音频原生”信息。
四种记忆操作分类:涵盖信息抽取、多会话推理、时序演变追踪、证据不足时拒答,两两交叉形成15个有效评测单元格。
受控历史长度:同一道题在8K/16K/32K/64K token四种历史长度下证据完全不变,仅增加干扰会话,可单独剥离长度对记忆的影响。
开放评测体系:代码与数据全部开源,提供标准化运行、评分脚本和Leaderboard,支持接入API模型与本地模型复现。
03VoxMem的技术原理
微信关注回复“开源”,加入AI开源项目交流群
二维分类框架:VoxMem的核心设计是一张声学证据×记忆操作二维分类表。声学证据回答要记住什么,将语音信息拆为语义、说话人、副语言、环境声四类;记忆操作回答要怎么用,包括从单次会话取回信息(IE)、跨多次会话整合证据(MSR)、按时间顺序追踪状态演变(TET)、以及在证据不足时拒答(AR)。语义×IE组合因退化为纯文本检索被有意排除,剩下15个单元格构成完整评测空间,确保声学记忆能力被系统性而非零散地考察。
三阶段数据构造: 数据生成按”规划—写对话—语音合成”流水线进行:先为每道题生成结构化计划,规定问题、答案、证据分布及有效性约束(;再分别生成用户侧与助手侧对话文本,双方都不提及说话人、语气或背景声,防止答案从文字泄漏;最后用TTS合成语音,每位用户固定音色、通过风格控制注入语气线索、以10dB信噪比混入环境声,并为每个带线索的轮次保留去除线索的配对版本用于质检。
干扰会话与长度控制:每段历史由证据会话、干扰会话和填充会话组成。干扰会话与证据话题相近但取值不同,配合一个只看文本、准确率仅51–56%的分类器验证,确保模型无法靠表面话题匹配找到答案。长度控制上,四个长度档的历史严格嵌套,只用无关填充会话拉长历史,使问题、答案、证据在四档下完全一致,准确率变化只能归因于历史变长,排除题目难度混杂的干扰。
04如何使用VoxMem
克隆仓库:从 GitHub 拉取代码 git clone https://github.com/swagshaw/voxmem 并进入项目目录。
安装依赖:运行 pip install -r requirements.txt,可选装 pip install "datasets" 让音频自动解码为数组。
配置 API 密钥:如评测 API 模型,安装对应 SDK 并设置密钥,如 pip install openai 后 export OPENAI_API_KEY=。
跑冒烟测试:先用 python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl 验证流程,再用 score_voxmembench.py --judge exact-match 评分,确认拒答层在拒答题上得 1.0、可答题上得 0.0。
正式评测:选择配置(如 32k 完整集或 32k_speaker_information 子集)和目标模型运行,例如 python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl;本地模型需用 --adapter 指定自定义适配函数、--model-dir 指向权重目录。
LLM 裁判评分:运行 python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json,裁判只看问题、标准答案和回答,判定开放式答案等价性。
05VoxMem的核心优势
首个系统性覆盖音频原生记忆:突破现有基准只考词汇内容的局限,首次将谁说的、怎么说的、听到了什么等非文本声学信息纳入统一评测框架。
二维分类法设计严谨:以4类声学证据×4种记忆操作的15个有效单元格替代零散选题,使语音记忆能力可被全面、正交地拆解考察。
多会话设置贴近真实场景:模拟真人机语音交互中跨越时间的多次会话,非单段长独白,检验模型对反复出现说话人和状态更新的长期记忆。
长度效应完全解耦:同一道题在8K至64K四种历史长度下证据严格嵌套、保持不变,首次将”历史变长”的影响与题目难度、证据类型 cleanly 分离。
防泄漏构造与双重质检:对话双方均不提及声学线索、配对版本对照、两级质检剔除可纯靠转写作答的题,确保题目真正需要”听”而非”读”。
干扰设计难以投机:话题相近但取值不同的干扰会话配合仅51–56%准确率的文本分类器验证,堵死靠关键词匹配找答案的捷径。
06VoxMem的项目地址
项目官网:https://swagshaw.github.io/voxmem/
GitHub仓库:https://github.com/swagshaw/voxmem
HuggingFace模型库:https://huggingface.co/datasets/AudioMemory/voxmembench
arXiv技术论文:https://arxiv.org/pdf/2609.32607
07VoxMem的应用场景
语音助手/智能音箱长期记忆能力选型:厂商可用 VoxMem 统一测试候选模型能否跨会话记住用户偏好、家庭成员声音和之前的承诺,避免上线后”上周说过的话转头就忘”。
车载与可穿戴语音交互评测:车内环境声嘈杂、用户语气多变,VoxMem 的环境声和副语言线索维度可检验模型在真实噪声场景下的记忆可靠性。
多说话人客服与会议系统质检:客服中心、会议纪要等场景需要把”哪句话是谁说的”绑定正确,VoxMem 的说话人绑定错误归因可直接用于诊断此类系统的”张冠李戴”问题。
陪伴机器人/适老关怀产品的情绪记忆验证:老人上周叹气说的事、语气里透出的疲惫,只有副语言线索能承载,VoxMem 的时序追踪维度可检验产品能否察觉状态随时间的变化。
© 免责声明:鉴于域名具有时效性,指向的网站内容可能发生变更。AIEZZ对呈现的第三方网站不可控,无法承担任何责任。请自行判断内容风险。
用户评价0