
- 月流量
- 0
- 产品收费
- 未设置
- 收录时间
- —
- 更新时间
- 2026-09-17
01Spark-Audio-1.0-Preview是什么
Spark-Audio-1.0-Preview是科大讯飞推出的全国产语音基座大模型,采用0.65B音频编码器+30B-A3B MoE语言模型架构,用1300万小时音频及大量文本数据基于纯国产算力训练完成。模型能直接理解语音中的语义、情绪与场景,支持99种语言、202种方言识别及语音转写、翻译、说话人识别、情感分析、音频问答等任务,在高噪声、小音量等复杂场景表现领先,可广泛应用在客服、车载、医疗等场景。
02Spark-Audio-1.0-Preview的主要功能
语音转写:将语音直接转为文字,支持99种语言和202种方言识别。
多语言翻译:实现语音到语音/文本的跨语言翻译,保留语气语调等韵律信息。
多方言识别:覆盖202种方言,粤语、温州话等均能听懂。
环境音识别:能同时听懂人声与环境背景音,理解声音发生的场景。
说话人识别:自动区分谁在说话,适用于会议转写、纪要生成等。
情感分析:捕捉语音中的语气与情绪,让交互更”有温度”。
音频问答:基于复杂音频内容进行理解与问答,从”听清”走向”听懂”。
03Spark-Audio-1.0-Preview的技术原理
端到端语音理解架构:不同于传统”先转文字再交给大模型”的级联方案,模型采用0.65B音频编码器搭配30B-A3B大语言模型,文本与语音双模态直接输入同一模型,一次性听懂人声、环境音、音乐及其语义、情绪和场景,避免了级联链路中信息丢失和错误累积的问题。
音频编码器预训练:通过音频编码器预训练逐步扩展其表征能力,再用预训练和后训练提升模型基础能力、复杂场景泛化性及多任务效果,最终在高噪声、小音量等真实复杂场景下取得优异成绩。
全国产算力训练:模型基于纯国产算力集群,用1300万小时音频和大量文本数据训练完成,是业界首个基于全国产算力训练的语音基座大模型,证明了国产算力可训出业界领先水平的语音模型。
可微调的基座体系:类似讯飞星火大模型1+N体系,Spark-Audio作为语音基座可进一步微调,开发出语音识别、语音同传、语音交互等专用模型或系统,便于在各类语音业务中落地。
04如何使用Spark-Audio-1.0-Preview
打开官方体验页面:访问模型体验地址 https://iflytekresearch.iflytek.com/experience/spark-audio 。
在线体验模型能力:在页面上输入文本或语音,体验语音转写、翻译、方言识别、音频问答等功能。
05Spark-Audio-1.0-Preview的核心优势
全国产算力训练:业界首个基于纯国产算力集群训练的语音基座大模型,证明国产算力可训出业界领先水平模型。
端到端直接理解语音:摆脱”先转文字再理解”的级联方案,不丢失语气、情绪、环境音等关键信息,消除链路割裂与延迟卡顿。
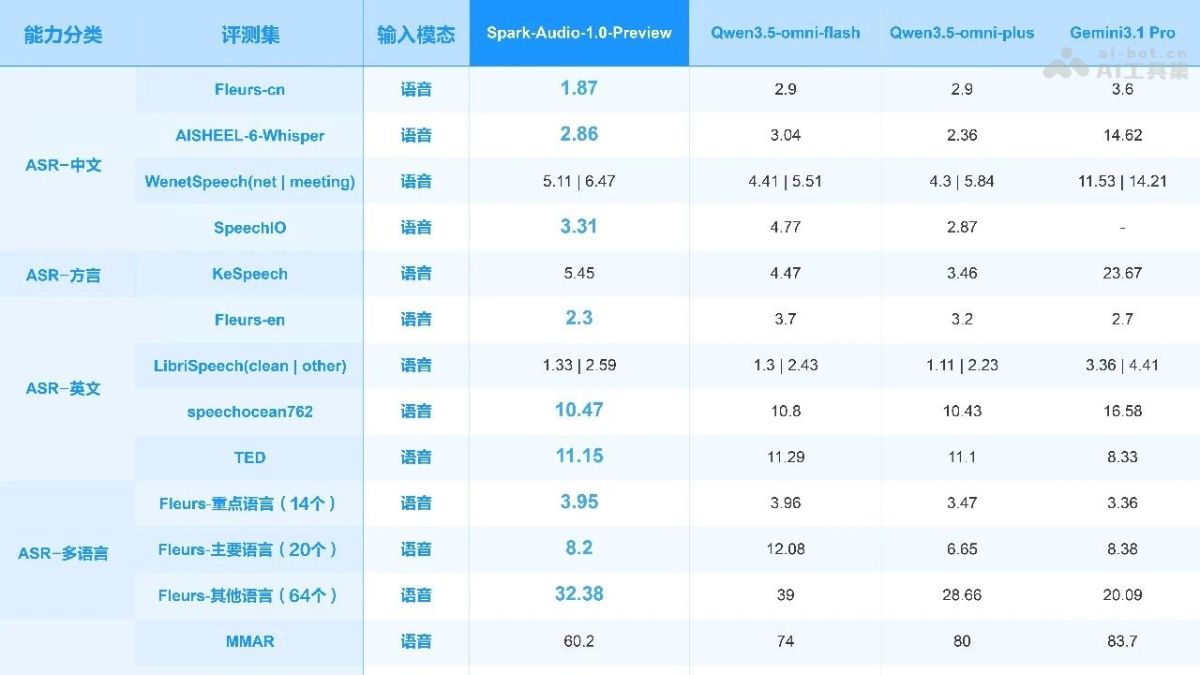
多语言多方言覆盖广:支持99种语言和202种方言识别,在同尺寸模型对比中多语言、多方言识别效果占优。
复杂场景表现领先:在高噪声、小音量等真实应用类任务上有明显领先优势,抗噪能力突出。
对标更大模型不落下风:与尺寸高一个数量级的Qwen3.5-omni-plus效果接近,Fleurs中文测试集取得SOTA,多项评测得分超过Gemini-3.1 Pro。
文本能力不降智:在通用知识、数学与代码等文本任务上未出现明显降智,克服了语音基座模型的常见难点。
架构高效:采用0.65B音频编码器+30B-A3B MoE架构,小尺寸实现接近更大闭源模型的表现。
06Spark-Audio-1.0-Preview的应用场景
智能客服:识别用户的情绪和表达方式,让对话更连贯、更有温度,提升服务体验。
汽车座舱:在车载嘈杂环境中准确识别驾驶员指令,支持方言交互,打造更自然的车内语音交互体验。
实时翻译与跨语言会议:进行语音同传和多语言翻译,同时保留语气、语调等韵律信息,带来更自然的跨语言交流体验。
会议转写与纪要生成:自动区分说话人、提取关键决策点,并生成结构化纪要,帮助工作人员减少重复整理工作。
医疗电子病历与内容审核:通过语音完成病历记录与内容审核,在医疗等专业场景中降低人工录入负担、提高效率。
© 免责声明:鉴于域名具有时效性,指向的网站内容可能发生变更。AIEZZ对呈现的第三方网站不可控,无法承担任何责任。请自行判断内容风险。
用户评价0