

AnyJev 的功能
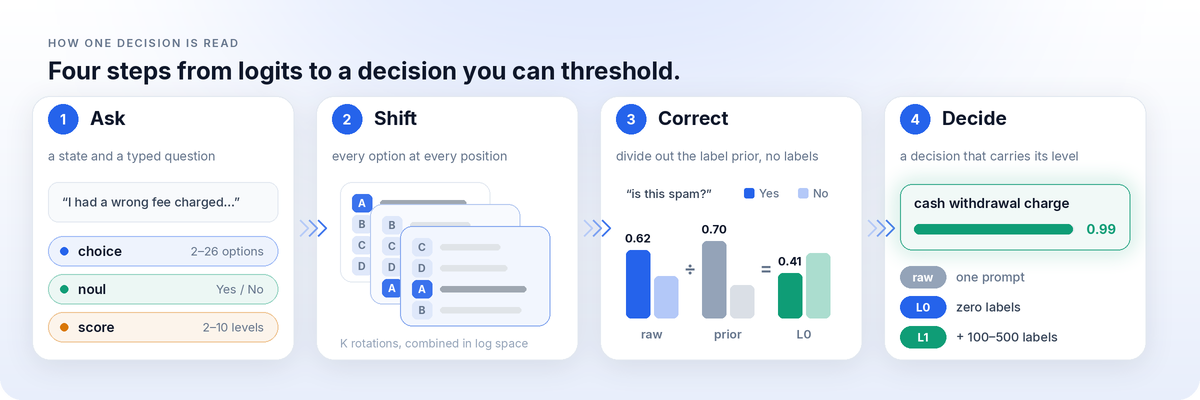
AnyJev 将开放式语言模型转换为 Jev 风格的决策模型。AnyJev 不会要求模型生成答案后再解析文本,而是读取模型在预填充阶段的下一个 token 分布,并返回带类型的决策及其概率。
这适用于请求路由、评估某项操作是否存在风险,或对任务完成度进行评分等工作流。每个结果都会记录所使用的决策级别,使下游代码能够区分未校准或零标签的结果,以及由已拟合决策头生成的结果。
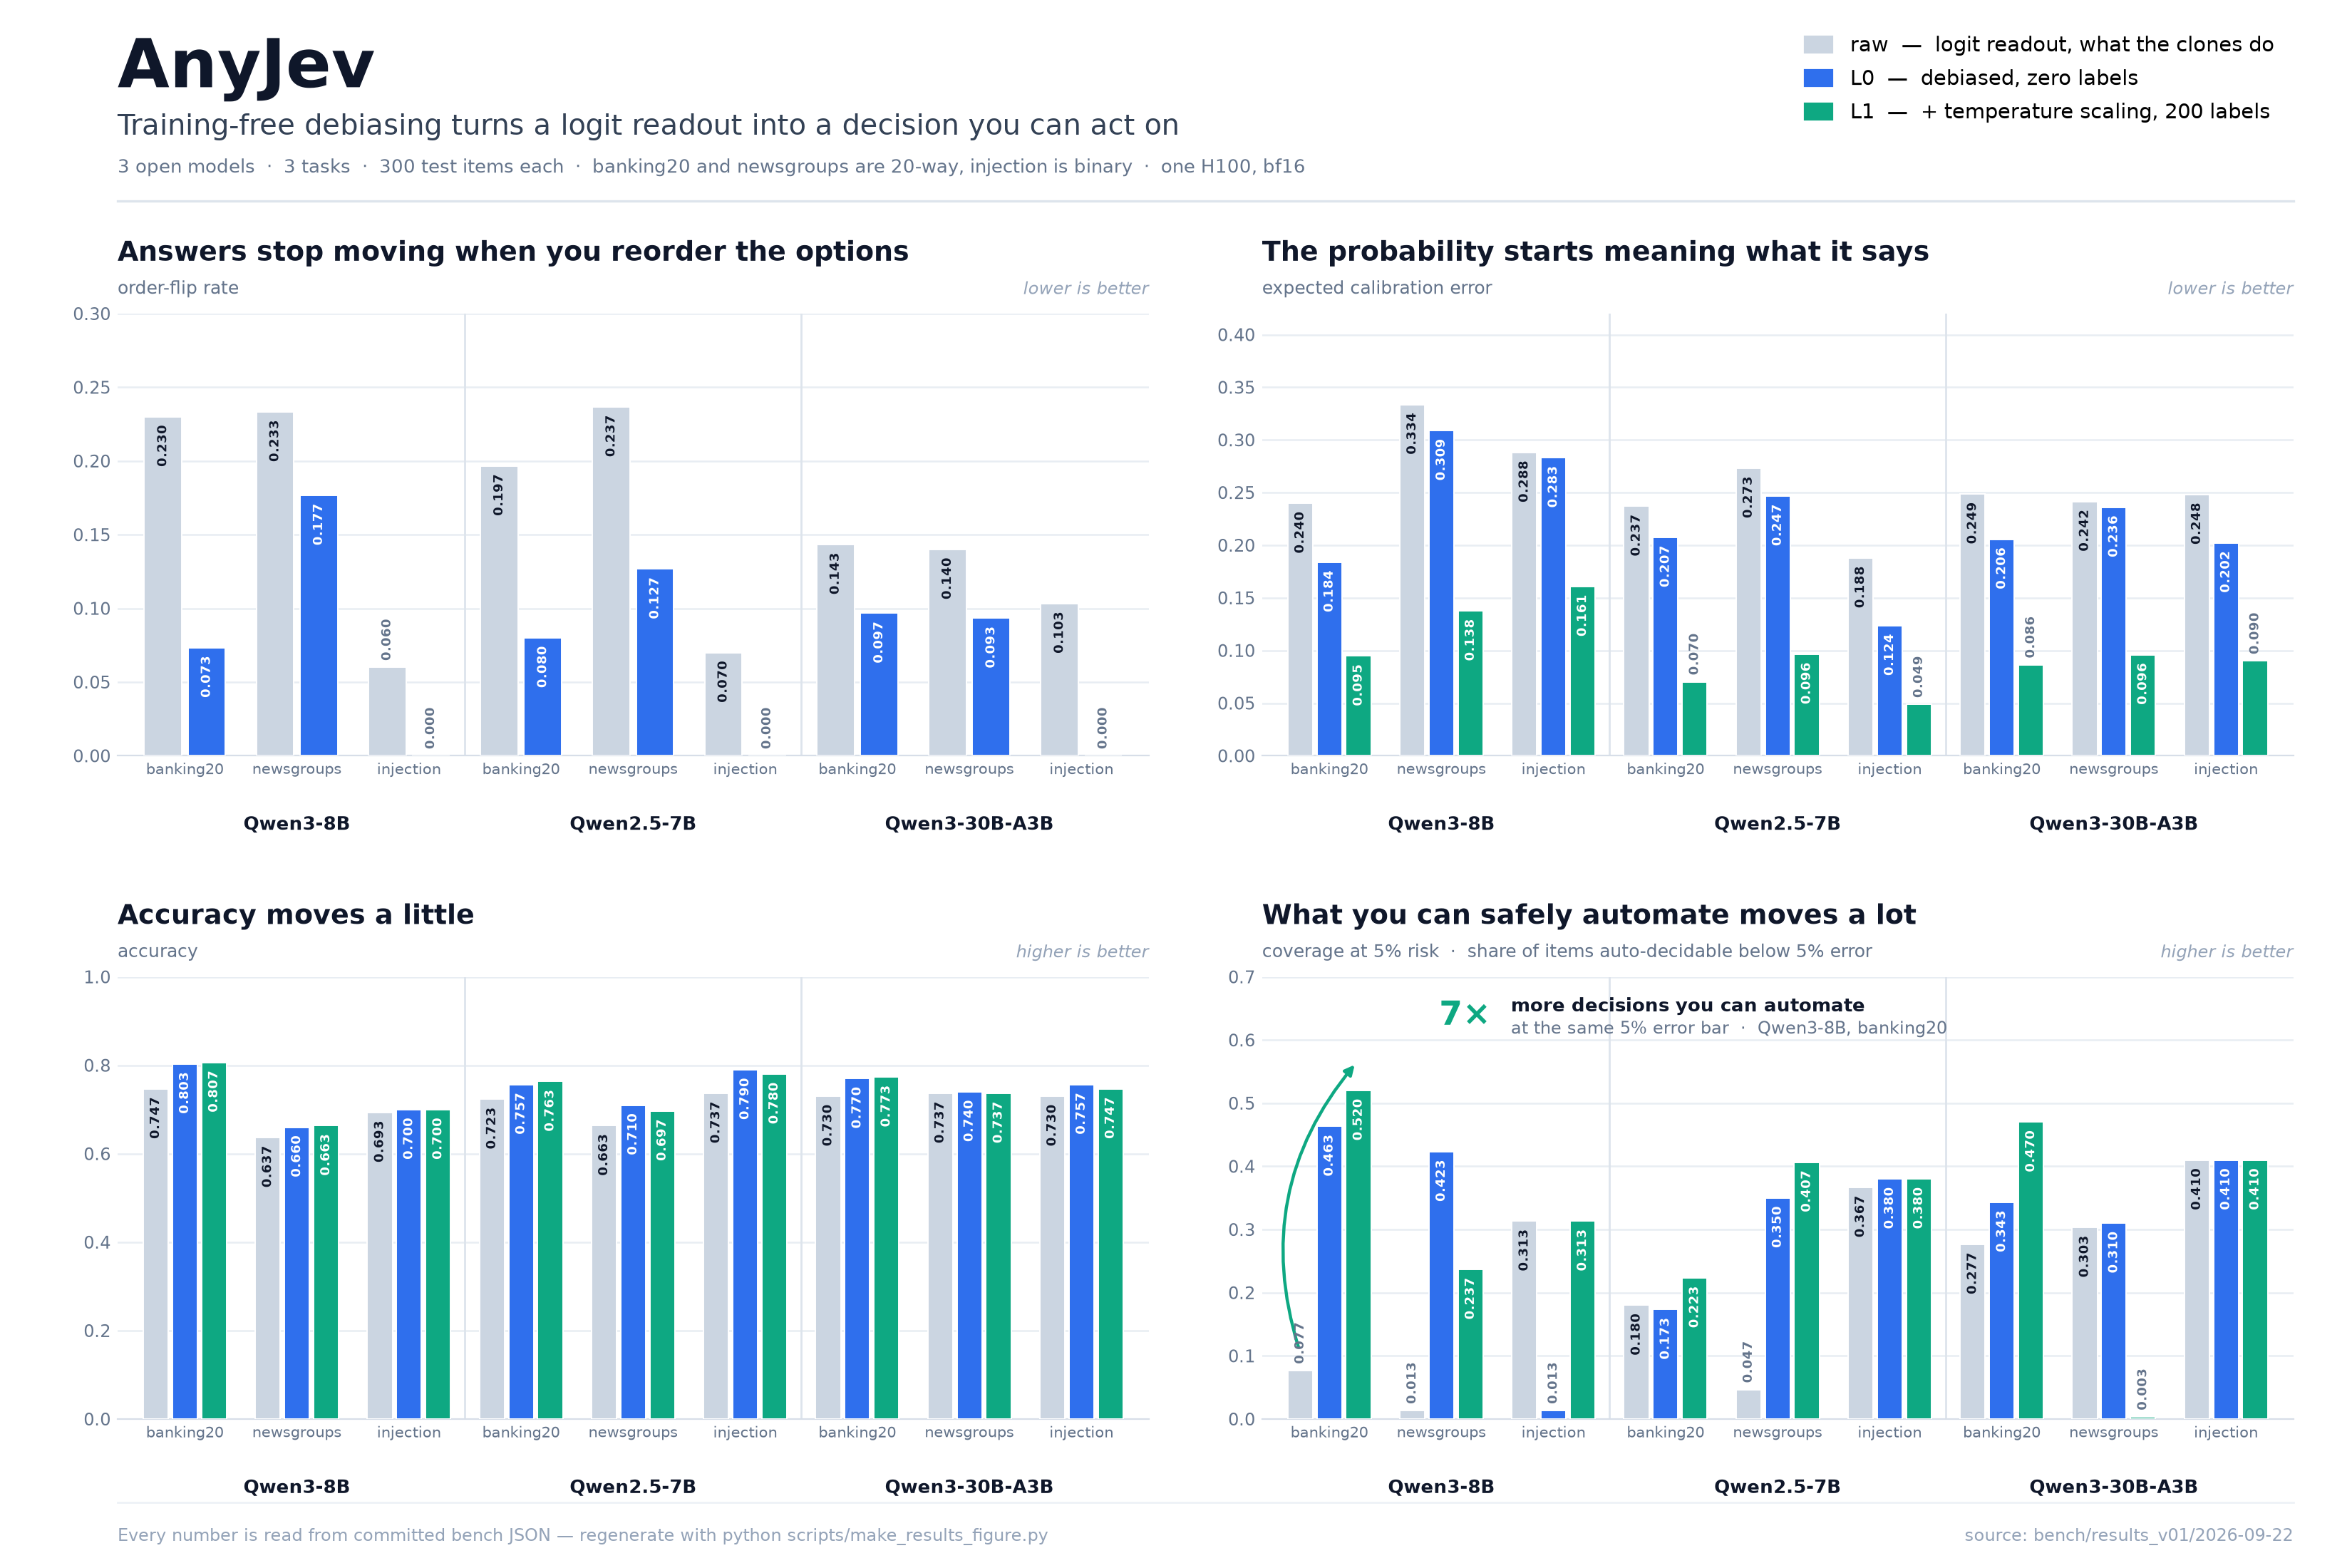
AnyJev 解决了原始 logits 带来的两个实际问题:选项顺序变化可能导致预测变化,而原始置信度可能没有经过充分校准,无法可靠地用于基于阈值的自动化。在 README 的 Qwen3-8B BANKING77 实验中,L0 在没有标签的情况下将选项顺序翻转率从 0.230 降至 0.073。使用带标签示例时,L1 将预期校准误差从 0.240 降至 0.095。
决策级别
AnyJev 提供多个决策级别,各自具有不同的数据和服务要求:
- raw:对标签 token 应用受限 softmax。不修正位置偏差,也不校准置信度。
- L0:无需标签。评估选项的循环排列,平均消除位置偏差,并除以估计的标签先验。
- L1:每个问题使用约 100–500 个标签拟合基于 L0 的温度缩放。它可以改善校准,但不会改变排序。
- L2:每个问题使用约 100–300 个标签,从中间隐藏状态求解收缩 LDA 或 ridge 决策头。它需要本地模型,并且同时针对特定模型和问题。
对于多选项决策,L0 需要执行多次预填充,因为它会评估不同的循环排列。相比之下,L2 只使用一个提示,并在固定的中间层停止,因此在报告的 Qwen3 实验中,其成本低于完整前向传播。
主要功能
- 支持带类型的
choice、noul和score问题。 - 无需文本生成或答案解析。
- 无需标签的 L0 修正,用于处理选项位置和标签先验的影响。
- 使用数百个标签进行 L1 温度校准。
- L2 闭式决策头可在数秒内拟合,无需梯度或模型微调。
- 通过
level="auto"自动选择 L2、L1 或 L0。 - 使用
observe增量收集标签。 - 针对多个状态和同一问题进行批量决策。
- 可保存并加载的小型 JSON 工件,便于后续服务。
安装与设置
安装 Hugging Face 后端
安装带 Hugging Face 集成的 AnyJev:
pip install "anyjev[hf]"当前版本通过基于 Transformers 的 anyjev.backends.hf 后端提供所有决策级别。vLLM 和 SGLang 支持已列入路线图,目前版本尚不可用。
创建决策器
导入核心 API,并使用开放模型初始化 HFBackend:
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

decider = Decider(HFBackend("Qwen/Qwen3-8B"))
随附的 L2 决策头覆盖五个 Qwen3 模型:1.7B、4B、8B、30B-A3B 和 32B。L2 决策头始终针对其基础模型和问题,因此为某个模型或问题拟合的决策头不能自动复用于其他模型或问题。
定义带类型的问题
问题描述输出类型、有效响应和稳定名称。你可以针对同一个应用状态评估多个问题类型。
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route",
)

risky = Question.noul(
    "Is this tool call destructive or irreversible?",
    name="risky",
)

done = Question.score(
    "How complete is the task?",
    bins=5,
    name="done",
)
使用 choice 表示分类决策,使用 noul 表示真值或假值决策,使用 score 表示分箱数值评分。字母 token 读取目前最多支持 26 个选项。
进行基本的 L0 决策
L0 是默认级别,无需带标签示例。构造包含问题所需信息的状态,然后调用 decide:
state = {
    "conversation": [
        {"role": "user", "content": "I was charged twice."}
    ],
    "tool_call": {
        "name": "refund_payment",
        "arguments": {"payment_id": "pay_123"},
    },
}

result = decider.decide(state, [route, risky, done])

print(result["route"].distribution)
print(result["risky"].p_true)
print(result["done"].value)
print(result.level)
一个典型的路由分布可能会将每个给定选项映射到一个概率。布尔决策会提供 p_true,而评分决策会提供 value。当没有更高级别的工件可用时,整体结果会报告 L0。
概率应根据其所属级别进行解读。L0 可以提高稳定性并修正估计的标签偏差,但不能使不确定性得到完全校准。
添加 L1 校准
如果某个问题有大约 100–500 个带标签的状态,可以调用 calibrate 来拟合 L1 温度:
decider.calibrate(risky, states, labels)L1 会校准基于 L0 生成的概率。它不会改变排名第一的答案,但可以让置信度阈值更具实际意义。
拟合 L2 闭式决策头
为了获得更高的准确率,请使用约 100–300 个带标签示例拟合特定问题的 L2 头:
decider.fit_head(route, states, labels)

decider.save_artifacts("qwen3-8b.json")
拟合过程会对示例执行一次模型前向计算,然后以闭式形式求解决策头。它不使用梯度,也不会改变语言模型的权重。根据项目说明,一个决策头通常约为 100 KB,在较小的受支持 Qwen3 模型上可在几秒内求解。
在后续进程中加载保存的构件,然后请求自动级别选择:
decider.load_artifacts("qwen3-8b.json")

result = decider.decide(state, [route], level="auto")
print(result["route"].level)
使用 level="auto" 时,如果兼容的决策头能够处理该问题的路由,AnyJev 会使用 L2。否则,在存在校准结果时回退到 L1,最后回退到 L0。
增量收集标签
AnyJev 可以接收来自审核队列、观测结果或其他反馈来源的实时标签:
decider.observe(route, state, correct_label)项目的自动循环会在收到 30 条观测时求解决策头,并在 60、120 条以及后续里程碑处重新解析。这支持这样一种部署生命周期:新问题从 L0 开始,在积累足够反馈后升级到 L2。
批量推理
将同一个问题应用于多个状态时,请使用批量 API,而不是反复调用 decide:
results = decider.decide_batch(states, route)这是针对单个类型化问题处理多个输入的预期接口。
试用打包演示
从仓库检出目录运行无需下载模型的合成演示:
python -m demo.jev_mode --backend fake要模拟部署生命周期,请添加生命周期选项:
python -m demo.jev_mode --backend fake --lifecycle移除 --backend fake,即可运行使用随附决策头的真实 Qwen3 演示。
高级部署技巧
保持问题标识稳定
L2 按问题和模型分别拟合。新的选项集需要新的标签和新的决策头。重新措辞同一个问题,或更改相同选项的顺序,可能会路由到现有决策头。
使用无标签流量适应措辞
对于重新措辞的问题,AnyJev 可以使用约 30 个无标签请求重新调整决策头的特征均值和尺度。这种适应针对问题措辞和选项顺序,不会检测应用状态本身的变化。
监控真实数据漂移
由于状态分布变化对重新调整机制不可见,请保留一个定期标注的评估切片并抽查性能。不要将措辞适应视为生产监控的替代方案。
按决策级别控制操作
每个决策都会携带其级别。下游系统可以在执行敏感操作前检查该级别,项目也支持使用 require= 强制执行级别。这可以防止原本为已校准或 L2 决策设计的工作流无提示地执行回退结果。
仅在验证后选择阈值
校准的主要优势是能够将高置信度案例交给自动化处理,同时升级不确定案例。请在具有代表性的带标签数据上选择阈值,并测量由此产生的错误率和覆盖率,不要想当然地认为显示的概率天然可信。
重要限制
- L2 决策头不能迁移到不同的问题或基础模型。
- 当前项目版本仅随附 Qwen3 决策头。
- L2 需要访问隐藏状态,目前通过 Transformers 后端提供。
- 校准无法让模型解决其根本无法回答的任务。
- 当某个标签在批次先验中占据明显优势时,L0 可能会降低准确率。
- 当前的字母读出最多支持 26 个选项。
- 报告中的 5% 风险覆盖率估计基于 300 个示例,因此方差较高。
- 发布的类型化决策准确率衡量的是与教师 LLM 的一致性,而不是独立建立的真实标签。
- 报告中的决策是在隔离状态下评估的,而不是在完整的智能体循环中评估的。
结论
AnyJev 提供了一条实用路径,可从零标签的类型化决策逐步过渡到校准概率和高效的隐藏状态决策头。先从 L0 开始,收集真实标签;当校准是重点时加入 L1;当需要更准确的特定问题决策路径时拟合 L2。保留报告的级别,验证阈值,并在生产数据变化时监控带标签样本。
有关实现细节和当前计划,请参阅 AnyJev 仓库、级别契约、基准测试文档和路线图。