

Jeff 是什么?
Jeff 是一系列紧凑型 Qwen3.5 和 Gemma 4 微调模型,专为快速零样本分类而设计。你提供一个自然语言描述的情境,定义可用选项,即可通过一次前向推理获得每个选项经过校准的概率。
与传统生成模型不同,Jeff 不会生成需要由应用解析的长篇文本。它旨在直接为支持路由、意图检测、内容审核、语音命令和游戏操作等任务做出决策。只要清晰描述类别,它们无需出现在模型的训练数据中。
Jeff 使用与 Jev 相同的请求格式,但它是一个独立项目,与 TypeSafe 没有关联,也未得到 TypeSafe 的认可。其训练代码基于开源的 AutoJev 方案。
主要功能
- 快速本地推理:根据报告中的基准测试,使用 MLX 时,Jeff-Qwen3.5-0.8B 在 RTX PRO 6000 上每次决策约需 22 毫秒,在 Apple M4 Max 上约需 28 毫秒。
- 经过校准的输出:每次决策都包含概率、选定选项和置信度。
- 零样本类别:选项在请求时描述,而不是限制为固定的标签集合。
- 三种问题类型:使用
choice、noul或score类型的问题。 - 请求批处理:可以同时回答关于同一状态的多个独立问题。
- 本地后端:可在 NVIDIA GPU 或 CPU 上使用 PyTorch 运行,也可以在 Apple silicon 上使用 MLX 和 Qwen 模型运行。
- 领域适配:当零样本性能不足时,可以微调 Jeff 检查点。
选择模型
Jeff 在 Hugging Face 上提供三个模型检查点:
- Jeff-Qwen3.5-0.8B:一个拥有 8 亿参数、16 位权重大小为 1.7 GB 的模型。它是快速选择选项时推荐的平衡点。
- Jeff-Qwen3.5-2B:一个拥有 20 亿参数、16 位权重大小为 4.2 GB 的模型。在报告的基准测试面板中,它的总体得分更高,但速度更慢,也更为谨慎。
- Jeff-Gemma4-E2B:一个拥有 20 亿有效参数、46 亿存储参数、16 位权重大小为 9.3 GB 的模型。该项目的 MLX 后端仅支持 Qwen 模型。
首次部署时,请从 Jeff-Qwen3.5-0.8B 开始。只有在应用中的代表性示例上完成评估后,再考虑切换到其他检查点。
安装并下载 Jeff
该仓库使用 uv 同步依赖并运行命令。在项目目录中,安装默认依赖并下载 0.8B 检查点:
uv sync
uv run hf download mstrasser/Jeff-Qwen3.5-0.8B --local-dir checkpoints/jeff-0.8b
检查点将放置在 checkpoints/jeff-0.8b 中。如果要使用其他已发布模型,可以替换 Hugging Face 仓库和本地目录。
使用 PyTorch 提供服务
对于 NVIDIA GPU 或 CPU,使用默认的 PyTorch 后端启动服务器:
JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serve使用 MLX 在 Apple silicon 上提供服务
在兼容的 Mac 上,安装额外的 Mac 依赖并选择 MLX 后端。MLX 服务支持 Qwen 检查点:
uv sync --extra mac
JEFF_BACKEND=mlx JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serve
这两个命令都会在本地的 8765 端口上提供服务。
发送你的第一个分类请求
请求包含描述情境的 state,以及定义一个或多个决策的 questions 对象。以下示例要求 Jeff 对客户消息进行路由,并独立判断客户是否生气:
curl -s localhost:8765/v1/systemone \
  -H 'content-type: application/json' \
  -d '{
    "model": "jeff-latest",
    "state": "退款请求:客户表示包裹到达时已被压坏,并希望拿回款项。",
    "questions": {
      "route": {
        "type": "choice",
        "instructions": "哪个团队应该处理此事?",
        "criteria": {
          "1": "退款与付款",
          "2": "包裹损坏或丢失",
          "3": "账户与登录问题"
        }
      },
      "angry": {
        "type": "noul",
        "instructions": "客户是否生气?"
      }
    }
  }'
Jeff 会在一次请求中评估这两个问题。每个答案都会提供概率、选定选项和置信度值。你的应用可以直接使用选定的答案,也可以应用自己的置信度阈值。
了解问题类型
Choice
choice 问题会从最多 255 个选项中选择一个。将简短标识符放入 criteria,并使用对应的值解释选项含义。
"route": {
  "type": "choice",
  "instructions": "哪个团队应该处理此事?",
  "criteria": {
    "1": "退款与付款",
    "2": "包裹损坏或丢失",
    "3": "账户与登录问题"
  }
}
Noul
noul 问题表示一个以概率形式返回的是非决策。它适用于判断消息是否愤怒、紧急、不安全或相关等检查。
"angry": {
  "type": "noul",
  "instructions": "Is the customer angry?"
}
分数
score 问题会将答案放在由你描述的量表上。当应用需要分级评估而不是分类标签时,可以使用它。
编写有效的决策提示词
提示词措辞会显著影响小型分类器的表现。在使用 Jeff 时,以下实践尤其重要。
- 在代码中推理,再交给 Jeff 决策。在应用中计算确定性规则、未来状态和多步后果。将计算出的情境交给 Jeff,由它做出最终判断。
- 直接描述后果。不要要求模型预测汽车会在两回合后到达,而应直接说明某个特定动作会导致被汽车撞到。
- 保持选项描述一致。选项应采用相似的结构和可比较的详细程度。不一致的措辞可能使决策产生偏差。
- 使用简短的选项键。优先使用
{"1": "Engagement letter"},而不是冗长的内部标识符。过长的键会增加处理成本,却不会改善选项描述。 - 合并相互独立的问题。如果多个决策共享同一状态,应在一个请求中发送,而不是重复输入。
- 测试具有代表性的数据。基准测试结果可以提供有用的背景信息,但不能保证在特定工作流中达到同样的表现。
Jeff 是分类器,而不是规划器。当你的代码准备好相关事实,再由模型从清晰描述的备选方案中进行选择时,它的效果最好。
性能与局限
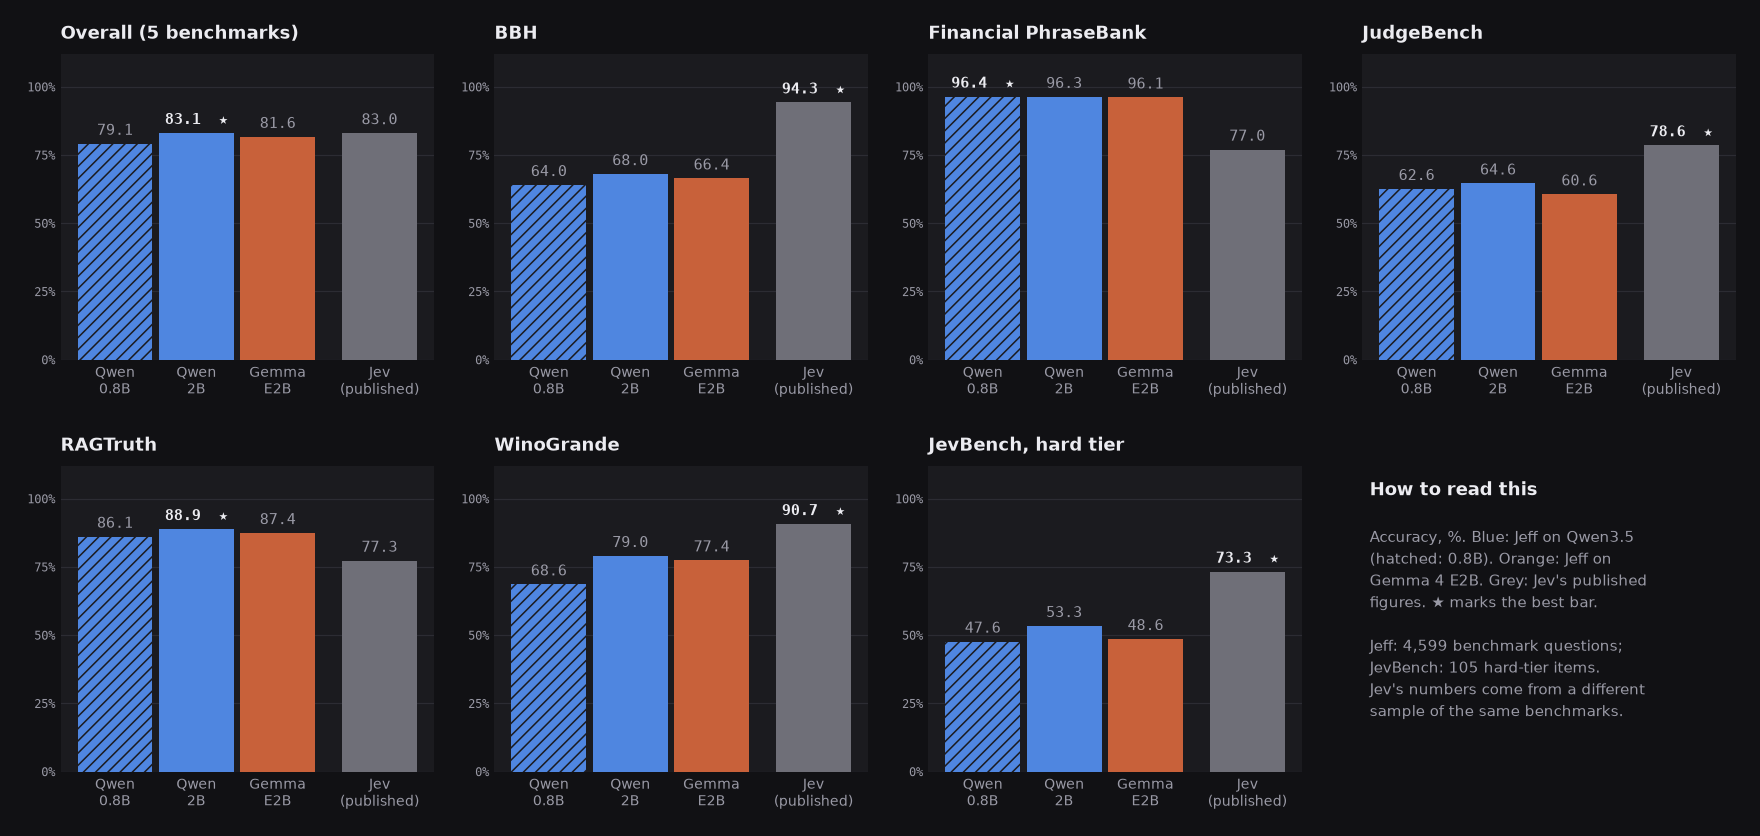
在五项公开基准测试中,Jeff-Qwen3.5-0.8B 得分为 79.1,Jeff-Qwen3.5-2B 得分为 83.1,Jeff-Gemma4-E2B 得分为 81.6,这是项目评估中的结果。Qwen 2B 的结果接近 Jev 公布的 83.0 总体得分,不过 Jev 和 AutoJev 的数据来自这些基准测试中的不同样本。
结果会因任务而有显著差异。Jeff 在多项分类和落地评估中表现强劲,包括 Financial PhraseBank 和 RAGTruth,但在 BBH、JudgeBench 以及 JevBench 困难等级等推理密集型基准测试中,仍低于更大型的系统。
对于约 200 个 token 的输入,报告的推理时间中位数为:在 RTX PRO 6000 上 22 ms,在使用 MLX 的 M4 Max 上 28 ms,在 32 线程 CPU 上运行 0.8B 模型时为 463 ms。这些数字取决于硬件,应在你自己的部署环境中重新测量。
尝试游戏测试框架
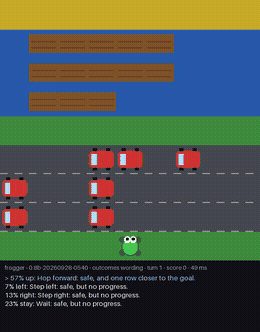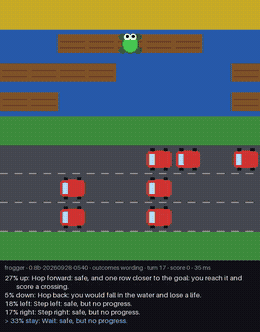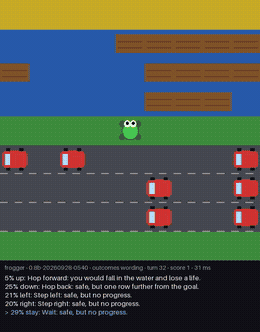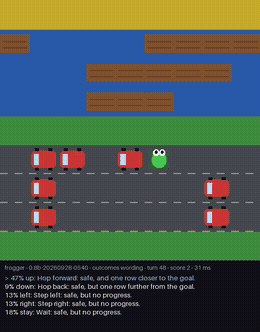
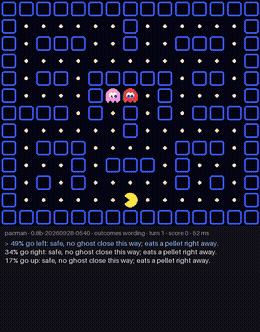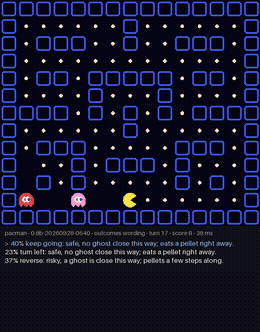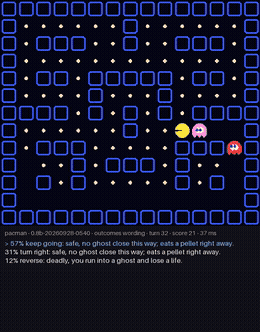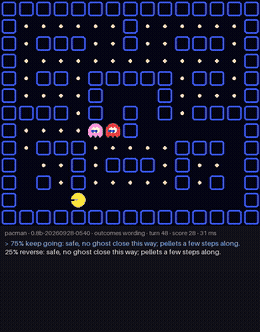
该仓库包含 Doom、Frogger 和 Pac-Man 实验,用于演示如何根据动态描述的合法移动做出决策。运行这些实验前,请先安装可选的游戏依赖:
uv sync --extra games在 Jeff 服务器已经运行的情况下,可以启动提供的 Doom 和 Frogger 评估:
uv run python -m jeff.games --game doom --player jeff --criteria situation --url http://127.0.0.1:8765 --video --out runs/games/doom.json
uv run python -m jeff.games --game frogger --player jeff --criteria outcomes --url http://127.0.0.1:8765 --out runs/games/frogger.json
你也可以运行基于规则的 Pac-Man 玩家进行比较:
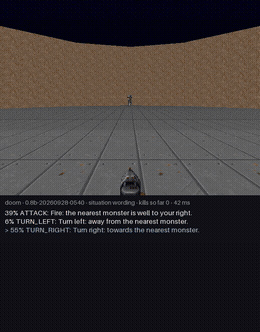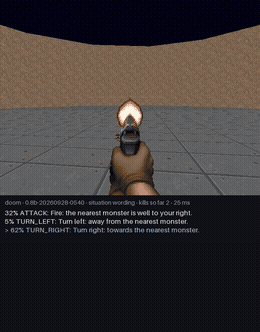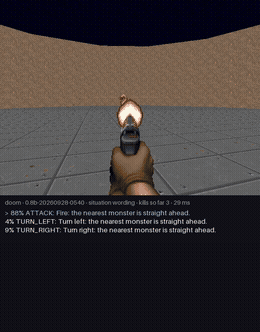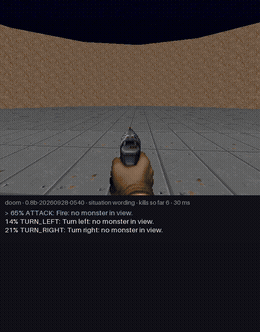
uv run python -m jeff.games --game pacman --player rule --out runs/games/pacman-rule.json这些实验还说明了一个重要局限:基准测试排名不一定能预测交互式游戏表现。在公布的结果中,尽管 2B Jeff 模型的综合基准得分更高,0.8B Jeff 模型仍在多种情况下取得了比 2B Jeff 模型更好的游戏表现。
针对你的领域微调 Jeff
如果零样本准确率不够理想,可以从 Jeff 检查点开始,使用应用中的示例进行训练。README 报告称,一次使用约 11,000 个应用专属示例进行的语音导航微调,在一块 GPU 上约半小时内,将留出集准确率从 31.7% 提高到了 95.8%。
autojev-train --initial-checkpoint <jeff> --epochs 1 ...该仓库还提供了更完整的训练工作流。典型流程是构建数据混合集、运行训练,然后评估选定的检查点:
uv run autojev-mix ...
scripts/train.sh RUN data/mix/public.jsonl data/mix 5e-6 40 Qwen/Qwen3.5-0.8B <revision> --epochs 1
uv run autojev-evaluate --data data/panel.jsonl --local --checkpoint checkpoints/RUN/selected --output runs/eval/RUN.json
公布的方案使用完整权重微调,训练一个 epoch,批大小为 256,在选项字母上计算交叉熵,并使用拟合温度进行概率校准。检查点依据开发集而不是基准测试面板进行选择。
有关完整的本地合成数据管道、数据泄漏过滤、学习率扫描和仪表板工作流,请参阅 scripts/train_all.sh。项目在 docs/data-sources.md 中记录了训练数据来源及其许可证。
高级部署技巧
- 使用自己的数据进行测量校准。经过校准的通用模型仍可能需要针对具体应用设置升级或回退行为的阈值。
- 添加安全回退机制。当置信度过低时,将请求转交给人工、确定性规则或能力更强的模型。
- 保持状态简洁。提供决策所需的事实,避免无关文本干扰小型模型。
- 评估不同措辞。在确定生产环境架构前,比较多个一致的指令和标准表述。
- 根据实证选择模型。对于对延迟敏感的选项选择,可使用 0.8B 模型,但应在自己的验证集上测试所有合适的检查点。
- 遵守模态限制。根据 README,Jeff 仅支持英文文本。
结论
Jeff 为应用添加快速、本地化、基于概率的决策提供了一种实用方式,无需生成或解析自由文本。请从 Jeff-Qwen3.5-0.8B 开始,清晰描述每个选项,将相互独立的问题合并到一个请求中,并使用真实的应用示例进行评估。如果零样本行为不足,可使用特定领域的数据对现有 Jeff 检查点进行微调。