

什么是 AIBuildAI LLM-Post-Train Agent?
AIBuildAI LLM-Post-Train Agent 是一种递归式自我改进智能体,用于自动化、定制化地对大型语言模型进行后训练。它不会采用单一固定的训练方案,而是研究任务、设计候选后训练算法、收集并整理训练数据、编写代码、运行实验、评估结果,并持续迭代改进模型。
该仓库包含运行、阅读和修改此智能体所需的源代码,面向需要根据私有数据、模型系列、评估流程和部署目标定制后训练策略的组织与研究人员。
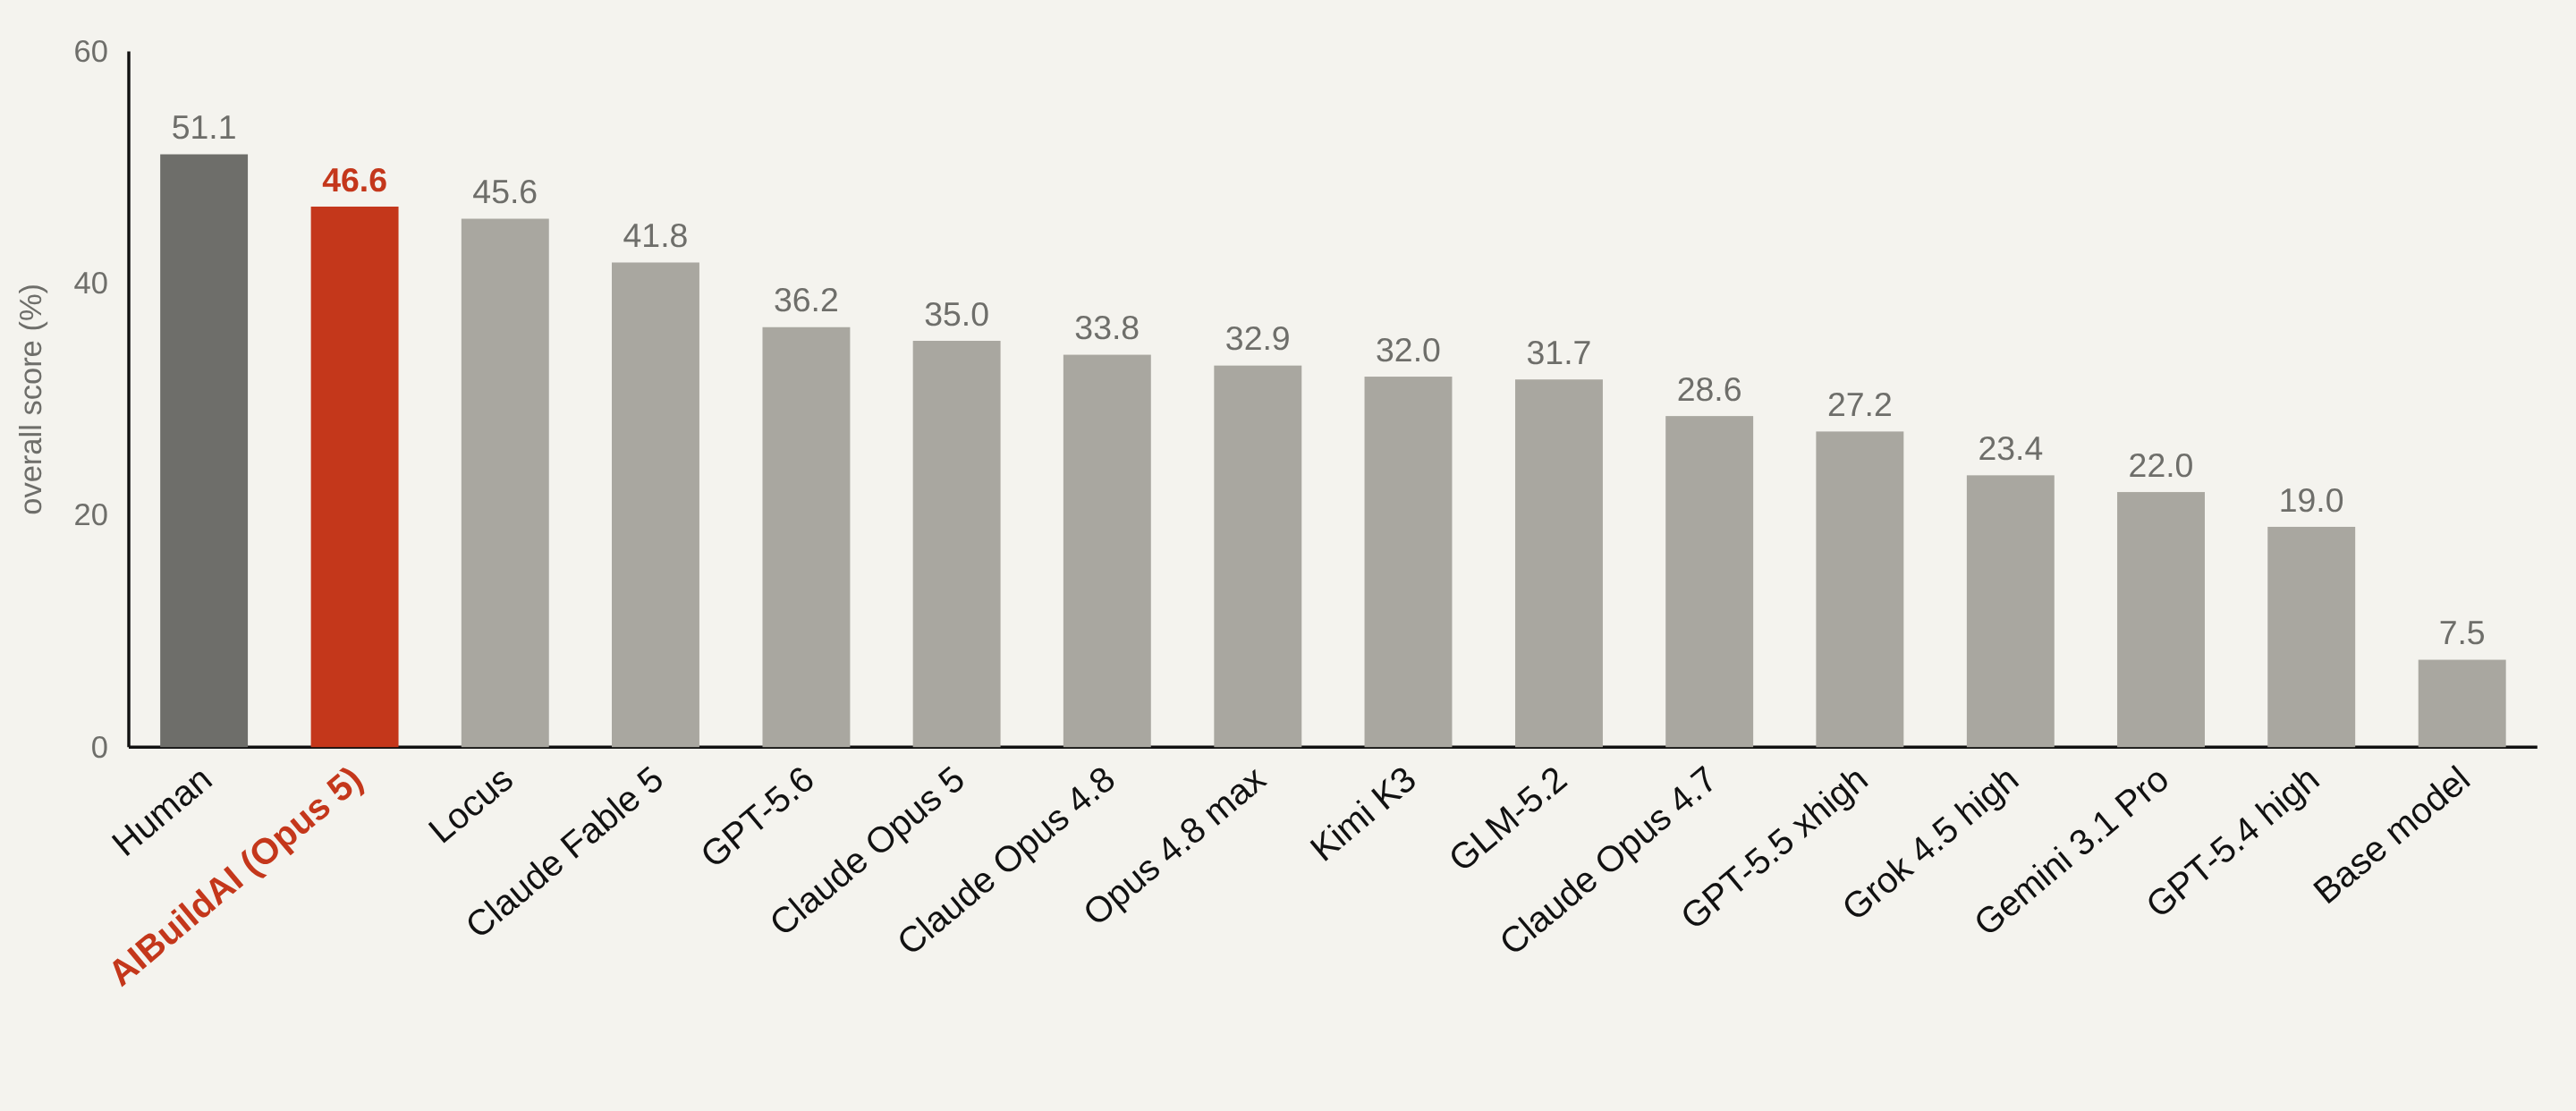
在 PostTrainBench 中,该项目取得了 46.6% 的总分,在受评估的模型和智能体中排名第一,仅次于 51.1% 的人类专家基线。
智能体的工作方式
一次运行从任务和评分流程开始。系统准备冻结的任务描述,建立基线,启动实验,使用同一个评分程序为每个完成的候选方案打分,并将最佳结果转化为可交付成果。
以下两项能力使该系统区别于通用编码智能体:
- 知识系统:智能体可以通过 MCP 查询 AIBuildAI Knowledge Base。其中整理的技能文档涵盖后训练工作流、方法、数据集和框架。
- 元搜索:元智能体可以研究任务并编写任务专用的搜索程序,而不是执行预先确定的实验拓扑。
每次运行还会获得一个实时 Web 工作区、持久化执行图、带日志记录的工作单元、沙箱化子进程以及资源控制。运行事件存储在 ~/.aibuildai/postgresql 下的私有 PostgreSQL 集群中,从而支持可恢复和可重放的执行。
主要功能
- 自动设计和执行 LLM 后训练实验。
- 面向任务的搜索策略,包括元搜索和多种固定搜索方法。
- 检索有关方法、数据集、框架和工作流决策的知识。
- 类型化智能体、确定性程序和嵌套搜索。
- 由任务定义评分,并以一致方式对候选方案排名。
- 通过本地工作区服务进行基于浏览器的实时监控。
- 使用 Bubblewrap 沙箱和 cgroup-v2 限制内存及进程。
- 根据历史运行在本地生成记忆。
- 聚合完成后可选择撰写论文并编译 PDF。
- 支持 Claude 以及通过兼容 Anthropic 的端点提供的其他模型。
系统要求
安装项目之前,请确认主机满足以下要求:
- 运行 Linux 的 x86_64 系统,并具有 systemd 用户会话。
- Python 3.11 至 3.13。
- 包含
gcc和make的 C 工具链。 - zlib 和 readline 开发头文件。
- 由
bubblewrap软件包提供的bwrap,并启用非特权用户命名空间。 - 可访问 GitHub releases 和
ftp.postgresql.org的网络。 - Claude Code 登录凭据、Anthropic API 密钥,或可通过兼容 Anthropic 的端点使用的其他模型。
- 建议使用 CUDA GPU,但智能体会检测并使用可用硬件。
首次运行时,系统会根据官方源代码压缩包构建私有 PostgreSQL 安装,还会将 ruff、tectonic、micromamba、caddy 和 PostgreSQL 等工具的固定版本副本下载到 ~/.cache/aibuildai。系统使用这些自有副本,而不是主机上安装的等效工具。
不需要 conda。智能体会使用自有的 micromamba 安装来创建 Program 环境。
检查 cgroup-v2 委派
一次运行受一个 cgroup-v2 树限制。systemd 用户管理器必须至少委派 memory 和 pids 控制器。使用以下命令检查当前配置:
U=$(id -u)
cat /sys/fs/cgroup/user.slice/user-$U.slice/user@$U.service/cgroup.subtree_control
输出应包含 memory 和 pids。如果缺少其中任意一个,管理员必须在 /etc/systemd/system/user@$U.service.d/ 下的 drop-in 文件中添加 Delegate=pids memory cpu,重新加载 systemd,并让你重新登录。
安装智能体
1. 安装操作系统软件包
在 Debian 或 Ubuntu 上,安装编译器、所需头文件和 bubblewrap:
sudo apt-get install build-essential zlib1g-dev libreadline-dev bubblewrap2. 克隆仓库
git clone https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent.git
cd aibuildai-llm-posttrain-agent
3. 创建 Python 虚拟环境
python -m venv .venv
source .venv/bin/activate
4. 安装固定版本的依赖
pip install -r requirements.lock
pip install -e . --no-deps
可编辑安装会提供 aibuildai 命令。请使用锁定文件,因为其中固定的 claude-agent-sdk 版本是针对该代码库验证过的版本。
如果计划修改仓库并运行其质量检查,还需安装开发依赖:
pip install -r requirements-dev.lock5. 可选:准备自有工具
这些工具可以在首次运行期间下载并构建。若要提前准备,请执行:
aibuildai setup配置模型访问
选项 1:使用 Claude Code 登录
claude auth login选项 2:提供 API 密钥
export AIBUILDAI_API_KEY=sk-ant-...如果未设置 AIBUILDAI_API_KEY,应用会先检查 ANTHROPIC_AUTH_TOKEN,然后检查 ANTHROPIC_API_KEY。
使用其他兼容 Anthropic 的端点
将 AIBUILDAI_BASE_URL 设置为该端点,并将其密钥放入 AIBUILDAI_API_KEY:
export AIBUILDAI_BASE_URL=https://openrouter.ai/api
export AIBUILDAI_API_KEY=your-key
export AIBUILDAI_SMALL_FAST_MODEL=provider/model-id
以 deepseek- 开头的裸模型标识符会自动指向 DeepSeek 的兼容 Anthropic 端点。OpenRouter 模型标识符包含提供商前缀,并且需要同时设置 AIBUILDAI_BASE_URL 和 AIBUILDAI_SMALL_FAST_MODEL。
如果端点对 Claude 模型层级使用不同的名称,请通过 AIBUILDAI_HAIKU_MODEL、AIBUILDAI_SONNET_MODEL 和 AIBUILDAI_OPUS_MODEL 进行映射。当子代理应运行与其角色配置模型不同的模型时,请使用 AIBUILDAI_SUBAGENT_MODEL。
可选服务设置
AIBUILDAI_KB_BASE_URL用于选择知识库 MCP 服务。默认情况下,客户端使用项目公开的固定快照。AIBUILDAI_KB_TOKEN用于在知识服务需要身份验证时提供 bearer 令牌。AIBUILDAI_WEB_PORT用于选择本地工作区服务端口。AIBUILDAI_WEB_NAME用于为同一主机上的第二个工作区服务命名,并且需要显式指定 Web 端口。
创建并启动基本运行
每次运行都由一个 YAML 文件描述。使用以下命令生成带文档的入门配置:
aibuildai config > task.yaml生成的文件包含每个配置字段、其默认值及相关文档。必需的顶层部分包括 run、llm、work_units、search 和 resources;入门配置会填充这些部分。
使用以下命令启动运行:
aibuildai run task.yaml该命令会输出类似 http://127.0.0.1:<port>/run/<run-id> 的工作区 URL。打开该 URL 即可实时跟踪运行状态。浏览器不是必需的,即使没有浏览器,执行也会正常继续。
运行 GSM8K 示例
随附的示例会对 Qwen/Qwen3-1.7B-Base 进行后训练,使其解决来自 GSM8K 的小学数学文字题。根据代码仓库说明,该示例在一块 GPU 上大约需要两小时。
1. 构建任务文件夹
bash examples/gsm8k-qwen3-1.7b-base/setup.sh ~/gsm8k-example该设置过程会下载约 4 GB 的数据,包括基础模型权重和 GSM8K 的两个数据划分。它会将任务说明和冻结的评分器写入 ~/gsm8k-example/task/,并为安装到运行自身 Program 环境中的软件包预热 pip 缓存。
生成的任务文件夹包含代理可以调优的基础权重、7,473 道训练题、评分器,以及由该评分器读取的 1,319 道测试题划分。
2. 开始后训练
aibuildai run ~/gsm8k-example/task.yaml该示例使用元搜索、90 分钟的探索时间上限,以及相应的每个代理预算。README 建议在正式运行时提高这些预算。
3. 了解评分契约
评分器完整定义了成功标准。它向模型提供一个问题及其后的答案前缀,采用贪婪解码,并提取最后一个 #### 后面的数字。README 报告称,基础模型在前 200 道测试题上的得分为 0.105,因为未经调优的基础模型最初不会遵循所要求的答案格式。
4. 评估最终模型
交付物是一个合并后的模型目录。将 <run-home> 替换为生成的运行目录名称,并使用运行的 Program 环境评估所有测试示例:
H=~/gsm8k-example/playground/gsm8k-qwen3-1.7b-base/<run-home>
$H/program-environment/env/bin/python ~/gsm8k-example/task/grade/evaluate.py --model-path $H/deliverable/final_model --limit -1
使用代理处理自己的任务
- 复制
examples/gsm8k-qwen3-1.7b-base.yaml,或使用aibuildai config生成完整的入门配置。 - 创建一个任务文件夹,包含运行可能使用的所有内容。
- 提供易于阅读的任务说明,例如 README、任务陈述或论文,并包含所有必需的数据文件。
- 将
run.data_root设置为该文件夹。 - 检查模型、搜索、预算、工作单元和资源设置。
- 使用
aibuildai run启动 YAML 文件。
在设置期间,系统会读取整个任务文件夹,将任务说明冻结为运行的 README,并据此构建运行的评分程序。因此,任务文件夹应当完整,并明确规定预期交付物和评估方法。
配置还支持 run.setup_from_scratch 和 run.task_prompt。这些设置允许 Setup 根据任务说明获取数据并执行评估,而不是从准备好的任务文件夹开始。
重要配置选项
模型选择
llm.default.model 用于选择代理使用的基础模型。可以通过 effort 和 max_thinking_tokens 等设置调整推理。使用 llm.by_role 可为各个角色固定模型,或使用 llm.auto 让路由器根据角色进行选择。
搜索方法
search.kind 控制实验策略。README 中描述的支持值包括:
meta:由元代理编写针对任务的搜索程序。nb_tree:对整个实验进行树搜索。nb。tree:通用 starter 中的默认值。linear。parallel。
search.input 的内容取决于所选策略。元搜索接受 report 选项,而固定策略使用各自的参数,并且可能包含 parallel 和 early_stopping。
时间和开支限制
run.budget.wall_clock_minutes 的默认值为 1,440 分钟。达到限制后不会开始新的探索,但正在进行的工作和交付流程可以完成。run.budget.cost_usd 提供可选的运行级软性开支限制。
work_units 下的每个条目都有自己的预算。工作单元可以使用固定分钟数、按深度缩放的时间,或带有余量的预计持续时间。
资源限制
使用 resources.work_unit.cpu_max_cores 和 resources.work_unit.memory_max_gb 可对每个工作单元施加硬性 CPU 和内存限制。每个单元都在 bubblewrap 沙箱中运行,并受到内存和进程数的 cgroup 限制,而任务文件夹以只读方式挂载。
高级提示
启用知识检索
需要让代理查阅 AIBuildAI Knowledge Base 时,添加 kb MCP 配置。客户端提供搜索技能、加载技能和阅读参考资料的工具。语料库包括工作流指南、方法卡片、数据集卡片和框架卡片。
默认公共服务使用固定的语料库快照。若要托管自己的版本,请部署开源知识库仓库,并将 AIBUILDAI_KB_BASE_URL 指向该仓库。
为特定任务的拓扑选择元搜索
固定树搜索无法自然表达所有工作流,例如先执行扫描再训练、随后进行锦标赛,或组合多个模型。使用 search.kind: meta 时,元代理会研究任务、运行试点、查阅随附的设计技能和知识库,并编写 Python 搜索包。
生成的包由三个基本原语组成:
- Agent: 配备工具、策略和类型化输出的 LLM 会话。
- Program: 在受管理的工作器中运行、具有专用资源限制的确定性计算。
- Search: 使用类型化输入和输出来生成并协调 Agent、Program 及嵌套 Search 的编排器。
该包会经过验证,也可以选择使用 LaTeX 设计报告进行审查。随后,它会作为子搜索在同一条带日志的运行中执行。无论采用何种拓扑,运行结果的价值始终是任意节点取得的最佳分数。
构建可复用的本地记忆
为某个任务积累多次运行后,将其中的经验整合到可编辑的本地记忆文档中:
aibuildai memorize task.yaml将 memory.enable 设为启用,可将该本地记忆注入每个代理。运行中学习的知识会保留在你的计算机上,不会添加到远程知识库。
控制外部工具
使用 disallowed_tools 可禁止所有角色使用指定的内置工具。例如,当评估规则要求离线工作流时,任务可以禁止使用 WebSearch 和 WebFetch。
添加 MCP 集成
mcps 配置可以启用知识库、Kaggle 竞赛提交或自定义 MCP 服务器。Kaggle 集成支持在 submission.max_submissions 下设置最大提交次数。
生成论文
启用 writer.enable 可在聚合后起草论文,也可以对已完成的运行目录执行论文命令:
aibuildai write-paper <run-dir>该命令根据已完成的运行起草论文,并将其编译为 PDF。
验证源代码更改
此项目版本不包含测试套件。其仓库门禁命令为:
./check.sh该门禁会运行 pyright、ruff、semgrep 和锁文件漂移检查。使用前请安装 requirements-dev.lock。
了解运行输出
每次运行都会在配置的 playground 根目录下创建一个主目录:
{playground_root}/<task-name>/<timestamp>_<run-id>/
  run_config.json
  public/
  private/
  deliverable/
  workspace/
  program-environment/
resource_samples.jsonlrun_config.json包含最终配置和用于恢复运行的运行 ID。public/包含冻结的 README 以及 Setup 为候选项准备的数据。private/包含评分程序、指标清单、基线尝试和获胜记录。deliverable/包含可运行的模型包或任务定义的其他结果。workspace/包含尝试、构件、临时数据和每个搜索的工作目录。program-environment/包含该运行隔离的 Program 环境。resource_samples.jsonl记录执行期间收集的主机资源测量值。
结论
AIBuildAI LLM-Post-Train Agent 提供了一套端到端系统,用于设计、运行、评估和改进模型后训练工作流。请先使用随附的 GSM8K 示例验证安装并了解运行结构。然后定义清晰的任务文件夹和评分器,选择合适的搜索策略,设置合理的预算和资源限制,并使用实时工作区跟踪生成的实验。
如需了解更深入的架构细节,请参阅仓库中的架构文档。本项目根据 Apache License 2.0 发布。