

Earshot 的功能
Earshot 是一款面向 AI 编程代理的本地音频分析与声音合成工具包。它将声音转换为结构化证据:自然语言描述、经过校准的匹配分数、带时间信息的事件、客观测量结果、可视化声音图表,以及发布影片评析。
它可以回答诸如某个音效是否听起来像深沉的机械按键声、长录音中特定事件发生的位置、两个候选声音有何差异,或配乐是否与画面剪辑同步等问题。它还可以通过 earshot forge 使用代码合成音效。
Earshot 可在 CPU 上本地运行,并提供命令行界面、Python API,以及可供 Claude Code 等工具使用的 MCP 服务器。完成初始模型下载后,其标准分析功能可离线运行。
主要功能
- 描述声音:
describe返回经过校准的标签、替代解释、AudioSet 标签和测量结果。 - 匹配并排序候选项:
match评估文件与描述的匹配程度,而rank则根据查询对多个文件进行排序。 - 查找事件:
find在较长录音中找出最匹配的时刻,并报告可直接用于剪辑的起止时间。 - 比较音频:
compare搜索参考录音,而ab解释两个声音或剪辑之间的差异。 - 评估真实感:
realness估计音频更像真实录音或专业制作的录音,还是代码合成的声音。 - 分析配乐:
timeline识别事件、段落、音量、节拍,以及与视频剪辑或提示帧的同步情况。 - 创建可视化报告:
sheet生成带注释的 PNG,其中包含视频画面、事件、段落、波形、频谱图、响度和同步标记。 - 评析发布影片:
critique将影片与基于七部专业发布影片建立的配置文件进行比较,并提出带时间戳的修改建议。 - 进行客观测量:
measure在不使用模型的情况下,报告 LUFS、真峰值、响度范围、包络、频谱、速度和调性等属性。 - 合成音效:
forge根据代码渲染声音,并使用 Earshot 的评析器和无模型测量结果搜索配方参数。
安装 Earshot
前置条件
你需要 Python 3.10 或更高版本,并确保系统路径中可用 ffmpeg 和 ffprobe。Earshot 仅使用 CPU,不使用 GPU。
创建环境
git clone https://github.com/Leonxlnx/earshot
cd earshot
python -m venv .venv
.venv/bin/python -m pip install torch --index-url https://download.pytorch.org/whl/cpu
.venv/bin/python -m pip install -e ".[mcp,llm,dev]"
.venv/bin/python -m earshot doctor --load
在 Windows 上,将 .venv/bin/python 替换为 .venv/Scripts/python。
第一次执行基于模型的操作时,系统会将约 1.4 GB 的数据下载到仓库内的 .cache/hf,除非你配置了 EARSHOT_HOME。Earshot 使用 CLAP 模型 laion/larger_clap_general 生成文本与音频嵌入,并使用 MIT/ast-finetuned-audioset-10-10-0.4593 进行 AudioSet 标签分类。
需要验证依赖项、数据文件、模型、精度或 CPU 设置时,可运行诊断命令:
.venv/bin/python -m earshot doctor --load配置 CPU 和缓存设置
EARSHOT_THREADS控制 Torch CPU 线程数。EARSHOT_HOME更改缓存根目录。EARSHOT_PRECISION=fp32强制使用 FP32。默认情况下,仅支持原生 BF16 的 CPU 使用 BF16,其他情况使用 FP32。EARSHOT_OFFLINE=1在模型下载完成后启用离线运行。
命令行基本用法
描述声音
当你想简要了解一个陌生文件时,可以从 describe 开始:
earshot describe enter.ogg摘要可以包含时长、瞬态形状、可能的声音类别、经过校准的 z 分数、峰值电平、明亮度和其他解读。添加 --json 可获取完整的结构化结果,或使用 --out result.json 将结果保存下来。
测试特定描述
当你已经知道想要的声音时,使用 match。替代描述有助于将目标与可能混淆的声音区分开来:
earshot match key.ogg "a deep thocky mechanical keyboard press" --alts "a clicky blue switch keyboard" "a mouse click"结果包括余弦相似度、经过词汇校准的 z 分数,以及 strong、plausible、weak 或 no match 等判定。
对多个候选文件进行排序
要从一组文件中选出最佳候选项,请先传入描述,再传入文件路径:
earshot rank "a fast crisp air whoosh" sounds/one.wav sounds/two.wav sounds/three.wav当代理下载或渲染出多个可能的音效,并需要基于证据进行排序时,这项功能非常有用。
在长录音中查找事件
find 命令会在录音中搜索,并返回可用于采样剪辑的时间:
earshot find keys.ogg "a single mechanical key press" --top 4每个结果都包含开始时间、结束时间、时长、分数和判定结果。随后可以使用这些时间戳,从更大的源素材中提取出干净的事件。
无需模型解读即可测量
当你需要可复现的音频属性,而不是语义判断时,请使用 measure:
earshot measure soundtrack.wav --json它会报告响度、真实峰值、响度范围、包络、频谱、速度和调性等客观信息。
分析电影配乐
构建听觉时间线
使用 timeline 创建逐秒的听觉转录。提供视频后,Earshot 还可以评估音频与画面剪辑及提示帧之间的同步情况:
earshot timeline soundtrack.wav --video film.mp4 --json结果可以包括检测到的事件、段落、电平、响度、节拍网格以及视听同步证据。
创建带注释的声音分析表
声音分析表会将主要分析层整合到一张图像中,供视觉智能体检查:
earshot sheet soundtrack.wav --video film.mp4 -o out.png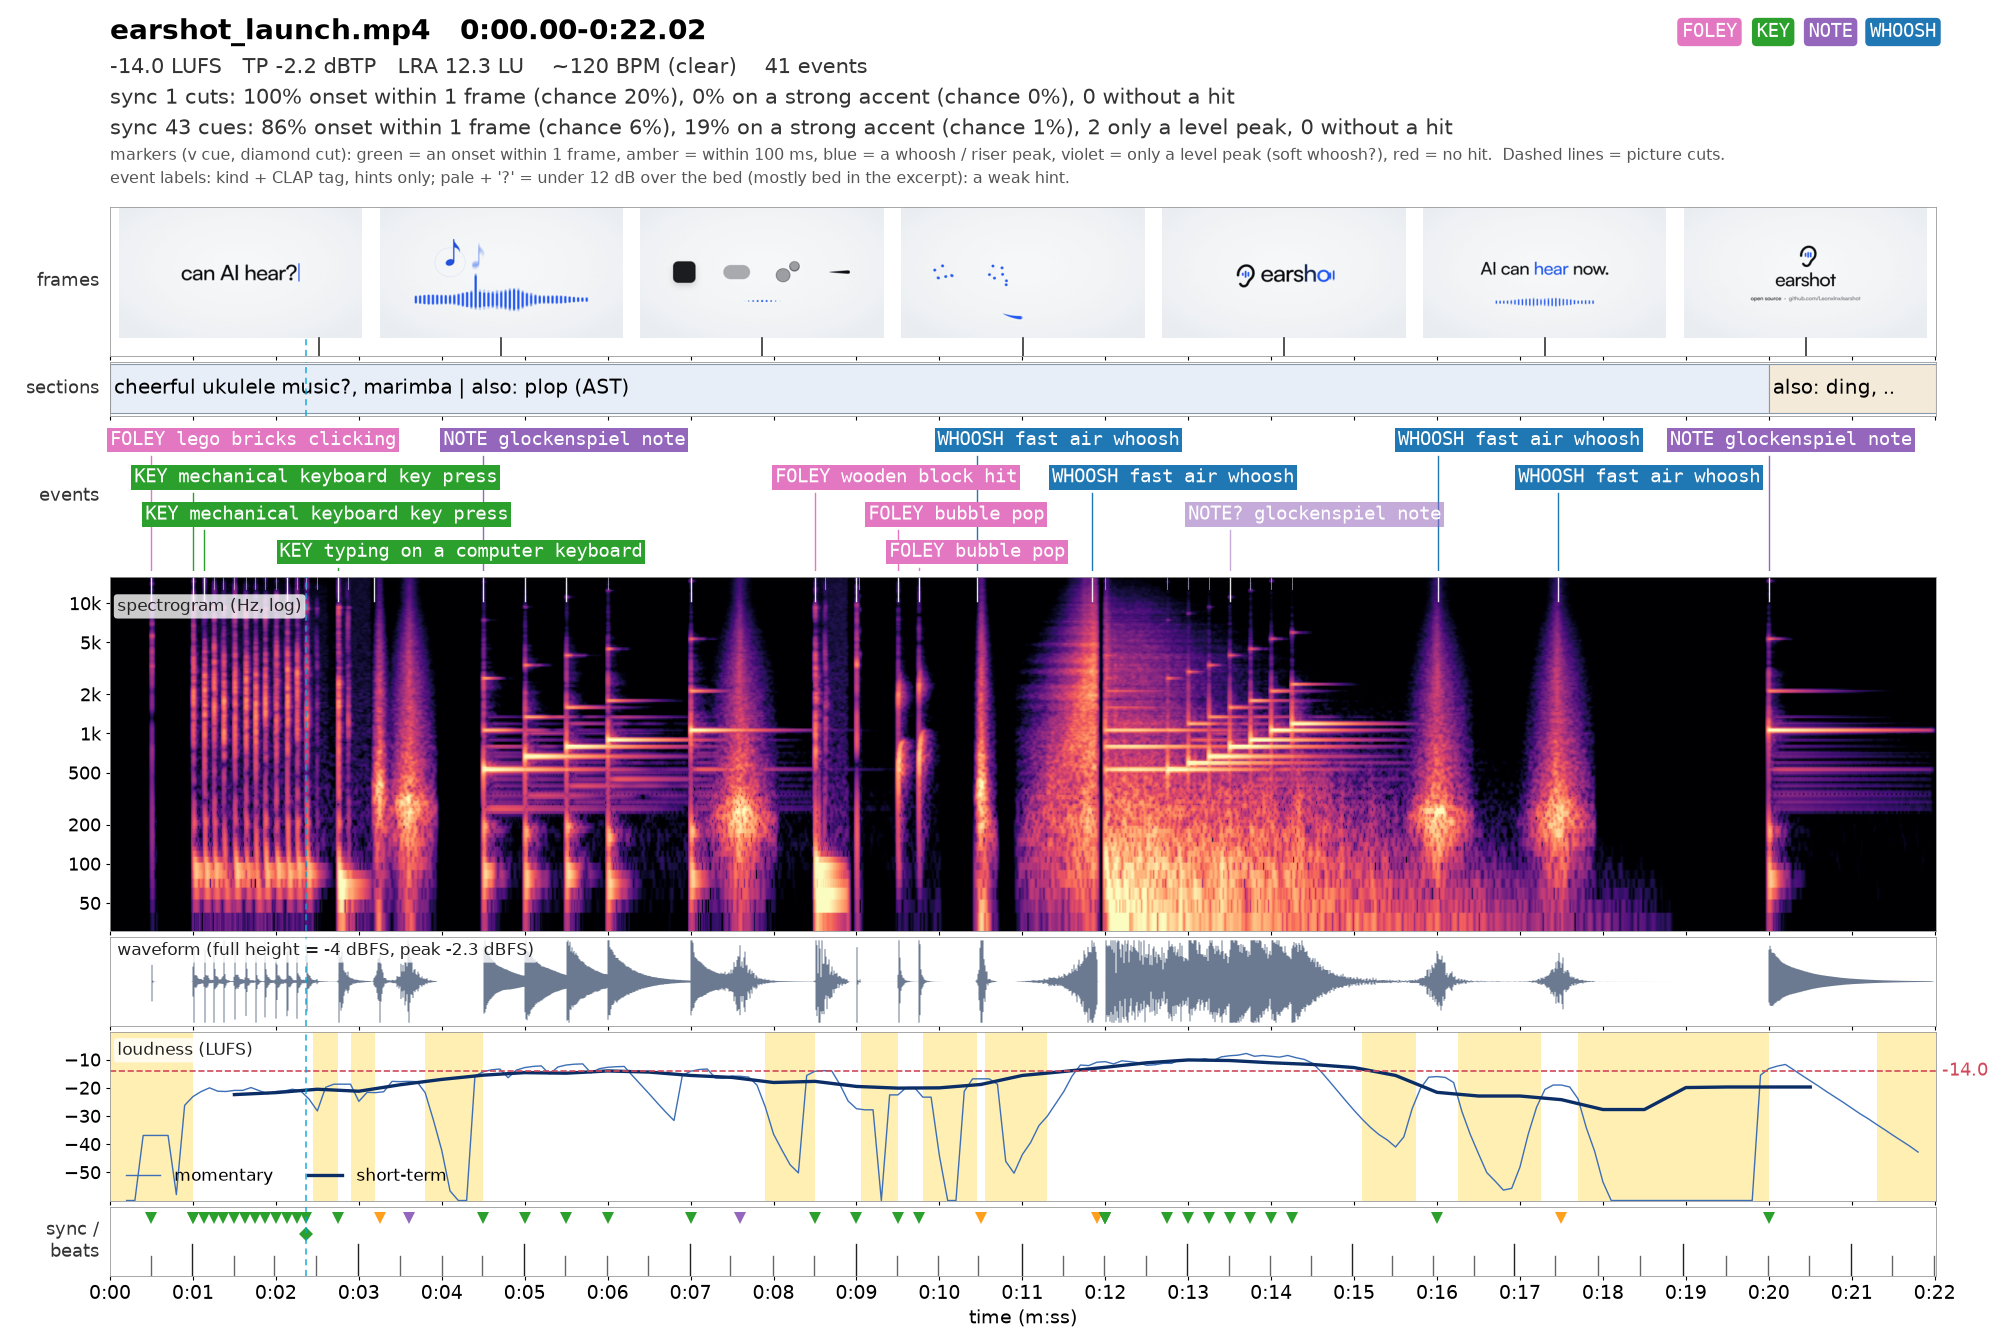
生成的 PNG 可以组合代表性画面帧、带标签的事件、段落、波形、频谱图、响度、节拍和同步标记。
生成发布影片评析
运行 critique,将影片与 Earshot 内置的七部专业发布影片样本进行比较:
earshot critique film.mp4报告会给出判定结果,指出处于样本范围内或范围外的指标,并按优先级列出带时间戳的修改建议。请将其视为与某一种特定发布影片风格的比较,而不是衡量质量的通用标准。
你也可以根据自己欣赏的影片构建分析样本:
earshot profile reference-one.mp4 reference-two.mp4 reference-three.mp4 -o custom-profile.json通过 Python 使用 Earshot
Python 接口无需为每项操作启动新的进程。这很有用,因为单独的 CLI 调用会加载模型,返回结果前可能需要约 20 到 40 秒。
import earshot

earshot.describe("whoosh.wav")
earshot.find("typing.ogg", "a single isolated key press")
earshot.timeline("soundtrack.wav", video="film.mp4")

from earshot import api
api.rank("a crisp UI click", ["click-a.wav", "click-b.wav"])
api.critique("film.mp4")
earshot.api 命名空间提供排名、评析和多文件真实感分析等操作。将这些调用放在同一个 Python 进程中,可以重复使用已加载的模型。
将 Earshot 作为 MCP 服务器运行
对于需要反复发出请求的智能体,MCP 服务器优于单独的 CLI 调用,因为模型在首次请求后仍会保持预热状态。
claude mcp add earshot --scope user -e EARSHOT_THREADS=3 -- /path/to/earshot/.venv/bin/python -m earshot mcp对于其他兼容 MCP 的客户端,请在其 .mcp.json 中添加等效设置:
{"mcpServers":{"earshot":{"command":"/path/to/earshot/.venv/bin/python","args":["-m","earshot","mcp"],"env":{"EARSHOT_THREADS":"3"}}}}在运行较慢的机器上,请使用 MCP_TIMEOUT=60000 启动 Claude Code。可选的 llm_critique 工具会从环境变量中读取 GEMINI_API_KEY。不要将实际的 API 密钥放入配置文件。
使用 Earshot Forge 生成声音
Forge 无需嵌入录制音频即可创建声音。它的配方使用模态共振器、接触激励、滤波噪声、计算生成的房间以及麦克风模型等物理合成组件。
首先列出内置配方:
earshot forge仓库中包含点击声、撞击声、按键声、爆裂声和呼啸声的配方。若要使用真实录音作为参考来搜索按键声,请运行:
earshot forge keypress --refs path/to/real/keypresses/ --budget 144 --reps 2 --tone 1.5 --keep 4 --robust 8 --dir made/keypress若要针对特定描述进行生成,同时列出可能的混淆声音:
earshot forge whoosh --target "a fast crisp air whoosh" --alts "a wind gust" "a sword swing" --refs path/to/real/whooshes/ --tone 1.5 --dir made/whooshForge 会渲染参数化候选,使用评判器为其评分,保留较强的结果,并通过进化搜索对其进行变异。评分会考虑描述匹配度、指定的替代项、估算真实感、与参考音频的接近程度、测量得到的形态、音调平衡、尾音表现和时长。
输出包括多样化的 WAV 文件,以及包含候选参数和分数的 report.json。使用 --robust N 时,选定的候选会使用新的随机种子再次渲染,以便检查配方是否稳定可靠,而不是仅仅偶尔成功一次。
谨慎评判 Forge 结果
Forge 针对 Earshot 自有模型进行优化,因此较高的模型分数并不能保证声音在感知上更好。
请将生成声音的三分之一倍频程平衡、尾音和时长与参考录音进行比较。在参考音频旁检查其频谱图,测试使用不同随机种子的重新渲染结果,并在质量要求较高时进行人工盲测。README 特别提醒,真实感模型可能会被模态共振器、房间响应和噪声底等技术的组合所欺骗。
高级工作流技巧
- 为工作负载选择合适的接口。 CLI 适合进行少量调查。对于重复分析,请使用一个 Python 进程或 MCP 服务器,以便模型保持加载状态。
- 先广泛探索,再验证假设。 运行
describe,形成目标描述,然后使用带有明确备选项的match。 - 区分语义证据与客观证据。 将基于模型的判断与
measure、音调平衡检查、波形检查和频谱图结合起来。 - 保存结构化输出。 当其他程序或代理需要检查所有字段,而不只是自然语言摘要时,请使用
--json或--out。 - 使用真实的参考录音。 参考目录有助于比较和 Forge 评估,但你仍需对这些录音的来源和许可负责。
- 安装随附的代理技能。 将
skills/earshot和skills/real-sound复制或符号链接到~/.claude/skills/或项目的.claude/skills/中。它们记录了命令选择、判定结果解读、配乐制作、混音、质量检查和许可检查。
了解限制
Earshot 最擅长处理响度、时序、画面同步、暴露的单个声音匹配、候选项排序,以及识别明显由代码合成的声源。对于从繁杂混音中提取的标签,以及音乐类型和情绪判断,应将其视为提示。
它无法判断品味、情感、来源、许可或语音内容。其模型不会评估高于 14 kHz 的频率。真实感判定是证据而非证明,内置的启动配置文件也仅代表用于创建它的七部影片。
在生产工作流中依赖评分之前,请查阅仓库的验证文档以了解测量结果,并查阅其限制文档。
结论
Earshot 为编码代理提供了一种使用本地 CPU 工具检查和创建声音的实用方式。从 describe、match 和 find 开始;处理完整影片时,继续使用 timeline、sheet 和 critique;当需要完全通过代码制作参数化音效时,使用 Forge。为了做出可靠决策,请将模型判定与测量结果、参考比较、视觉检查和人工聆听结合起来。