

什么是 Rizzo Flow?
Rizzo Flow 是一个开源、本地优先的系统,可将非结构化文本或 JSON 状态转换为带概率的类型化决策。它不要求语言模型逐个 token 生成散文或 JSON,而是在一次前向传递后读取模型对受限答案字母集合的概率。
这种设计支持以下决策:
- 带有
true概率的布尔答案。 - 在命名选项中进行选择,并提供每个选项的概率。
- 跨有序评分标准等级的评分。
- 基于代表性锚点的数值估计。
Rizzo Flow 通过 llama.cpp 在你自己的硬件上运行。它支持 Apple Metal、NVIDIA CUDA、Vulkan、AMD ROCm、Intel SYCL 或 CPU 执行。它还提供兼容 Jev 的 HTTP 接口,让兼容应用可以面向本地 URL,而不是托管服务。
Rizzo Flow 是一个独立项目。它复现的是 Jev 背后的接口模式,而不是 Jev 的专有架构或训练方式。除非你使用自己的代表性数据进行校准,否则其概率未经校准。
零 token 决策的工作原理
对于每个请求,Rizzo Flow 会将状态放在提示词开头,并对其处理一次。随后,问题从共享的状态缓存中分支出来。每个可能的答案都会映射到一个大写字母,系统只读取允许字母对应的 logits。
- 状态会被转换为文本,并预填充到模型的 KV 缓存中。
- 每个问题都会表示为一个受限的多项选择问题。
- 共享同一状态的问题会以微批次方式进行评估。
- 允许的答案 logits 会通过 softmax 转换为概率。
- Python 代码返回经过 schema 验证的布尔、选择、评分或数值数据。
整个过程没有解码循环、采样文本、输出解析或 JSON 修复。不过,生成零个 token 并不意味着计算量为零:状态和问题提示词仍然需要模型推理。
主要功能
- 完全本地运行:模型推理在你的计算机上进行。
- 类型化结果:应用接收结构化值,而不是生成的散文。
- 概率分布:选择和评分结果会显示概率,而不只是 argmax 答案。
- 四种原生基元:布尔、选择、评分和数值。
- 可选的弃答:原生 API 可以报告证据不足、不确定性或超出范围的数值结果。
- 共享状态批处理:同一请求中的多个问题会复用状态的 KV 缓存。
- 兼容 Jev 的端点:现有客户端可以使用
/v1/systemone和/v1/models。 - 长上下文模型:Spark-X2.5 原生支持最高 1,048,576 个 token 的上下文,但 Rizzo Flow 默认每个问题使用 8,192 个 token。
- 本地工具:服务器包含 playground、交互式 OpenAPI 文档和 Snake 演示。
前置要求
安装 Rizzo Flow 前,请确保已准备好:
- Python 3.11 或更高版本。
- Git。
- 用于依赖和环境管理的 uv。
- 足够的磁盘空间来存放所选模型和运行时。
默认的 Spark-X2.5-4B Q8_0 模型下载大小约为 4.4 GB。运行时下载大小因平台而异:Mac 上约为 11 MB,CUDA 软件包约为 570 MB。
安装并启动服务器
克隆仓库,同步固定版本的依赖,下载默认运行时和模型,然后启动服务:
git clone https://github.com/Rizzo-AI-Academy/rizzo-flow
cd rizzo-flow
uv sync --locked
uv run rizzo download
uv run rizzo serve
下载命令会为当前计算机选择官方预构建的 llama.cpp 软件包,验证其 SHA-256 校验和,并下载 Spark-X2.5-4B Q8_0。中断的下载可以从停止的位置继续。
根据项目文档,模型加载大约需要十秒。服务准备就绪后,打开:
- 打开
http://127.0.0.1:8017/playground使用可视化 playground。 - 打开
http://127.0.0.1:8017/docs查看交互式 OpenAPI 文档。 - 打开
http://127.0.0.1:8017/snake查看 Snake 演示。
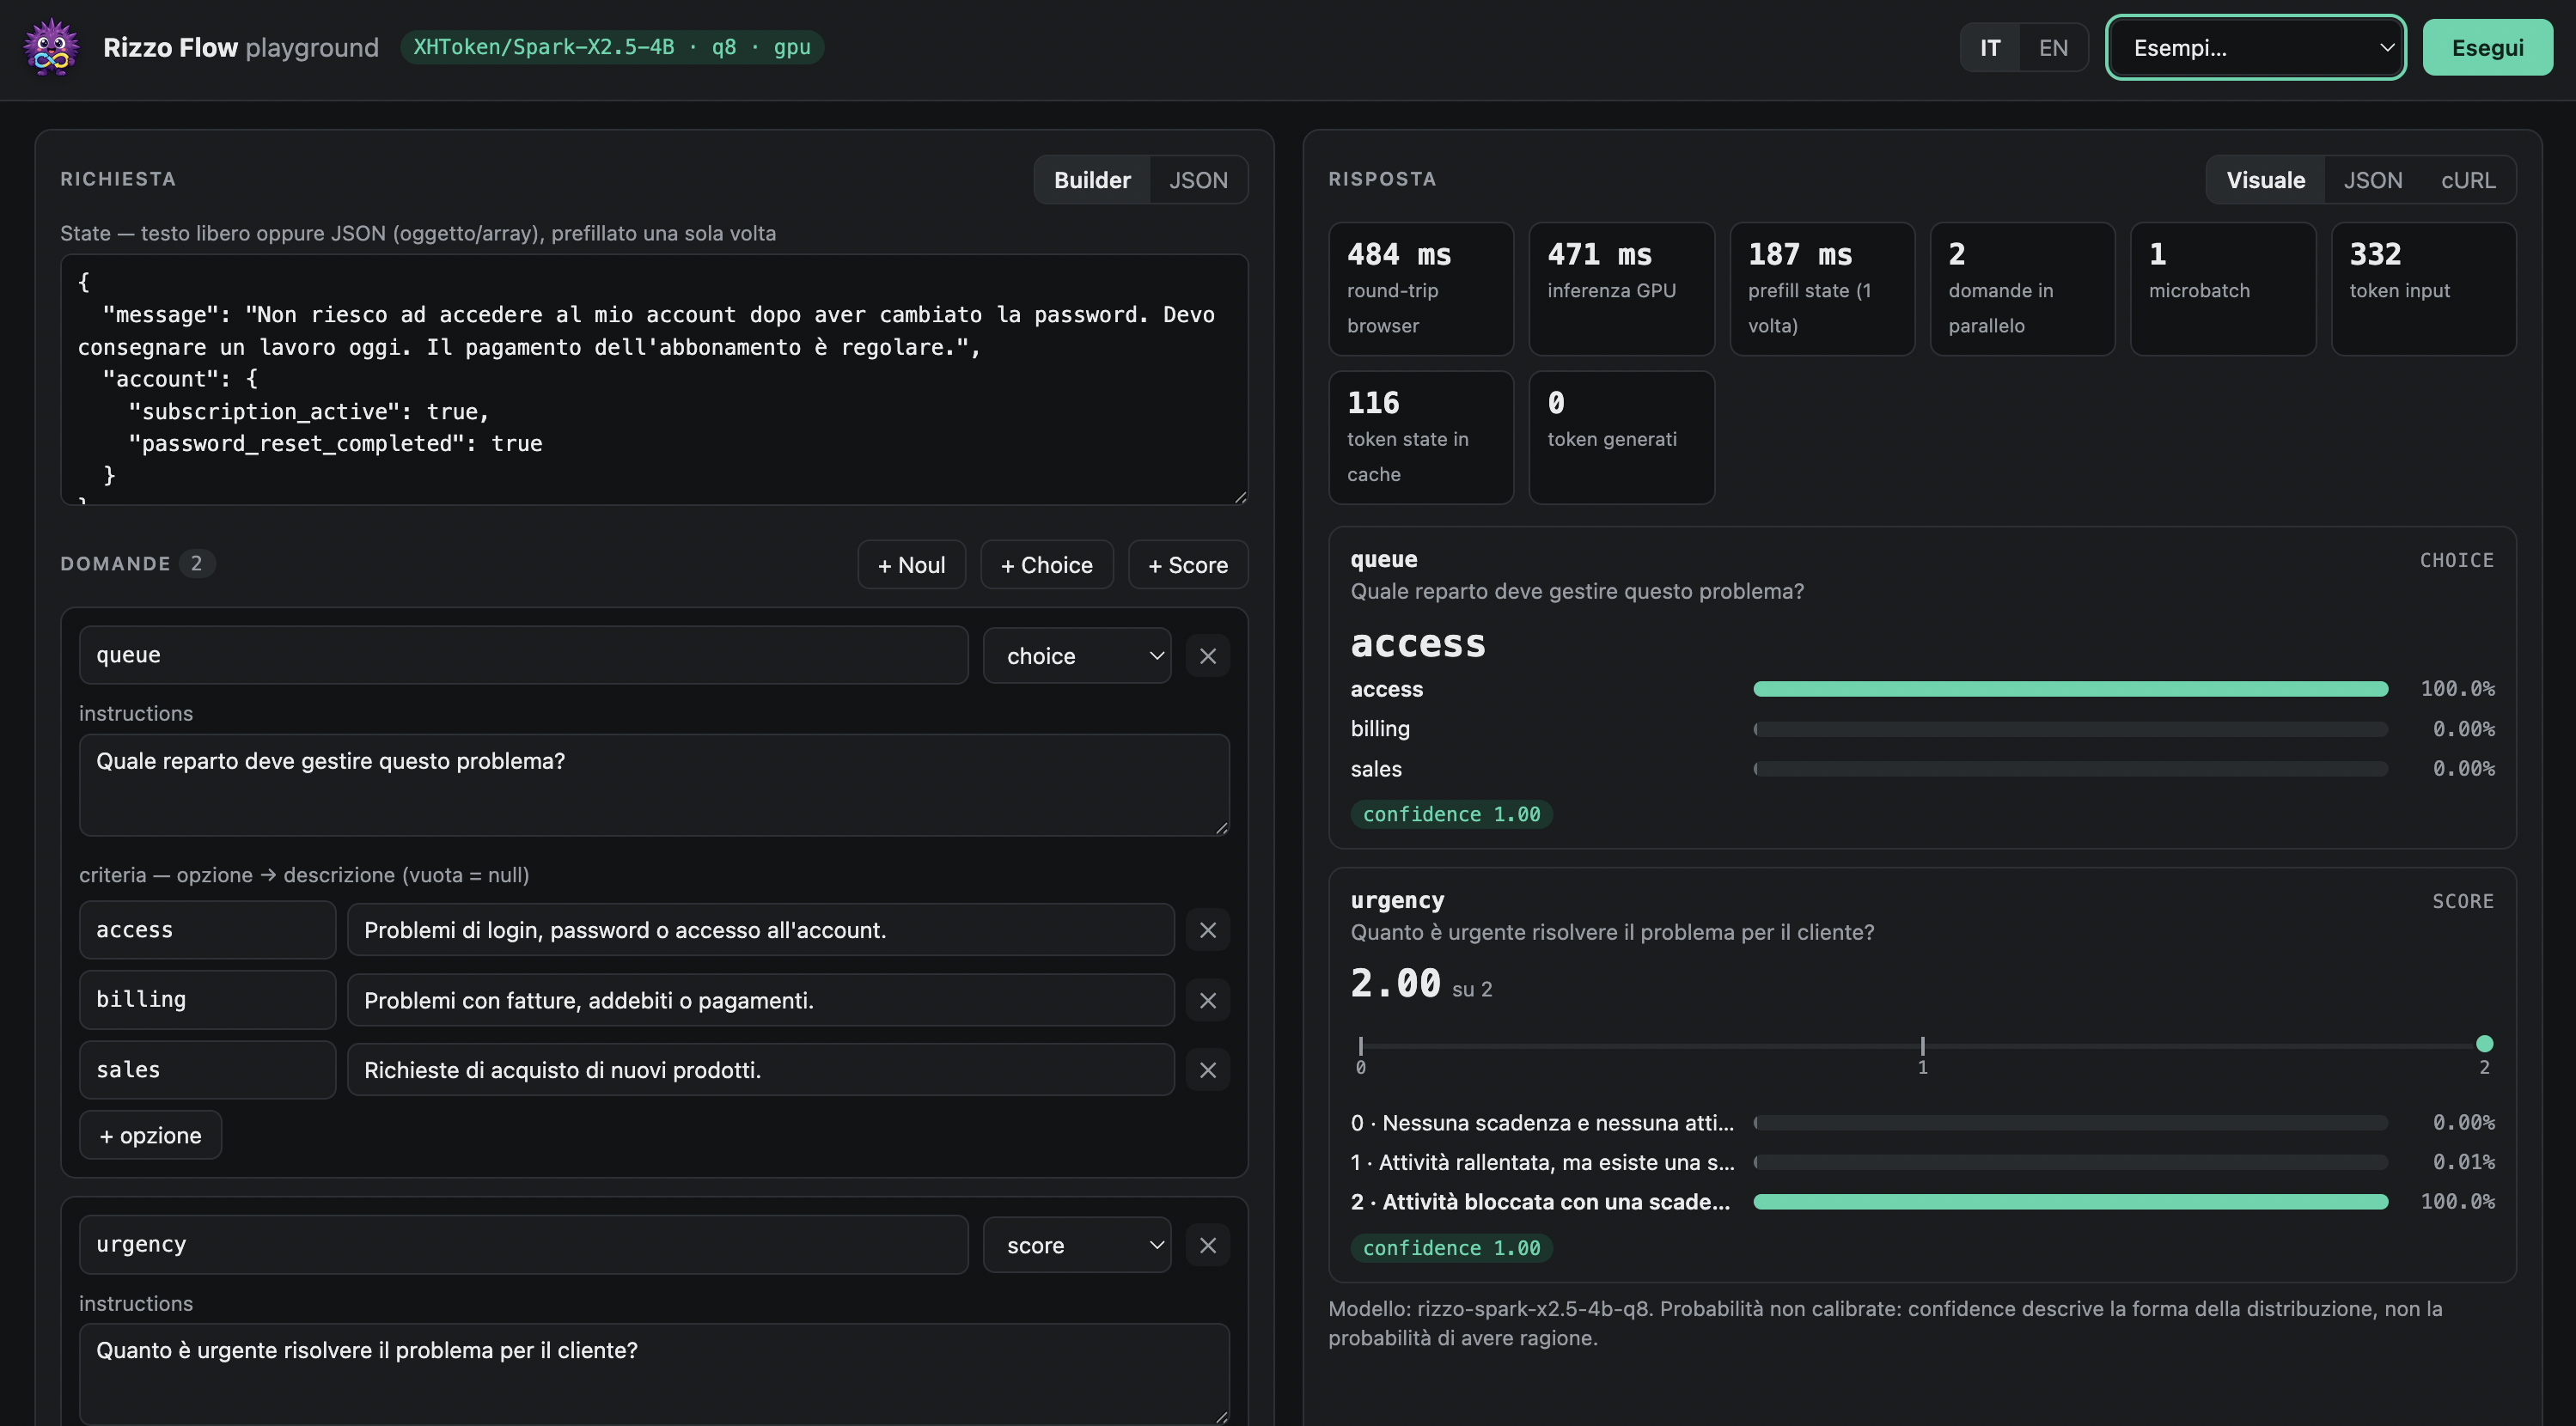
playground 包含现成示例、问题构建器、两个 API 的原始 JSON 编辑器、概率条、计时详情以及等效的 cURL 命令。它不会发起外部调用,并且可以在英语和意大利语之间切换。
使用更小的模型
如需更快完成首次下载,请安装 1.7B 模型:
uv run rizzo download --size 1.7b
uv run rizzo serve --size 1.7b
1.7B Q8_0 文件约为 1.8 GB,运行速度大约快一倍,但 README 警告其准确性低得多。启用弃答功能时,它还往往会选择“证据不足”选项,因此请务必在自己的工作负载上仔细测试。
做出你的第一个决策
最快的 API 测试使用兼容 Jev 的 POST /v1/systemone 端点。以下请求用于判断一条支持消息是否表达了紧迫性:
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "救命!我的付款已经失败 3 天了。",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "这是否表达了紧迫性?"
      }
    }
  }'
noul 结果表示“是”的概率,取值为 0 到 1 之间的数字。即使请求使用 rizzo-latest 或便捷别名,响应仍会报告实际的本地模型标识符。
在一次请求中提出多个问题
Rizzo Flow 的设计目标是针对同一状态评估多个问题。将它们合并到一次请求中,可以让这些问题共享该状态的 KV 缓存:
curl http://127.0.0.1:8017/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
    "state": "救命!我的付款已经失败 3 天了。",
    "model": "rizzo-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "这是否表达了紧迫性?"
      },
      "department": {
        "type": "choice",
        "instructions": "哪个团队应该处理此问题?",
        "criteria": {
          "billing": "付款、开票、退款",
          "technical": "错误和服务中断",
          "sales": null
        }
      },
      "frustration": {
        "type": "score",
        "instructions": "客户有多沮丧?",
        "criteria": ["平静", "沮丧", "非常愤怒"]
      }
    }
  }'
响应包含 noul 的“是”概率、所有选择选项的概率,以及带有图例的概率加权分数。usage.output_tokens 的值始终为 0。
使用原生决策 API
原生 POST /v1/decisions 端点提供 Rizzo Flow 的完整功能集,包括数值问题和弃答功能。它支持以下四种问题类型:
boolean:返回类型化值和为真的概率。choice:返回选定选项和完整的选项分布。score:返回有序等级上的概率加权分数和归一化分数。numeric:返回估计值、中位数、离散程度,以及低于或高于范围的概率。
根据锚点估计数值
数值问题定义递增的代表性锚点。以下示例要求模型读取报告的填充百分比:
curl http://127.0.0.1:8017/v1/decisions \
  -H 'Content-Type: application/json' \
  -d '{
    "state": {"measurement": 75, "unit": "percent"},
    "questions": {
      "fill": {
        "type": "numeric",
        "instructions": "读取报告的填充百分比。",
        "unit": "percent",
        "anchors": [
          {"value": 0, "description": "空"},
          {"value": 50, "description": "半满"},
          {"value": 75, "description": "四分之三满"},
          {"value": 100, "description": "完全充满"}
        ]
      }
    }
  }'
锚点是代表性数值,而不是统计区间。报告的均值始终位于最低和最高锚点之间,而分位数描述的是这些锚点上的离散概率分布。
理解弃答
原生问题默认允许弃答。Rizzo Flow 会添加一个内部的“证据不足”选项,而数值问题还会包含低于范围和高于范围的可能性。根据所选选项和策略,主要值可能为 null,状态可能报告为 insufficient_evidence、out_of_range 或 uncertain。
兼容 Jev 的格式不使用弃答。它的“是/否”结果恰好基于两个选项计算。如果你通过原生 API 使用较小的 1.7B 模型,请考虑按照项目建议将 allow_abstain 设置为 false,并验证其对你的数据的影响。
在没有服务器的情况下运行决策
对于脚本、测试或一次性评估,可以直接将请求文件传递给 CLI:
uv run rizzo decide examples/ticket.json你也可以激活虚拟环境,从而省略 uv run 前缀:
source .venv/bin/activate
rizzo decide examples/ticket.json
在 PowerShell 中,使用以下命令激活:
.venv\Scripts\activate选择模型、量化方式和设备
默认配置使用 Spark-X2.5-4B Q8_0。其他有文档说明的量化方式包括 Q4_K_M 和 BF16:
- 4B Q8_0:约 4.4 GB,也是默认配置。
- 4B Q4_K_M:约 2.6 GB。
- 4B BF16:约 8.2 GB。
- 1.7B Q8_0:约 1.8 GB。
- 1.7B Q4_K_M:约 1.1 GB。
- 1.7B BF16:约 3.4 GB。
启动服务器前,先检查运行时可见的设备:
uv run rizzo devices然后可以明确选择设备系列:
uv run rizzo serve --device cuda
uv run rizzo serve --device vulkan
uv run rizzo serve --device metal
uv run rizzo serve --device cpu
指定的设备系列属于硬性要求,而不是提示,因此 Rizzo Flow 不会将明确指定的 GPU 系列静默降级为 CPU。其他运行时软件包可以单独下载:
uv run rizzo download --only runtime --runtime rocm
uv run rizzo download --only runtime --runtime sycl
uv run rizzo download --only runtime --runtime cpu
高级配置与实用技巧
将相关问题进行批处理
将关于同一状态的所有问题放在一个请求中。这是 Rizzo Flow 设计的核心:状态只预填充一次,问题后缀会以微批次进行评估。默认的问题微批次大小为 4,可通过 --batch-size 更改。
uv run rizzo serve --batch-size 8更大的批次并不一定更好。请在目标机器上比较延迟和内存消耗。
谨慎增加上下文
尽管 Spark-X2.5 原生支持一百万 token 的上下文,但服务器默认每个问题使用 8,192 个 token。使用 --ctx 提高上限:
uv run rizzo serve --ctx 32768KV 缓存会在启动时分配。对于 4B 模型,README 估计每个 token 约占 144 KiB,因此默认上限约需 1.4 GiB,32,000 个 token 时约需 4.8 GiB。超过配置上限的输入会被拒绝,而不是截断。超过约 60,000 个 token 后,还必须提高 schema.py 中仓库设置的 256 KB 状态上限。
保护兼容端点
启动服务器前设置 RIZZO_API_KEY,即可要求 Jev 兼容端点使用 Bearer 身份验证:
export RIZZO_API_KEY="replace-with-a-secret"
uv run rizzo serve
在 Windows PowerShell 中:
$env:RIZZO_API_KEY = "replace-with-a-secret"
uv run rizzo serve
身份验证失败会返回 HTTP 401。无效的请求数据可能返回 HTTP 422。
重定向兼容客户端
为托管版 TypeSafe API 设计的客户端,可以通过更改基础 URL 来连接本地服务:
export TYPESAFE_BASE_URL=http://127.0.0.1:8017项目说明,这种环境变量配置面向官方 SDK,但目前尚未使用这些 SDK 进行测试。接口是兼容的,但底层本地模型并非 Jev。
正确理解置信度和概率
兼容 API 的置信度值描述的是选项分布的形态,并不是答案正确性的经验证概率。同样,模型原始概率也可能过度自信或存在其他校准偏差。
请在具有代表性的标注数据集上验证决策,并在必要时针对实际部署环境进行校准。服务器通过 --calibration 接受校准文件:
uv run rizzo serve --calibration fit.json校准结果与拟合时所使用的模型文件、运行时、量化方式和硬件后端绑定。CUDA、Vulkan 和 Metal 的舍入方式可能不同,量化也可能改变返回的概率。
遵守答案槽位限制
每个候选项对应一个大写字母,因此每个问题最多有 26 个答案槽位。内部弃答选项和范围选项也会占用槽位。因此,选择题在不启用弃答时最多支持 26 个普通选项,启用弃答时最多支持 25 个。数值题可用的锚点更少,因为低于范围、高于范围以及可选的证据不足选项也会占用槽位。
使用自定义模型文件或 llama.cpp 构建
使用 --model 启动服务器并指定 GGUF 文件:
uv run rizzo serve --model /path/to/model.gguf要使用自定义的 llama.cpp 安装,请将 RIZZO_LLAMA_DIR 指向包含 libllama 的目录。README 要求使用 llama.cpp 提交 161755f,因为绑定依赖该版本的头文件。
探索 Snake 演示
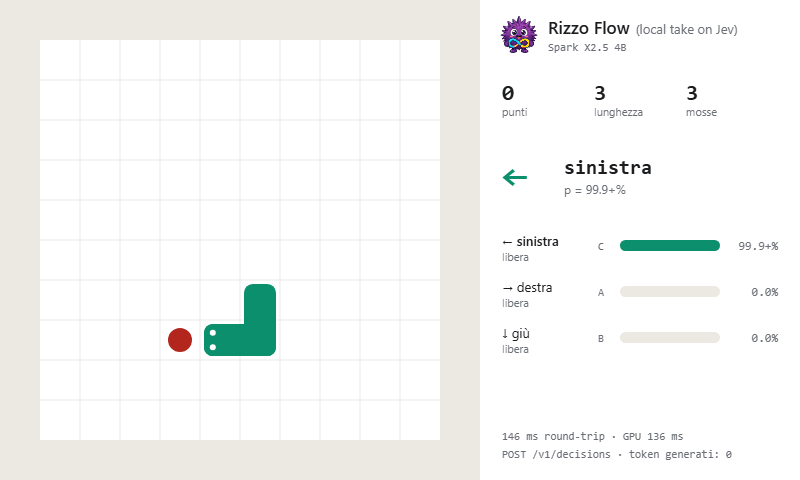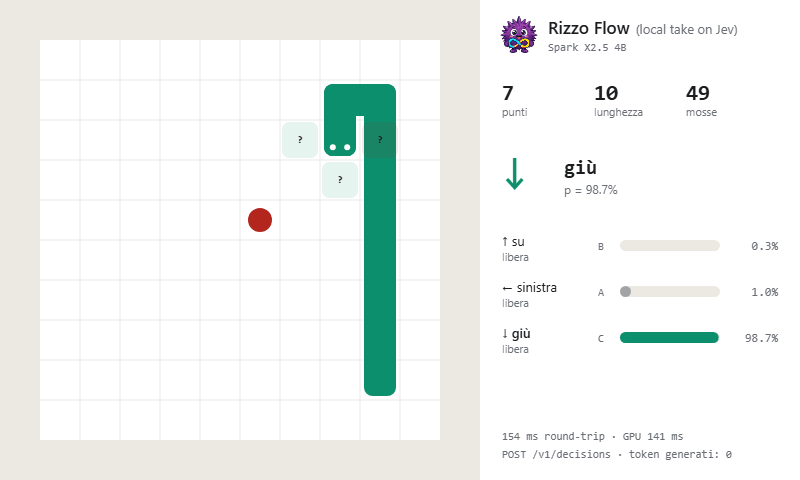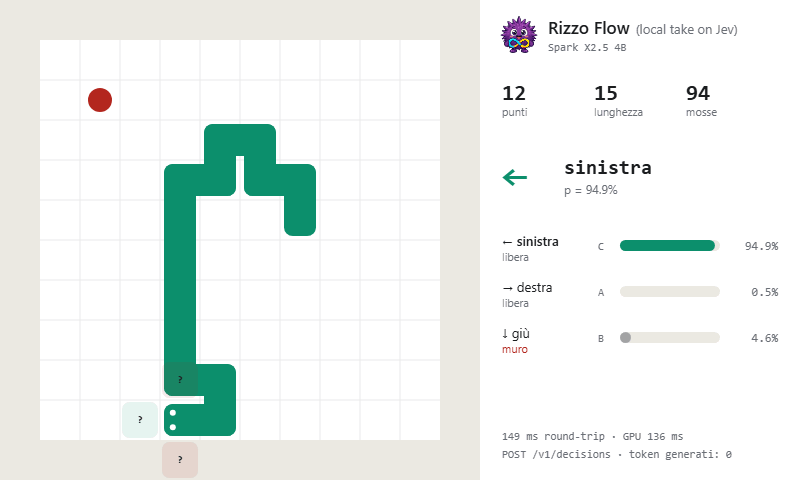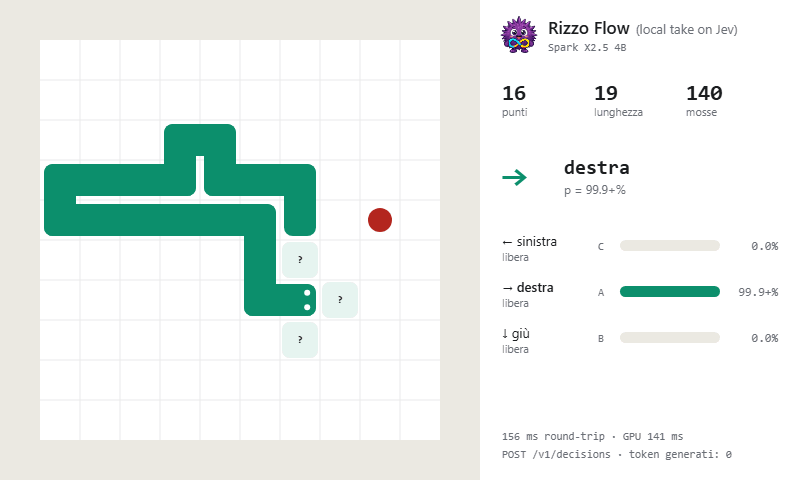
本地 Snake 页面展示了如何使用类型化决策控制交互式应用。每次移动都会发送一个 POST /v1/decisions 请求,其中包含棋盘描述和列出合法移动的选择题。页面会显示答案概率、logits、计时信息和决策日志,且不会生成文本。
该演示还说明了一个重要的建模经验:输入表示方式很重要。README 报告称,与仅使用 ASCII 网格相比,4B 模型使用计算得到的逐步传感器数据时表现好得多。这些观察结果来自少量非正式游戏,不应视为基准测试。
运行检查
使用 GET /health 检查模型来源信息和文件哈希。请求与响应模式也可在 request.schema.json 和 response.schema.json 中找到。为了实现可复现部署,请固定模型、量化方式、运行时、后端、上下文配置和校准设置。
README 报告称,在 RTX 5060 Ti 上使用 Spark-X2.5-4B Q8_0 进行短决策时,耗时约 50 毫秒,但这取决于硬件和工作负载。同一份文档还指出,Apple Silicon、AMD、Intel、Linux NVIDIA 和 CPU 配置尚未全部经过同等程度的测试,因此请先在自己的机器上进行基准测试,再设定延迟预期。
结论
Rizzo Flow 提供了一个实用的本地界面,可将非结构化状态转换为带类型的概率决策,而无需生成文本。先从 Playground 开始,将相关问题合并到一个请求中;当需要数值估计或弃权时,使用原生 API。在投入生产前,请使用能够反映真实应用的数据,测试准确率、延迟、校准、量化以及后端行为。