

MACaQ 是一个与模型无关的校准量化项目,用于降低现代 AI 模型的内存和计算需求。它通过 llama.cpp、vLLM、Diffusers 和 PyTorch 支持文本、图像、视频和音频工作流。
该项目专注于校准后的低精度权重和激活值,同时保留实用的推理兼容性。根据 README,MACaQ 可以使用 32.5 GB 设备内存,在 64 分钟内完成对一个 1220 亿参数模型的量化。在部分比较中,其困惑度也低于 MR-GPTQ 和 DuQuant++;或者在显著缩短量化时间的同时,达到与 Llama-3-8B 相当的困惑度。
选择合适的 MACaQ 后端
首先选择与模型和部署目标匹配的后端。请为每个后端分别创建独立环境,并使用 Python 3.12。
- Diffusers:将图像、视频和音频生成模型量化为 W4A4 safetensors 检查点。
- llama.cpp:将文本模型量化为 2 位、3 位或 4 位 GGUF 文件,并在本地运行,包括在 CPU 上运行。
- vLLM:使用 W4A4 或仅权重格式,为生成或 HTTP 服务量化文本模型。
- PyTorch:将语音生成模型量化为 W4A4 检查点,并生成 WAV 音频。
代码仓库包含针对各后端的安装、校准、量化和生成说明。开始操作前,请先打开所选后端的指南:
准备环境
使用 Python 3.12,并为计划使用的后端创建隔离环境。为不同后端分别维护环境,有助于避免 llama.cpp、vLLM、Diffusers 和 PyTorch 之间的依赖冲突。
克隆 MACaQ 代码仓库并进入其目录。
为所选后端创建 Python 3.12 虚拟环境。
按照该后端的 README 安装依赖项和任何所需的运行时。
准备后端指南中指定的原始模型、校准数据和输出目录。
具体安装命令取决于后端和模型系列,因此请使用链接的 README,不要对所有工作流套用同一条通用安装命令。
使用 Diffusers 量化生成模型
Diffusers 后端用于处理扩散 Transformer,并保存量化后的 safetensors 检查点。它支持图像、视频、图像到视频和音频生成。
代码仓库为包括 black-forest-labs/FLUX.2-klein-4B、Wan-AI/Wan2.2-TI2V-5B-Diffusers 和 ylacombe/stable-audio-1.0 在内的模型提供了工作流。对于图像到视频模型,校准可以使用条件图像,使量化过程能够反映预期的输入模式。
打开 Diffusers 指南,选择图像、视频或音频工作流。
在专用的 Python 3.12 环境中安装后端依赖。
下载或确定源模型,并准备所选方案要求的校准输入。
运行文档中的量化命令,保存 W4A4 safetensors 检查点。
使用相应的生成命令生成图像、视频或音频结果。
使用 llama.cpp 量化文本模型
llama.cpp 后端会为文本生成生成紧凑的 GGUF 文件。它支持 2 位、3 位和 4 位 GGUF 格式,并包含一个用于从生成模型输出文本的运行时。
代码仓库记录了诸如 Qwen/Qwen3-4B 这样的稠密模型、诸如 Qwen/Qwen3.8-27B 这样的混合模型,以及诸如 Qwen/Qwen3-30B-A3B 和 Qwen/Qwen3-Coder-30B-A3B-Instruct 这样的混合专家模型。此外,还包含适用于 Qwen3.6-35B-A3B 和 Qwen3.8-Flash-Next 的方案。
标准量化工作流
打开 llama.cpp 指南,选择与模型架构匹配的方案。
在专用的 Python 3.12 环境中安装 llama.cpp 后端及其依赖。
准备所选方案中描述的原始 Hugging Face 模型和校准文本。
运行文档中的 MACaQ 量化工作流,并保存 GGUF 输出文件。
使用捆绑的运行时或兼容的 llama.cpp 安装来生成文本。
有关特定模型的详细信息,请参阅后端 README 中的 dense、hybrid、mixture-of-experts 或 Flash-Next 部分。这些操作指南考虑了不同模型架构之间的差异。
运行 GGUF 模型
创建 GGUF 文件后,可以使用 llama.cpp 命令行客户端运行它:
llama cli -m models/model-macaq-r.gguf也可以通过 llama.cpp 提供模型服务:
llama serve -m models/model-macaq-r.gguf使用 MACaQ-R 优化现有 GGUF 文件
MACaQ-R 会优化现有量化 GGUF 文件中的权重编码,同时保留其原生格式和块缩放值。生成的文件仍兼容标准 llama.cpp 安装。
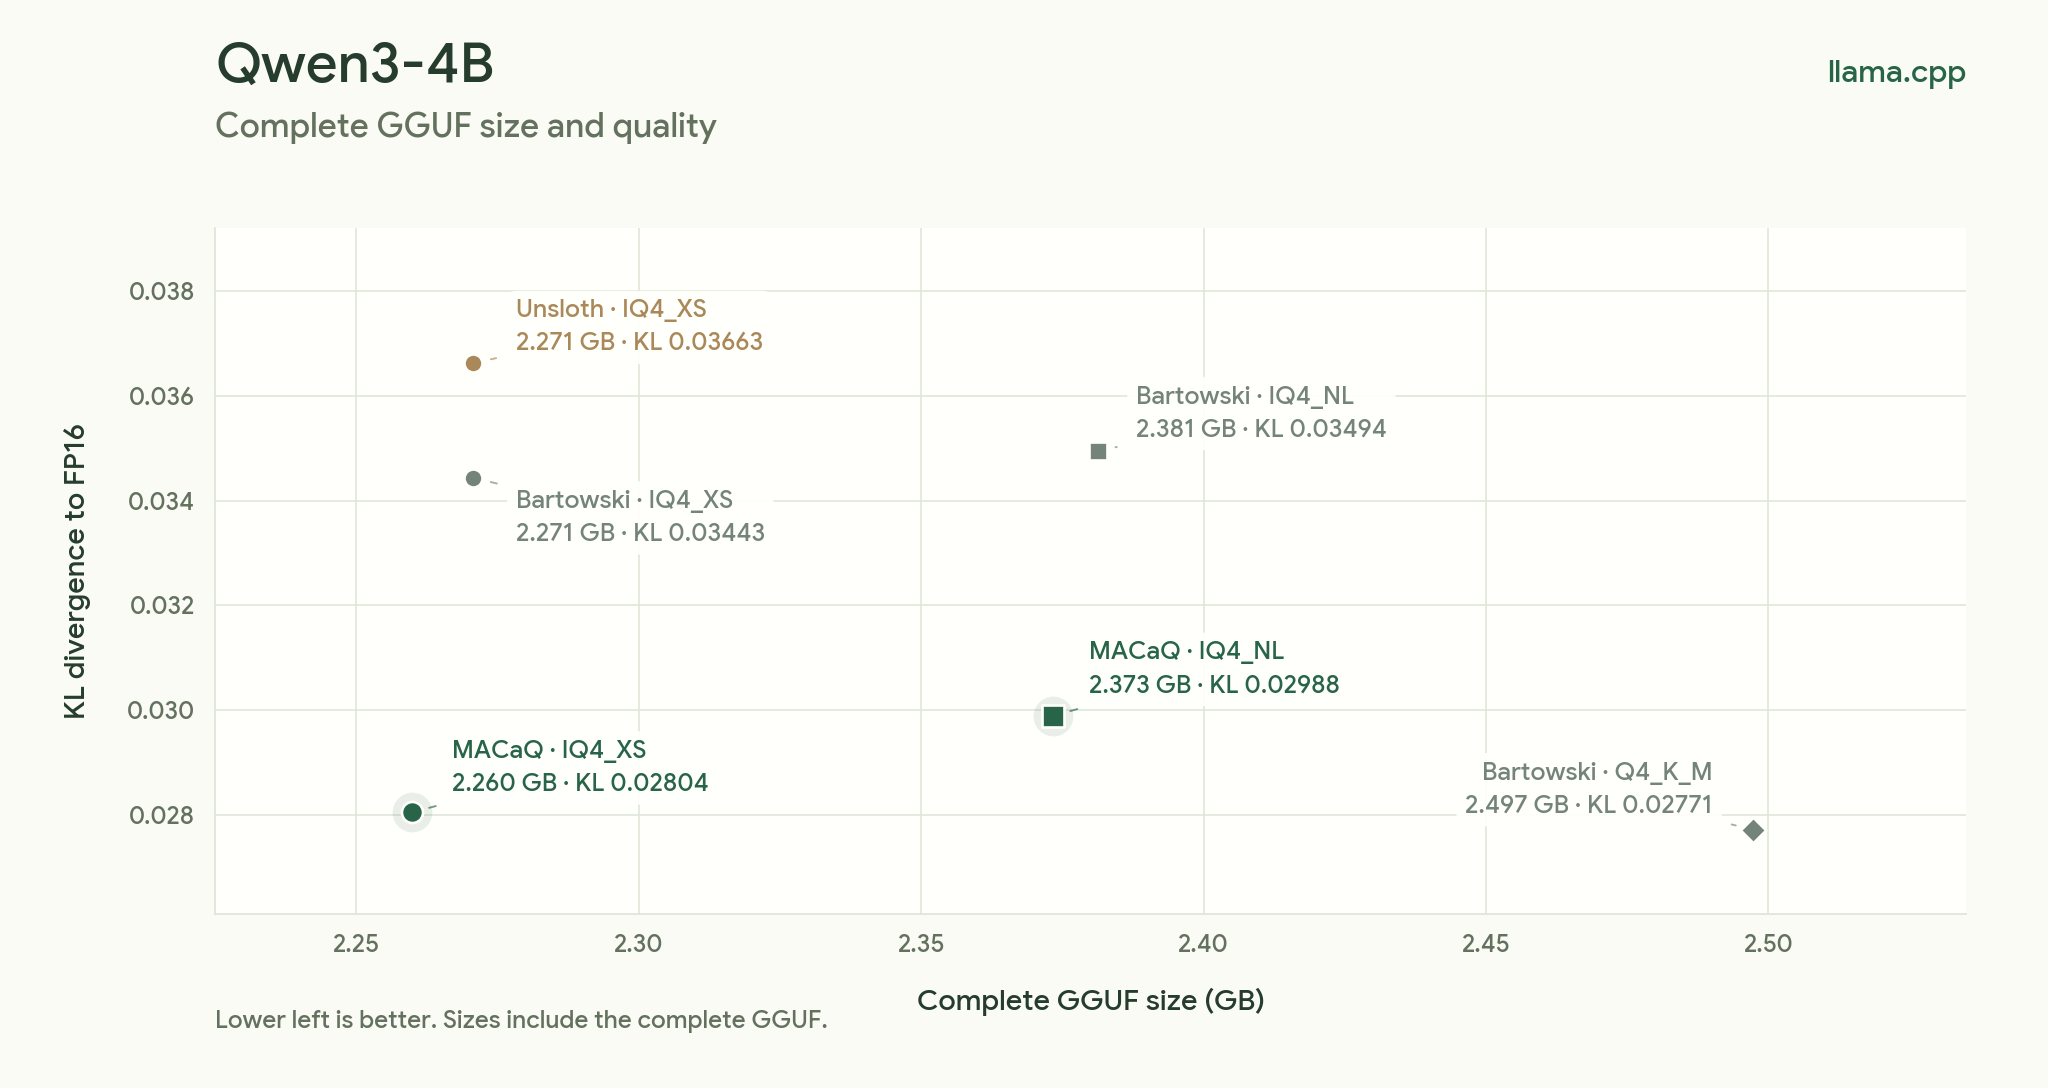
当你已有量化模型,并希望在不更改 GGUF 格式的情况下提升质量或使其适应特定工作负载时,这一功能非常有用。README 在 Hugging Face 上提供了 Qwen3.6-35B-A3B MACaQ-R 模型,并报告称,在相同标称大小下,其 KL 散度低于对比的 Unsloth UD-Q4_K_XL 文件。
要优化量化的 MoE GGUF,请提供量化模型、与其匹配的原始 Hugging Face 模型、FP16 教师文件、校准文本、输出路径和工作目录:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
优化完成后,使用标准 llama.cpp 加载输出文件:
llama cli -m models/model-macaq-r.gguf如需完整的 MACaQ 工作流程(包括激活变换),请参阅随附的运行时指南。
使用 vLLM 量化和提供模型服务
vLLM 后端会为生成或 HTTP 服务创建紧凑的文本模型检查点。W4A4 是默认推理模式,后端也支持仅权重量化。
打开 vLLM 指南,并选择适用于 hybrid 文本模型或文本 mixture-of-experts 模型的工作流程。
在独立的 Python 3.12 环境中安装 vLLM 后端。
准备所选操作指南要求的源模型和校准数据。
运行文档中的量化命令,创建紧凑检查点。
加载检查点进行本地生成,或启动文档中说明的 HTTP 服务器。
README 报告了 Qwen3.8-27B 的一项对比:MACaQ W4A4 的困惑度为 2.8994,BF16 为 2.8463;在列出的测试设置中,MACaQ W4A4 的预填充和解码测量速度更快。
使用 PyTorch 量化语音生成模型
PyTorch 后端面向语音生成,并保存 W4A4 检查点。检查点保存后,可以直接加载,无需重复校准。
文档中的工作流程涵盖 Qwen3-TTS 和 Chatterbox Turbo。
打开 PyTorch 指南,并选择语音模型。
在独立的 Python 3.12 环境中安装所需的 PyTorch 依赖。
按照特定模型的说明运行校准和量化。
保存 W4A4 检查点。
加载保存的检查点并生成 WAV 音频,无需重新校准。
在 Ascend 硬件上使用 MACaQ
MACaQ W4A4 dense 和 grouped 矩阵乘法内核可通过与 CANN 相关的拉取请求获得。README 指向 ops-nn 拉取请求 12568 中的 PTO-ISA 内核,以及 ops-tilelang 拉取请求 44 中使用 CCE 后端的 TileLang 内核。
请按照这些项目中的构建说明,使用兼容的 CANN、PyTorch 和 torch_npu 版本。运行完整模型需要与 Ascend 推理运行时集成。
改善工作流程的实用技巧
- 让后端匹配部署目标。对于便携式本地文本推理,选择 GGUF 和 llama.cpp;对于文本服务,选择 vLLM;对于多模态生成,选择 Diffusers;对于语音模型,选择 PyTorch。
- 使用特定模型的操作指南。Dense、hybrid 和 mixture-of-experts 模型可能需要不同的准备和量化步骤。
- 使校准数据与使用场景保持一致。例如,Diffusers 图像转视频工作流程会在校准期间使用条件图像。
- 分离环境。README 明确建议为每个后端使用独立环境,并使用 Python 3.12。
- 比较质量,而不只是文件大小。项目使用困惑度和 KL 散度对比,将量化模型与 FP16 或其他量化方法进行评估。
- 已有 GGUF 时使用 MACaQ-R。它可以优化现有量化文件,同时保留标准 llama.cpp 兼容性。
结语
MACaQ 为多种 AI 工作负载提供统一的量化方法,涵盖从 GGUF 文本模型到 Diffusers 图像、视频和音频模型、vLLM 服务检查点以及 PyTorch 语音生成器。请先阅读特定后端的 README,在隔离环境中使用 Python 3.12,按照模型配方完成校准,并使用目标运行时验证生成的检查点。
如需研究资料或技术文档,请参阅 MACaQ 论文。本项目根据 Apache License 2.0 发布。