

什么是 DeepSelect?
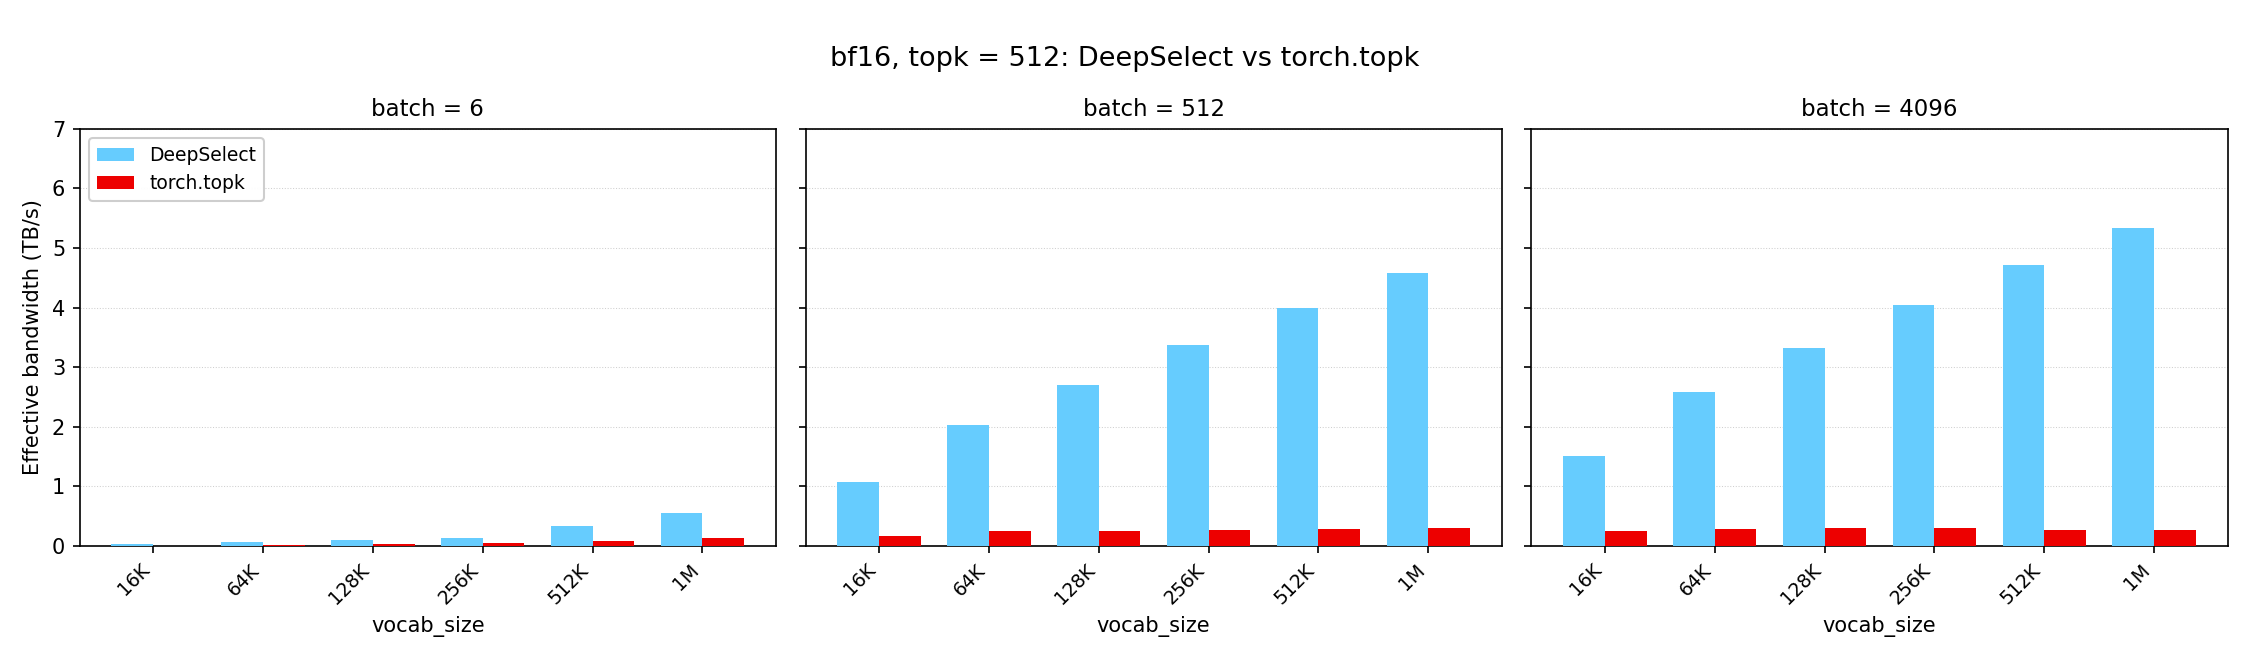
DeepSelect 是 DeepSeek 稀疏注意力和采样中使用的 TopK 内核的高性能实现。根据项目 README,在该库支持的工作负载中,它相比原生 torch.topk 可实现 2–20 倍的加速。
DeepSelect 并未尝试优化所有可能的 TopK 配置,而是专注于两种场景:使用 torch.bfloat16 输入的 Lightning Indexer 工作负载,以及使用 torch.float32 输入的采样工作负载。
支持的工作负载
Lightning Indexer 场景
- 输入类型:
torch.bfloat16 - 批量大小:从 1 起,针对小批量和大批量均进行了优化
- 词汇表大小:从 1 起,针对小词汇表和大词汇表均进行了优化
- TopK 大小:较小且不超过
4096
为了获得更好的性能,除非必须对结果排序,否则请保持 sorted_index 禁用。如果不需要值,请设置 return_value=False 以跳过值的输出。
采样场景
- 输入类型:
torch.float32 - 批量大小:从 1 起
- 词汇表大小:约 128K
- TopK 大小:较小且不超过
4096
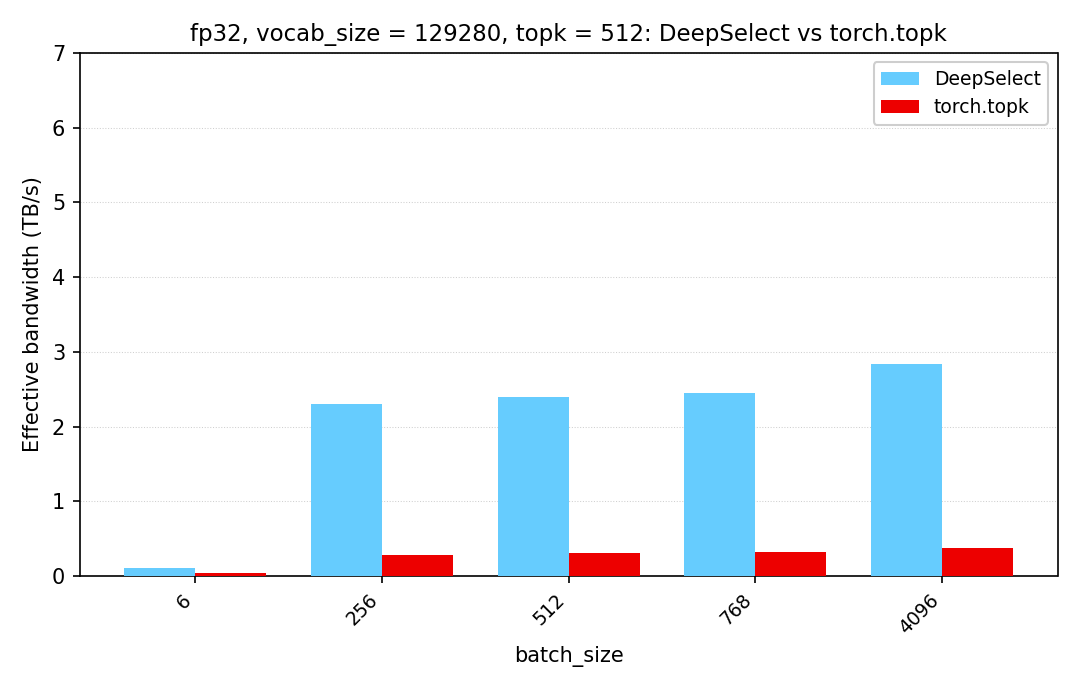
由于 TopK 不执行浮点运算,该仓库使用有效内存带宽而非浮点吞吐量来衡量性能。其基准测试报告的是相同输入下相对于 torch.topk 的性能。
主要特性
- 针对 DeepSeek 稀疏注意力和采样工作负载的专用 TopK 内核
- 在各自目标场景中支持
torch.bfloat16和torch.float32输入 - 可配置
torch.int32或torch.int64索引输出 - 可选的值输出:仅需要索引时可降低开销
- 通过每行独占上界支持可变长度行
- 由用户管理的索引输出缓冲区
- 内置 NaN 检查
安装
克隆仓库、初始化其子模块,然后从项目目录安装软件包:
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
示例使用 CUDA 张量,因此请在 device="cuda" 上创建输入。
基本 TopK 用法
导入 PyTorch 和 DeepSelect,创建二维输入张量,然后调用 deep_select.topk:
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
输入形状必须为 (batch_size, vocab_size)。其最后一个维度必须连续,并且行步长必须是 deep_select.get_stride_requirement()[0] 字节的倍数。
返回值的数据类型与 x 相同。索引使用通过 indices_type 选择的类型,可以是 torch.int32 或 torch.int64。设置 sorted_index=True 时,每行返回的索引会按升序排列。
仅返回索引
如果下游代码不需要选中的值,请禁用值输出:
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
README 指出,跳过值输出大约可以提速 10%。除非需要排序,否则应避免请求排序输出,因为排序会增加开销。
处理步长对齐
DeepSelect 对输入行和输出行施加了对齐要求。可以在运行时检查这些要求:
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
如果输入的行步长不是所需输入对齐值的倍数,请在将张量传递给 DeepSelect 前对其进行填充。最后一个维度必须保持连续。
默认情况下,DeepSelect 会分配两个输出。它们的步长会按 deep_select.get_stride_requirement()[1] 字节对齐,这意味着返回的张量可能不是连续的。使用这些输出的代码不应假设其具有标准连续步长。
使用现有索引缓冲区
当索引应写入由调用方管理的缓冲区时,API 接受 output_idx=。该缓冲区必须满足相同的输出步长要求。配置自定义缓冲区前,请查阅 deep_select/interface.py 了解完整的函数签名。
处理可变长度行
使用 end 为每行指定独占上界。当同一批次中的行具有不同的有效长度时,这一功能非常有用:
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
这里,第一行可以使用全部 129280 个元素,而第二行仅限于前 100000 个元素。如果某一行的长度小于请求的 TopK 大小,DeepSelect 会使用 value_oob_fill_value 和 idx_oob_fill_value 对其输出进行填充。
NaN 处理
NaN 检查始终处于启用状态。默认情况下,abort_when_nan_found=True,因此内核检测到 NaN 时会调用 trap() 并中止。有效长度小于或等于请求的 TopK 大小的行不会进行 NaN 检查。
如果输入数据可能包含 NaN,尤其是在保留默认中止行为时,请在启动内核前验证或清理输入数据。
性能与高级技巧
- 保持在受支持的 TopK 范围内。 DeepSelect 支持不超过
4096(包括4096)的小型 TopK 值。更大的值不受支持。 - 匹配目标工作负载。 对于 Lightning Indexer 场景,请使用
torch.bfloat16;对于项目所描述的采样场景,请使用torch.float32。 - 尽可能跳过排序。 按索引或数值排序会带来性能开销,因此仅在下游处理需要时请求排序。
- 尽可能跳过数值输出。 如果只使用索引,请设置
return_value=False。 - 尽早检查对齐要求。 围绕
get_stride_requirement()规划张量形状和填充,避免在性能关键循环中修复不兼容的张量。 - 不要假设输出是连续的。 DeepSelect 会对输出行步长进行对齐,因此生成的张量可能不是连续张量。
- 对实际形状进行基准测试。 TopK 性能取决于输入类型、批大小、词表大小和 TopK 大小。请测试应用实际使用的完整配置。
运行随附的基准测试
该仓库在测试脚本中提供了性能模式:
python3 tests/test.py --perf-only此基准测试会使用相同的输入比较 DeepSelect 与 torch.topk,并使用有效内存带宽报告二者的比率。
结论
DeepSelect 为兼容的 DeepSeek 稀疏注意力和采样工作负载提供了专用的 TopK 内核。请从经过对齐的二维 CUDA 张量开始,将 topk 保持在 4096 或以下,并在不需要时禁用排序或数值输出。在生产环境集成时,请验证步长要求,考虑输出可能不是连续张量,并针对应用实际使用的张量形状进行基准测试。