

Tiny Classifiers 的功能
tiny-classifiers 是一个用于训练小型、特定任务文本分类器的实用方案。它使用拥有 1,700 万参数的 Ettin-17M 编码器,对其全部权重进行微调,并将结果保存为标准的 Hugging Face 模型。
该项目面向多种分类任务,例如路由银行消息、对新闻分类、识别用户意图、检测情感,或将法律文档分配到预定义类别。如果没有足够的标注样本,可以让更大的语言模型充当教师,为训练集生成标签。
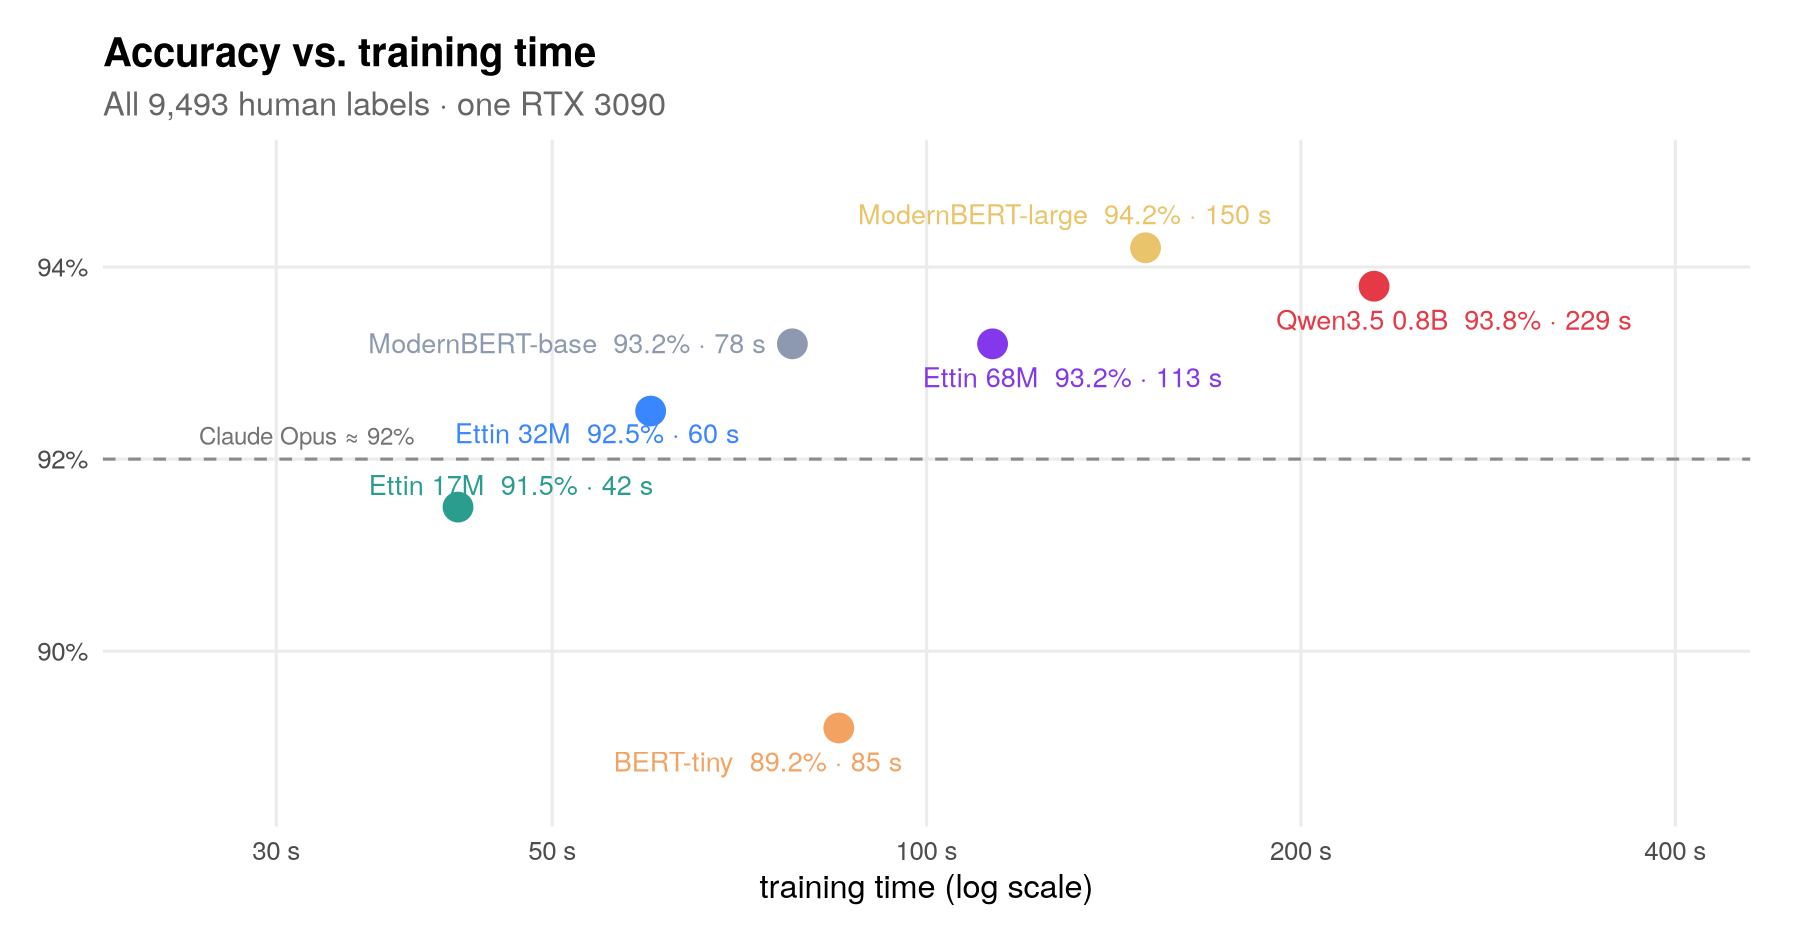
在仓库的 Banking77 实验中,Ettin-17M 达到了 91.5% 的准确率,而 Claude Opus 的准确率为 92%。在一块游戏 GPU 上,训练耗时 42 秒,推理速度约为每条消息 5 毫秒。在笔记本电脑 CPU 上训练约需 11 分钟,在手机 GPU 上约需 21 分钟。
Banking77 准确率与训练时间对比。
主要特性
- 小型本地模型: Ettin-17M 拥有 1,700 万参数,并为每个类别输出一个分数。
- 人工或教师标注: 使用经过验证的标签训练,或让 Kimi K3 为原本未标注的消息生成标签。
- GPU 和 CPU 训练: 训练脚本同时支持这两种环境。
- 标准模型输出: 训练好的分类器可以通过 Hugging Face 的
transformerspipeline 加载。 - 可恢复的标注: 标注脚本支持重试、自适应并发、慢请求对冲和提供商预算控制。
- 内置评估: 训练会报告测试准确率,教师标注还可以在带标签的测试集上测量教师的准确率。
- 成本分析: 盈亏平衡脚本会估算标注和训练何时比通过 API 支付分类费用更便宜。
- 可复用的数据准备: 项目可以使用统一结构准备十个公开分类数据集。
训练方案的工作原理
Ettin-17M 是由约翰斯·霍普金斯大学开发的开源编码器,与 BERT 风格模型有关。不同于逐个 token 生成文本的生成式模型,它会读取完整输入,并为每个可用类别分配一个分数。
该仓库为每个类别添加一个输出,并对模型的每个权重进行微调。默认方案使用 32 的批量大小、学习率为 1e-4 的 AdamW、权重衰减 0.01、5% 的预热阶段后接余弦衰减、1.0 的梯度裁剪,以及交叉熵损失。
对于约 9,500 条消息,训练会运行六轮。只有 2,000 个样本时,优化步数保持不变,相当于约 28 轮。README 强调,这些设置并未针对每项任务分别调优。
安装与设置
1. 安装 uv
这些脚本使用 uv 创建所需环境,并在首次运行时自动安装依赖。请按照操作系统对应的说明安装 uv,然后在仓库根目录中打开终端。
2. 准备公开数据集
运行准备脚本:
uv run recipe/prepare.py该脚本会从 Hugging Face Hub 下载 Banking77、CLINC150、英文和法文版本的 MASSIVE、TREC、AG News、SST-5、Financial PhraseBank、LEDGAR,以及一个推文仇恨言论数据集。
对于每项任务,脚本都会在 data/tasks/ 下创建一个目录。它会构建任务定义、2,000 条训练消息、一个每个类别最多包含 150 个样本的更大训练分片,以及一个测试集。
3. 配置标注提供商
如果希望教师模型生成标签,请为一个或多个受支持的提供商设置 API 密钥:
export OPENROUTER_API_KEY=...该方案还支持 Fireworks、Together、DeepInfra 和 Parasail 的提供商密钥。在发送数据或将生成的答案用于训练之前,请查看相关提供商当前的价格、使用政策和模型条款。
基础教程:训练 AG News 分类器
步骤 1:使用 Kimi K3 生成标签
准备好数据集后,为 2,000 条 AG News 训练消息生成标签:
uv run recipe/label.py data/tasks/agnews在报告的运行中,Kimi K3 用约 20 秒为 2,000 个样本生成了标签,成本约为 1 美元。实际耗时和成本可能因提供商而异。该脚本支持断点续作,因此中断的标注工作无需从头开始。
步骤 2:使用教师标签微调 Ettin-17M
将生成的标签文件传递给训练脚本,并选择输出目录:
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnews该脚本会微调分类器,在测试集上进行评估,输出测试准确率,并将兼容 Hugging Face 的模型保存到 models/agnews。
步骤 3:训练人工标注基线
不提供教师标签参数,运行相同的训练脚本,使用数据集原有的人工标签进行训练:
uv run recipe/train.py data/tasks/agnews这一对比有助于了解知识蒸馏过程中损失了多少性能。在仓库的教程运行中,人工标签得到 89.2% 的准确率,Kimi K3 标签得到 85.1%,Qwen3.8-27B 标签得到 81.8%。
第 4 步:对新文本进行分类
使用 Hugging Face pipeline 加载已保存的模型:
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
结果是一个包含预测标签及其得分的列表。在本例中,预期类别是 Sci/Tech。报告中的 AG News 模型在 CPU 上处理一条消息约需 6 毫秒。
使用自己的数据训练 Tiny Classifiers
1. 创建任务目录
按照 data/tasks/agnews/ 的相同布局创建文件夹。每个自定义任务都需要 task.json、train.jsonl 和 test.jsonl 文件。
2. 定义类别
task.json 文件必须包含名称、一条指令语句以及完整的标签列表:
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}使用彼此 distinct 且有意义的标签名称。指令应清楚描述模型或教师需要做出的分类判断。
3. 添加训练和测试记录
每行存储一个 JSON 对象。带标签的记录结构如下:
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}如果由教师模型为训练数据添加标签,train.jsonl 中的记录可以省略 label 字段:
{"id":"msg-002","text":"The application closes whenever I upload a file."}测试记录应包含经过核验的标签,以便同时衡量教师和学生模型的准确率。项目建议在生产环境信任模型之前,人工检查几百条测试消息。
4. 添加标签、训练并评估
在标准命令中替换为你的目录:
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
  --save models/support-routing
省略 --labels 后,也可以直接使用人工标签进行训练。若要使用其他编码器替代 Ettin-17M,请通过训练脚本的 --model 选项传入模型。
衡量微调何时值得
准备好任务后,运行盈亏平衡分析:
uv run recipe/breakeven.py该脚本会综合考虑资金和时间,估算在收回标签和训练的前期成本之前必须分类多少条消息。与 Jev 零样本分类 API 相比,该仓库发现盈亏平衡点约为 50,000 至 500,000 条消息,具体取决于任务。
如果你的使用量较小或尚不确定,API 可能是更简单的选择。当任务稳定、已有评估数据且分类量较高时,微调更具吸引力。
高级技巧
优先保证标签质量
实验发现,标签的重要性高于模型规模。随着添加更多带标签的示例,学习曲线仍在持续提升。由教师训练的学生模型通常会比教师低几个准确率百分点,而人工标签可以突破这一上限。
在更改架构或调节大量超参数之前,先检查含义模糊的类别,修正系统性的标注错误,并添加具有代表性的示例。
单独评估教师模型
如果教师模型在任务上的表现不佳,学生模型无法可靠地弥补这一问题。十项任务的结果显示,在教师本身较弱的领域,使用教师标签训练的模型表现会落后。保留一份经过人工核验的测试集,并在付费标注更大规模的数据集之前测量教师准确率。
考虑实验差异
README 报告称,随机种子会带来约 ±0.5 个百分点的差异,测试集大小会带来 ±1.5 至 2 个百分点的差异。发布的表格使用三次运行的平均值。当细微的准确率差异会影响部署决策时,应使用重复运行和足够大的测试集。
遵守许可证和供应商条款
只有在教师模型的许可证和供应商条款允许的情况下,才能仅使用生成的答案进行训练。该仓库使用了 Kimi K3,但部分模型和 API 禁止使用其输出训练其他模型。公共数据集也有各自的许可证;该仓库会下载这些数据集,而不是重新分发它们。
探索替代硬件
主要训练脚本支持 CPU 和 GPU 执行。该仓库还包含一个独立的手机实现,可通过 Chrome 使用 WebGPU 和 jax-js 进行训练。请将手机工作流视为专用实现,并遵循项目 phone/ 目录中的说明。
解决文档所述的 NixOS 问题
如果在 NixOS 上训练时因找不到 /sbin/ldconfig 而失败,请在运行训练前设置 CUDA 库路径:
export TRITON_LIBCUDA_PATH=/run/opengl-driver/lib结论
tiny-classifiers 提供了一套紧凑的工作流,可将带标签的文本转换为快速的本地分类器:准备任务,获取人工或教师标签,微调 Ettin-17M,使用经过核验的示例进行评估,并估算本地推理在经济上是否优于 API。
最重要的经验是投入精力确保标签和评估数据可靠。一旦这些条件具备,一个拥有 17 百万个参数的编码器就能提供出色的分类准确率、毫秒级推理速度和可预测的本地运营成本,而无需为每条消息调用大型模型。