

什么是循环环式 Transformer?
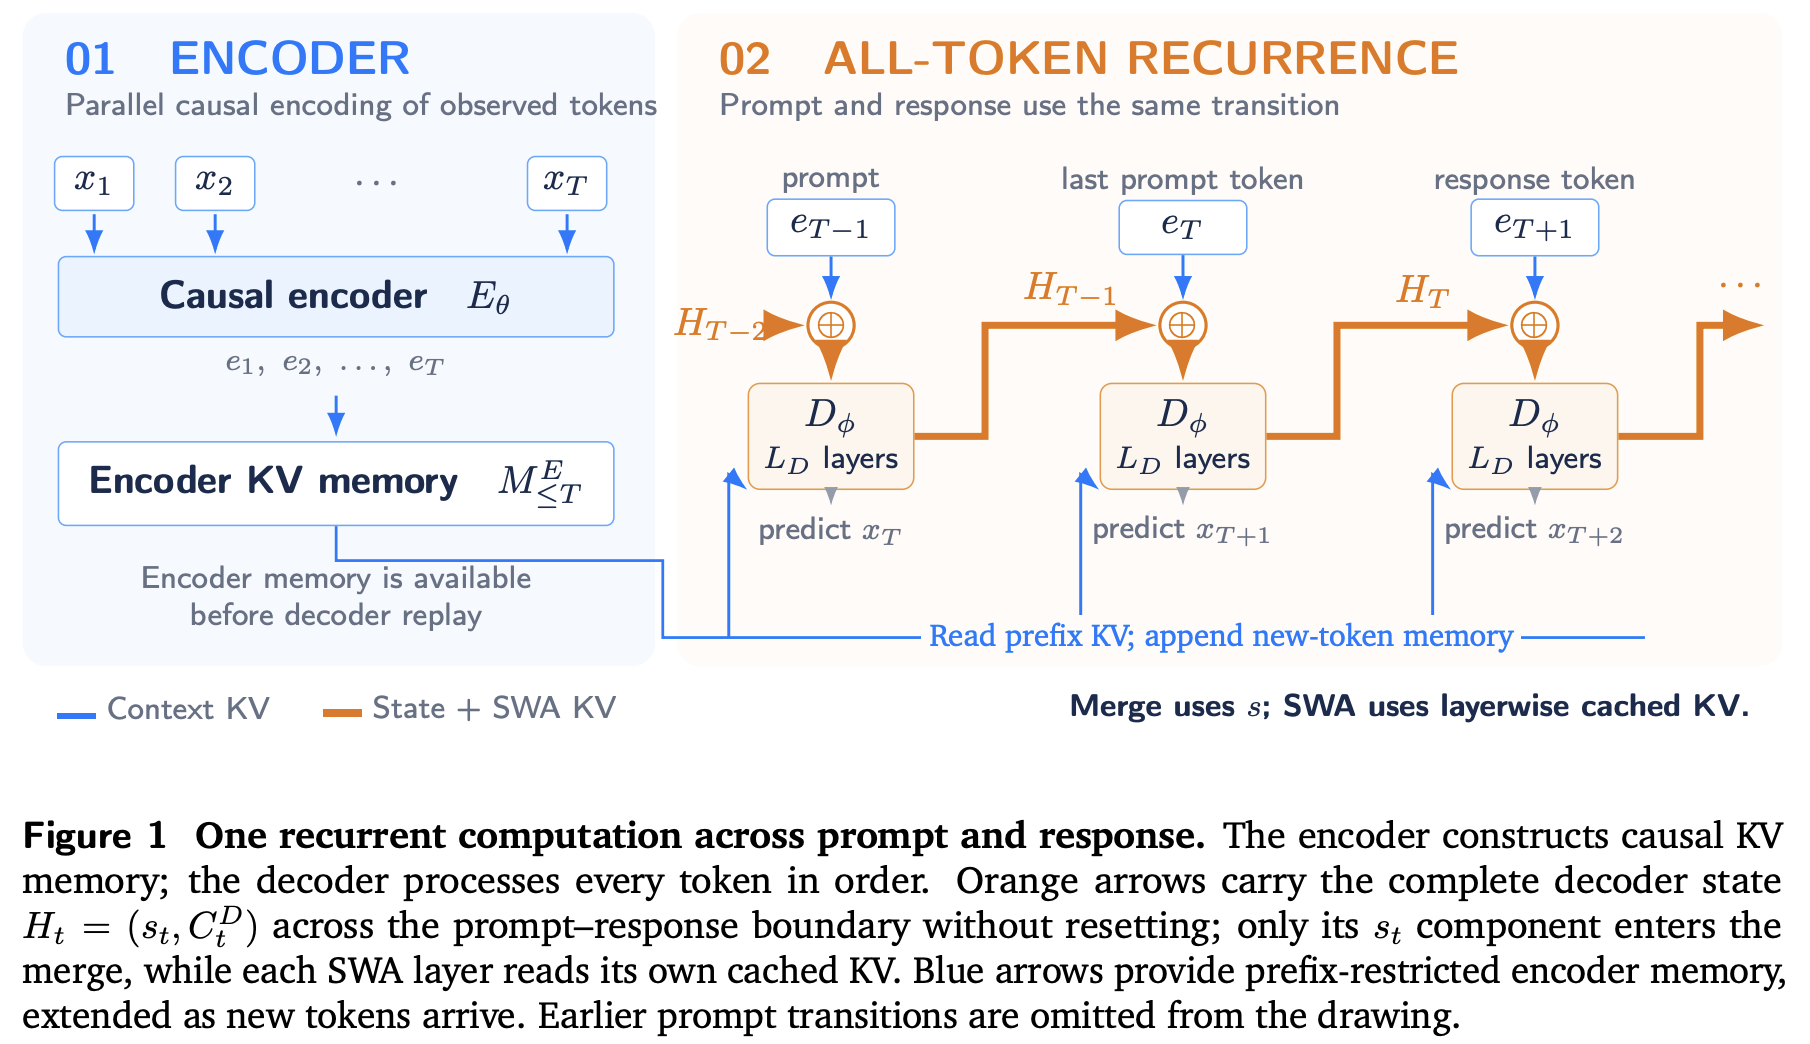
循环环式 Transformer(Recurrent Looped Transformer,RLT)是一种研究架构,旨在让潜在计算贯穿序列中的每个词元。因果编码器构建全局键值记忆,而循环解码器将该记忆与滑动窗口注意力以及上一个最终隐藏状态的反馈结合起来。
这创造了一条可扩展的时间计算路径。如果解码器有 L_D 层,处理 t 个词元就会经过 tL_D 个解码器块组成的循环路径,尽管模型对每个词元只执行固定数量的块。
在本项目中,“无限时间深度”意味着计算路径可以随序列长度增长。这并不意味着模型会在单个词元内执行无限计算。
关键设计原则
1. 跨时间的潜在推理
一个词元的最终解码器输出会成为下一个词元的输入。因此,模型可以在提示词和生成的响应中传播潜在状态,而不是将提示词与响应之间的边界视为重置点。
2. 模型与硬件协同设计
该设计提供了多种潜在的优化机会:
- 对已知词元进行并行因果编码器计算
- 跨独立序列进行批处理
- 复用编码器生成的记忆
- 围绕循环解码器执行进行激活检查点保存
这些属于设计机会和研究目标。报告并未声称已经测得大规模硬件加速效果。
3. 训练与强化学习的共享语义
预训练、监督微调、采样以及当前策略强化学习重放都使用相同的完整状态转移。该状态既包括提示词循环,也包括解码器的滑动窗口键值缓存。
架构的工作方式
对于词元 x_t,因果编码器会生成表示 e_t 和编码器生成的全局记忆 M_≤t。解码器状态同时包含循环输出和逐层滑动窗口注意力缓存:
H_t = (s_t, C_t^D)
H_0 = (s_*, empty)
状态转移为:
(s_t, C_t^D) = D_phi(
  Merge(e_t, s_(t-1)),
  M_≤t,
  C_(t-1)^D,
  t
)
下一个词元的分布根据最终循环输出计算:
p(x_(t+1) | x_(1:t)) = softmax(W_o RMSNorm_o(s_t))三种形式的上下文
- 全局编码器上下文:解码器交叉注意力仅通过当前位置读取编码器记忆,从而保持因果行为。
- 局部解码器记忆:滑动窗口注意力读取最近的解码器键值条目以及当前词元的条目。大小为
W的窗口包含当前词元,因此下一次更新最多保留W - 1个历史条目。 - 时间反馈:上一个最终解码器输出会与当前编码器表示合并。
当序列从提示词进入响应时,循环输出和解码器缓存都不会重置。
具体模型配置
报告描述了一种包含48 个编码器层和 48 个解码器层的配置。兼容的注意力权重和前馈权重在各阶段之间共享。解码器块还会对编码器记忆执行交叉注意力,因此层数相同并不意味着浮点运算次数相同。
安装与仓库设置
README 展示的是一份架构报告,而不是一个有文档说明的软件包。它没有提供依赖要求、安装命令、公开训练脚本或可运行 API。你仍然可以克隆仓库,以阅读论文和配套材料:
git clone https://github.com/yifanzhang-pro/recurrent-looped-tranformer.git
cd recurrent-looped-tranformer
请先查看其中包含的 Recurrent_Looped_Transformer.pdf。你也可以访问项目网站,并阅读预填充与解码内核不匹配说明。
由于 README 没有记录可执行实现,因此不应根据仓库描述推断出软件包安装说明或可直接运行的模型代码。
基本用法:遵循 RLT 执行模型
应用该报告最有用的方式是将其作为实现蓝图。下面的概念性伪代码总结了一次状态转移;它并不是仓库提供的 API:
state = (initial_recurrent_state, empty_decoder_cache)

for each token x_t:
    e_t = causal_encoder_representation(x_t)
    memory = encoder_memory_through_position(t)

    merged = Merge(e_t, state.recurrent_output)
    state = recurrent_decoder(
        merged,
        memory,
        state.decoder_cache,
        position=t
    )

    next_token_distribution = output_head(state.recurrent_output)
提示词预填充
- 以批处理方式对已知提示词词元运行因果编码器。
- 使用解码器对每一个提示词词元进行循环处理。
- 在循环过程中构建解码器滑动窗口键值缓存。
- 保留最终循环输出和缓存,以供生成使用。
仅在提示词预填充阶段运行编码器,无法复现报告中描述的完整 RLT 状态。
自回归生成
- 使用前一状态计算下一个 token 的分布。
- 从该分布中采样一个 token。
- 增量编码采样得到的 token。
- 将该 token 准确地通过循环解码器处理一次。
- 同时更新循环输出和滑动窗口缓存。
这种顺序可避免重复处理生成的 token,并保持与训练期间相同的状态转移语义。
预训练与监督微调
在预训练期间,编码器以因果方式运行,循环解码器使用完整的时间反向传播。每个有效的下一个 token 目标都会受到监督。
在监督微调期间,所有上下文 token 都会更新状态,但损失仅应用于助手目标。即使提示词中的 token 不受监督,提示词仍会参与循环状态构建。
当前策略强化学习回放
当前策略回放必须使用当前模型权重重建完整的序列历史。这包括循环输出、编码器记忆以及解码器的所有滑动窗口缓存。
- 使用当前参数重建编码器表示和记忆。
- 回放此前的每个 token,以重建循环状态和解码器缓存。
- 在处理动作 token 之前,评估该动作的概率。
- 处理该动作一次,使系统推进到下一个状态。
依赖参数的缓存会在权重更新后失效,因此精确回放需要重建这些缓存。完整梯度会经过循环输出、解码器键值条目以及编码器记忆。对其中任何组件进行分离,都会形成梯度近似。
行为策略的对数概率必须对应实际用于采样的分布。精确的重要性采样还要求支持集覆盖。共享执行语义可以减少结构性提示词边界不匹配,但无法保证不同内核之间的数值一致性,也无法保证无偏的离策略目标。
初步合成结果
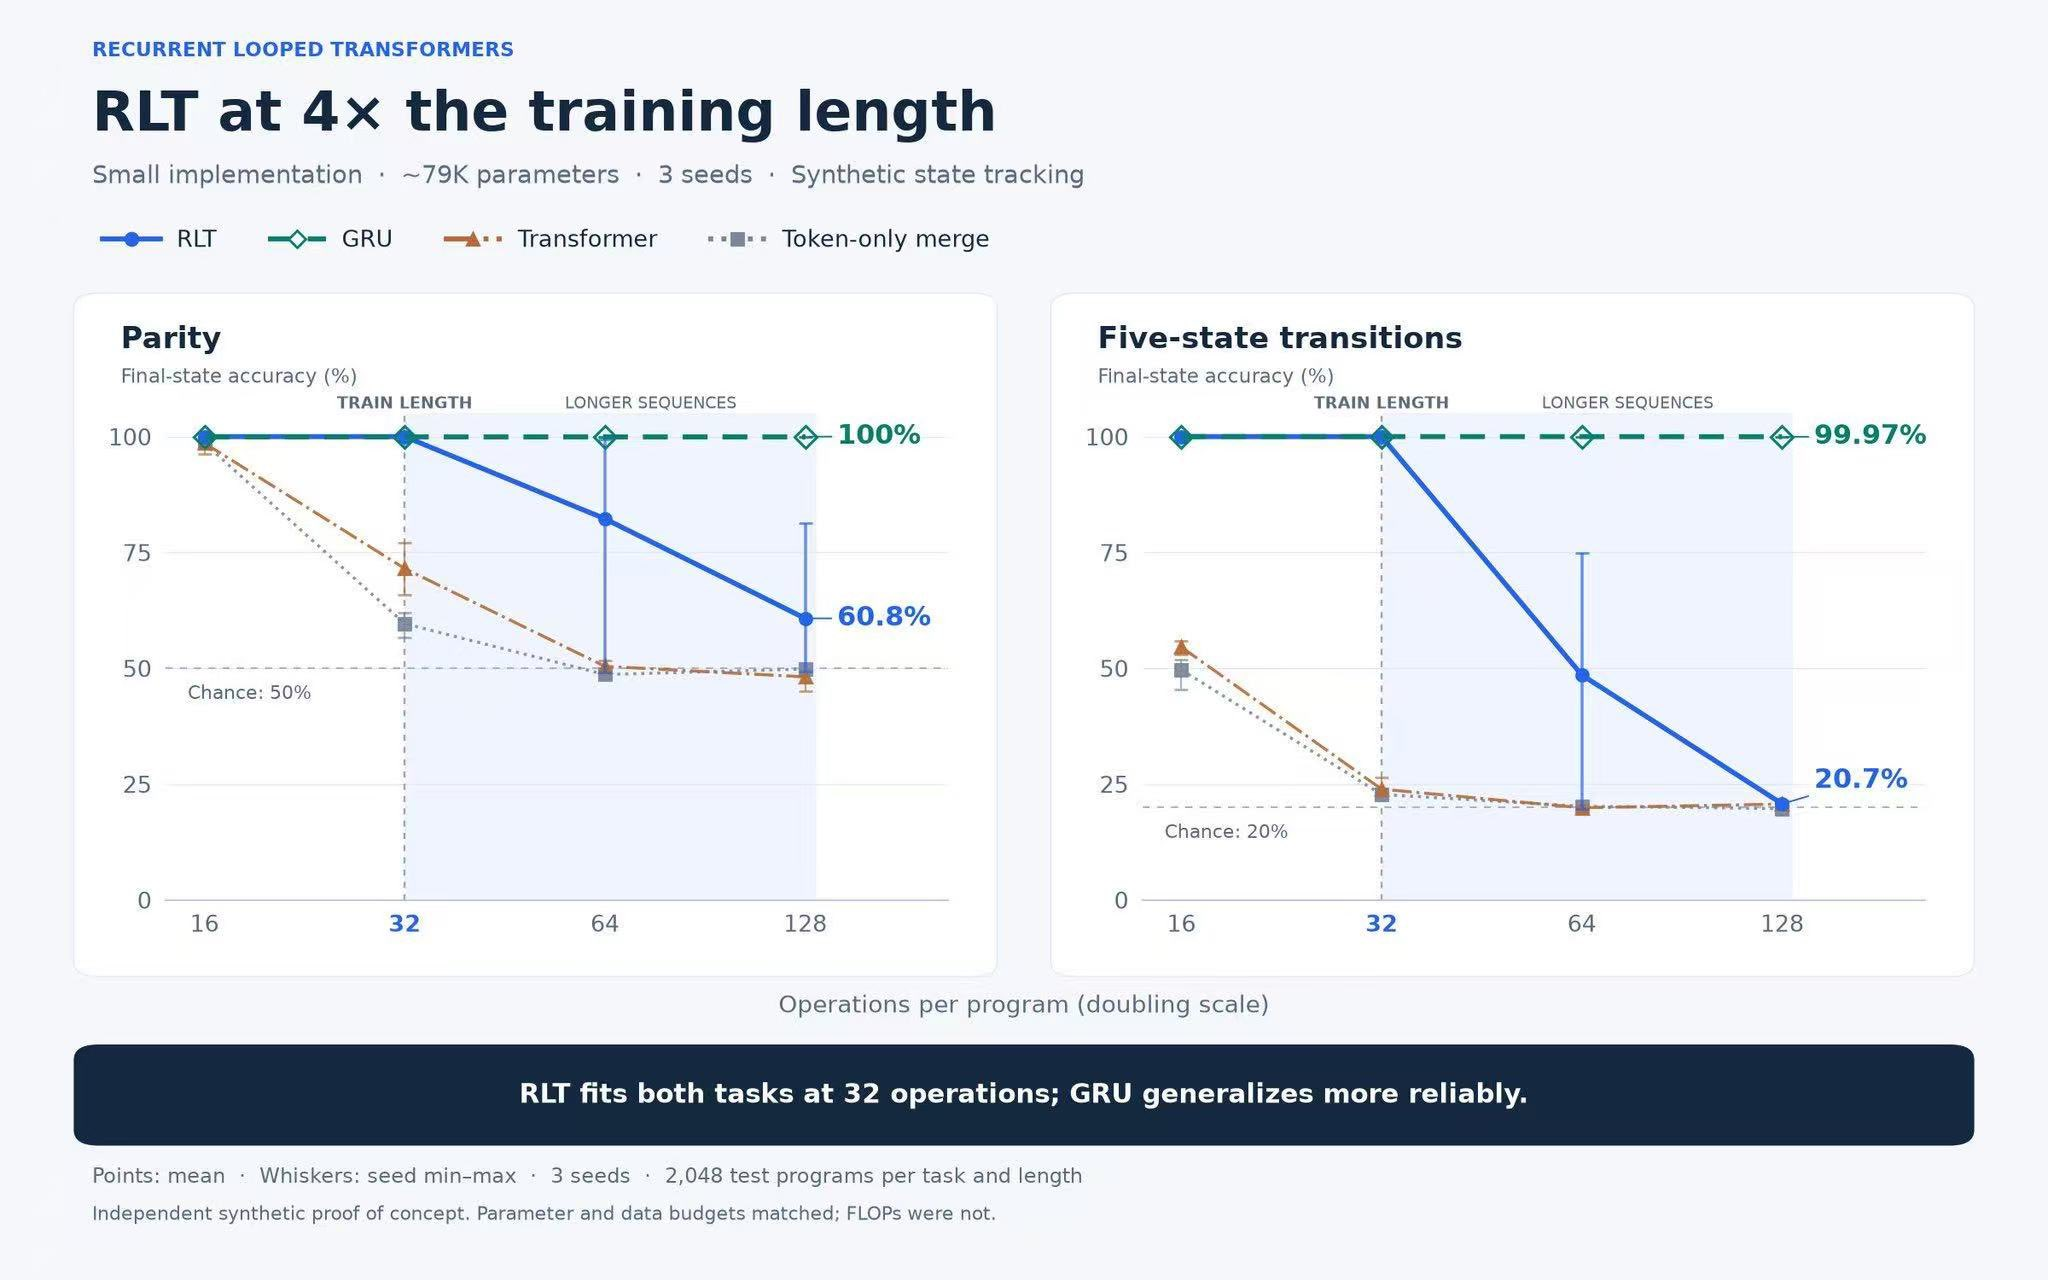
README 报告了独立的概念验证状态跟踪实验。实验使用了一个约含 79,000 个参数 的小型实现和 三个随机种子。模型在包含 32 个操作的序列上训练,并在最多 128 个操作的序列上评估;每项任务和每种长度均使用 2,048 个测试程序。
奇偶校验任务
- 在 32 个操作时,RLT 的最终状态准确率约为 100%。
- 在 64 个操作时,准确率约为 82%。
- 在 128 个操作时,准确率为 60.8%。
- 奇偶校验的随机准确率为 50%。
五状态转移任务
- 在 32 个操作时,RLT 的最终状态准确率约为 100%。
- 在 64 个操作时,准确率约为 49%。
- 在 128 个操作时,准确率为 20.7%。
- 该任务的随机准确率为 20%。
结果表明,RLT 在训练长度上能够拟合这两项任务,但在更长序列上的准确率有所下降。标记为近似的数值读取自原始图表,而 128 个操作时的 RLT 数值则在图中以数字标注。
参数预算和数据预算保持一致,但浮点运算预算并不一致。这些实验是合成演示,不代表大规模推理能力提升、硬件加速或强化学习扩展性。
高级实现提示
- 将完整状态视为不可分割整体:同时保留
s_t和C_t^D。仅恢复循环向量无法复现文档中描述的状态转移。 - 不要在响应边界重置:提示词循环状态及其解码器缓存必须直接流入响应生成过程。
- 准确定义窗口:大小为
W的滑动窗口包含当前 token,因此下一次更新时只能保留W - 1个历史条目。 - 更新后重建缓存:当前策略回放需要使用当前权重生成的缓存,而不是早期策略留下的缓存值。
- 保持采样与回放顺序一致:根据前一状态评估生成的动作,然后只处理该动作一次。
- 区分精确梯度与近似梯度:分离循环状态、解码器缓存或编码器记忆会改变梯度路径。
- 单独测量计算量:参数预算或数据预算相同,并不能证明 FLOPs 相同,尤其是因为解码器层增加了编码器记忆交叉注意力。
- 验证数值行为:共享的高级执行语义不会自动消除预填充内核与解码内核之间的差异。
结论
循环式 Transformer 将全局因果编码器记忆、局部解码器滑动窗口注意力以及 token 到 token 的循环反馈结合起来。其核心实现规则是一致性:每个提示词和响应 token 都必须在预训练、微调、生成和当前策略回放过程中参与相同的完整状态转移。
初步实验表明,该架构在小型状态跟踪任务上具有一定的长度泛化能力,但性能在超出训练长度后仍会下降。因此,应将该架构视为研究提案和概念验证,而不是经过验证的大规模推理系统。