

研究生招生智能体基准测试的作用
研究生招生智能体基准测试用于评估研究生招生咨询场景中的智能体配置。智能体配置由执行系统和语言模型组成,并接受申请推荐、规划、决策,以及在获得新的学生信息后更新建议等方面的测试。
该基准测试目前包含70项中文任务、23个案例和83个答题阶段。每项任务都配有评估标准和参考项目。公开数据集无需获得访问批准即可使用,但评测材料应对被评估的智能体保持不可用,以避免结果受到污染。
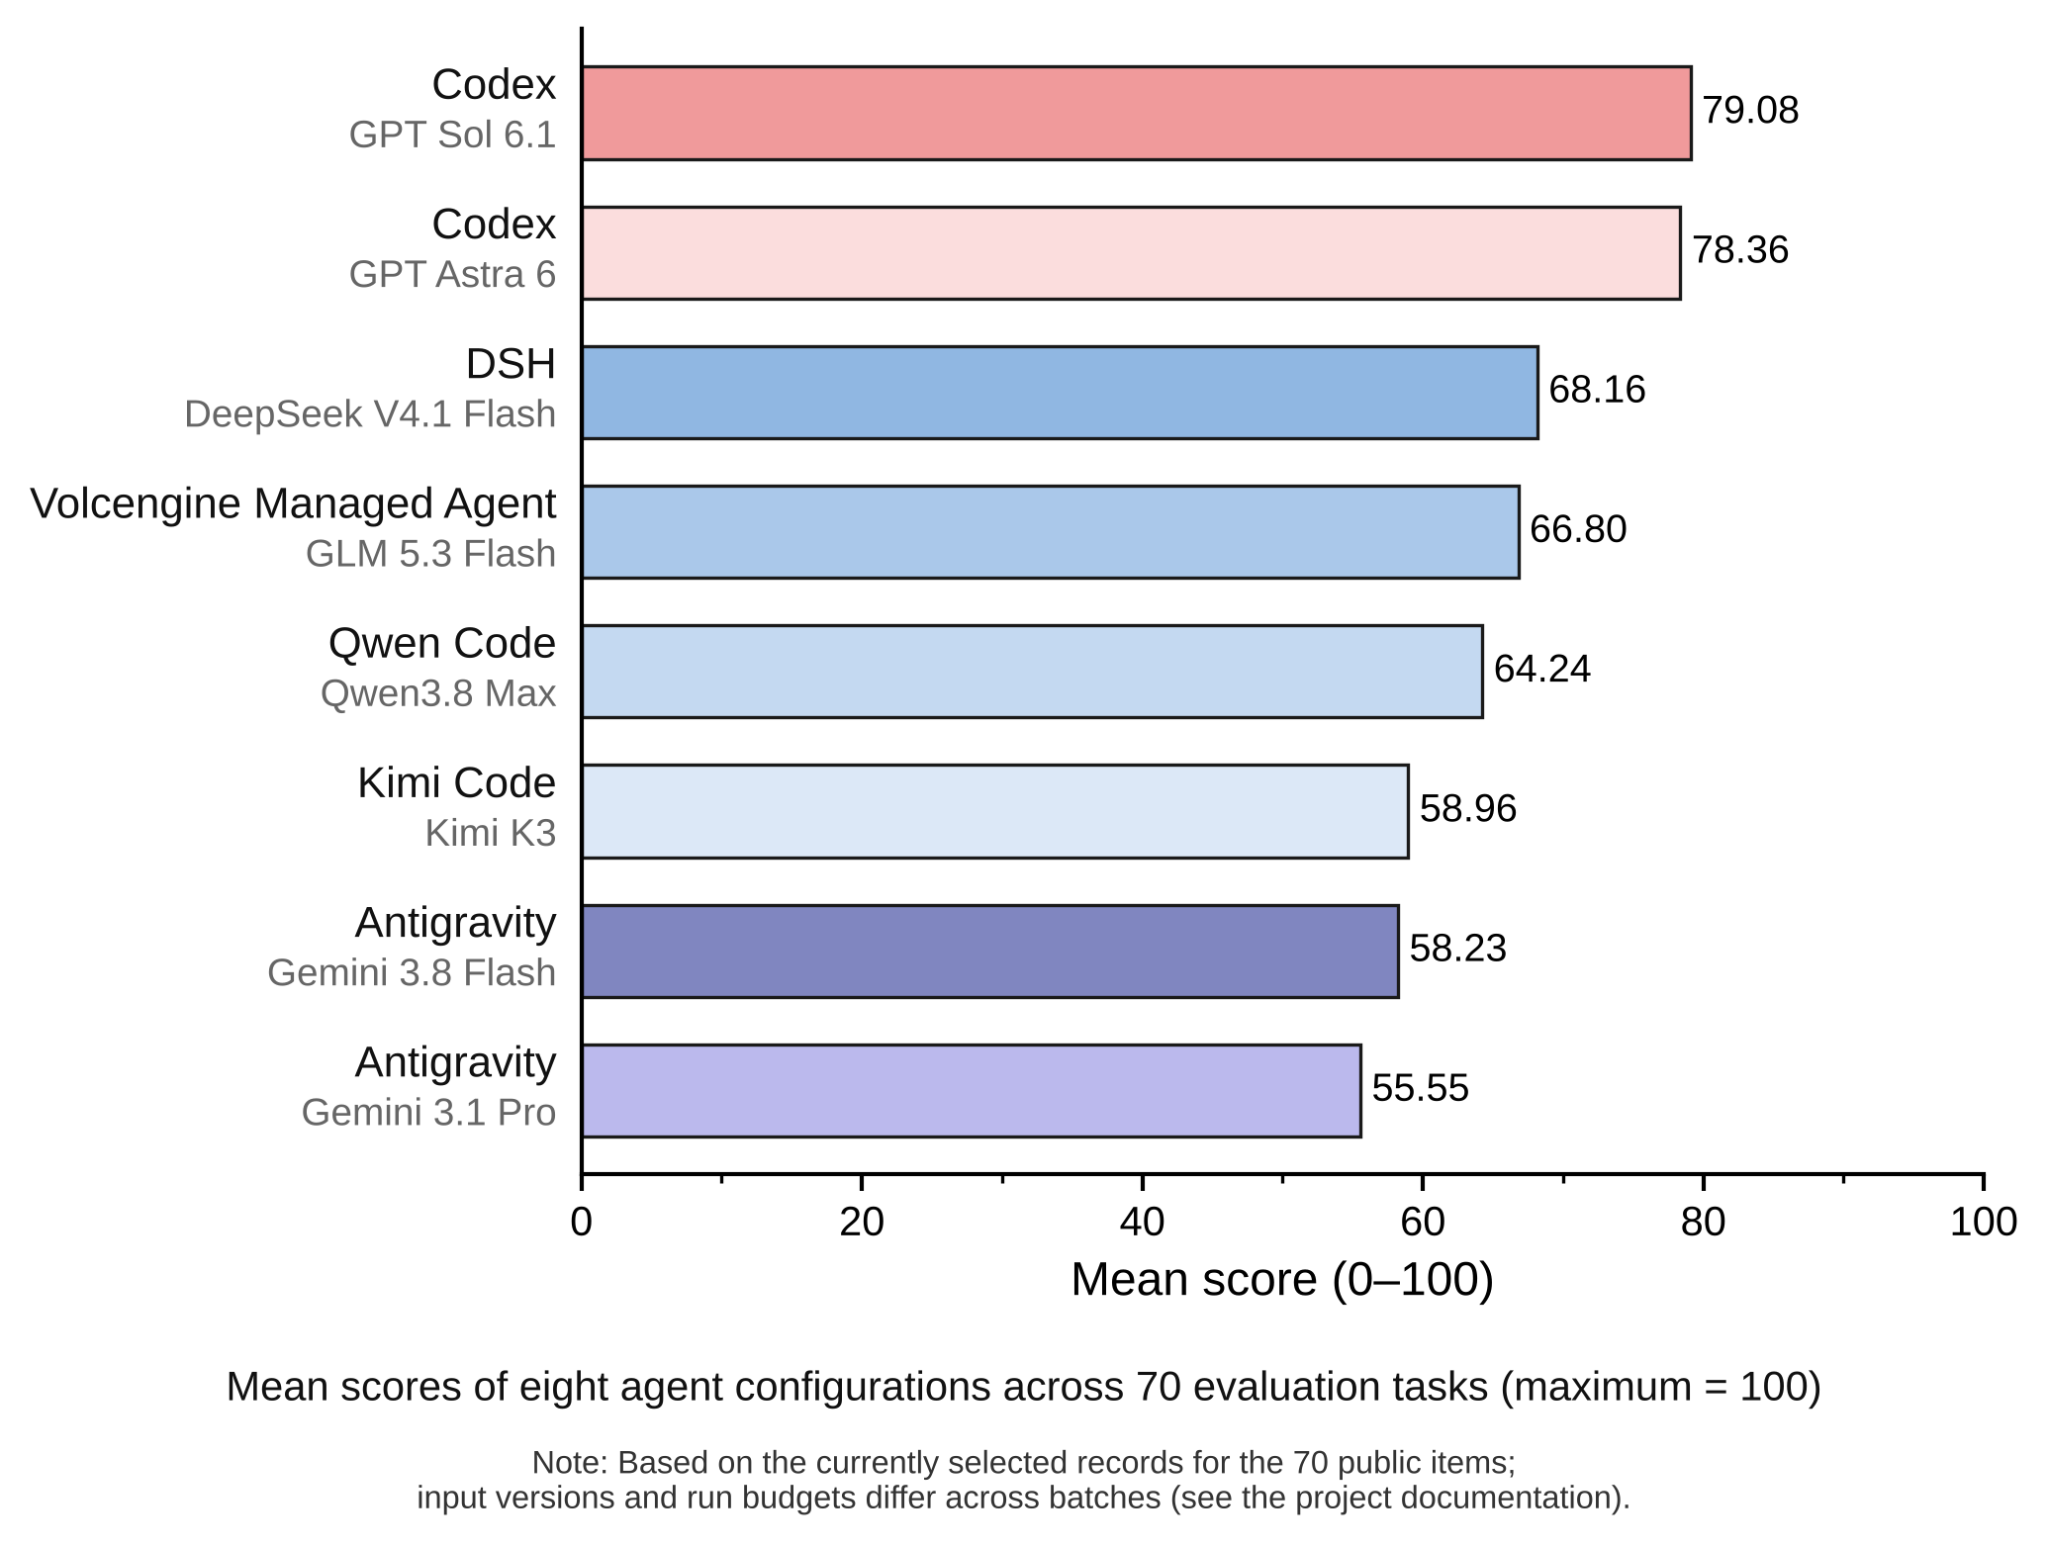
该仓库还发布了8种配置的评测记录。每种配置都完成了当前的70项任务,但项目说明指出,各次运行使用了不同的输入版本和预算,因此排行榜结果不应被视为完全统一的实验。
了解评测结构
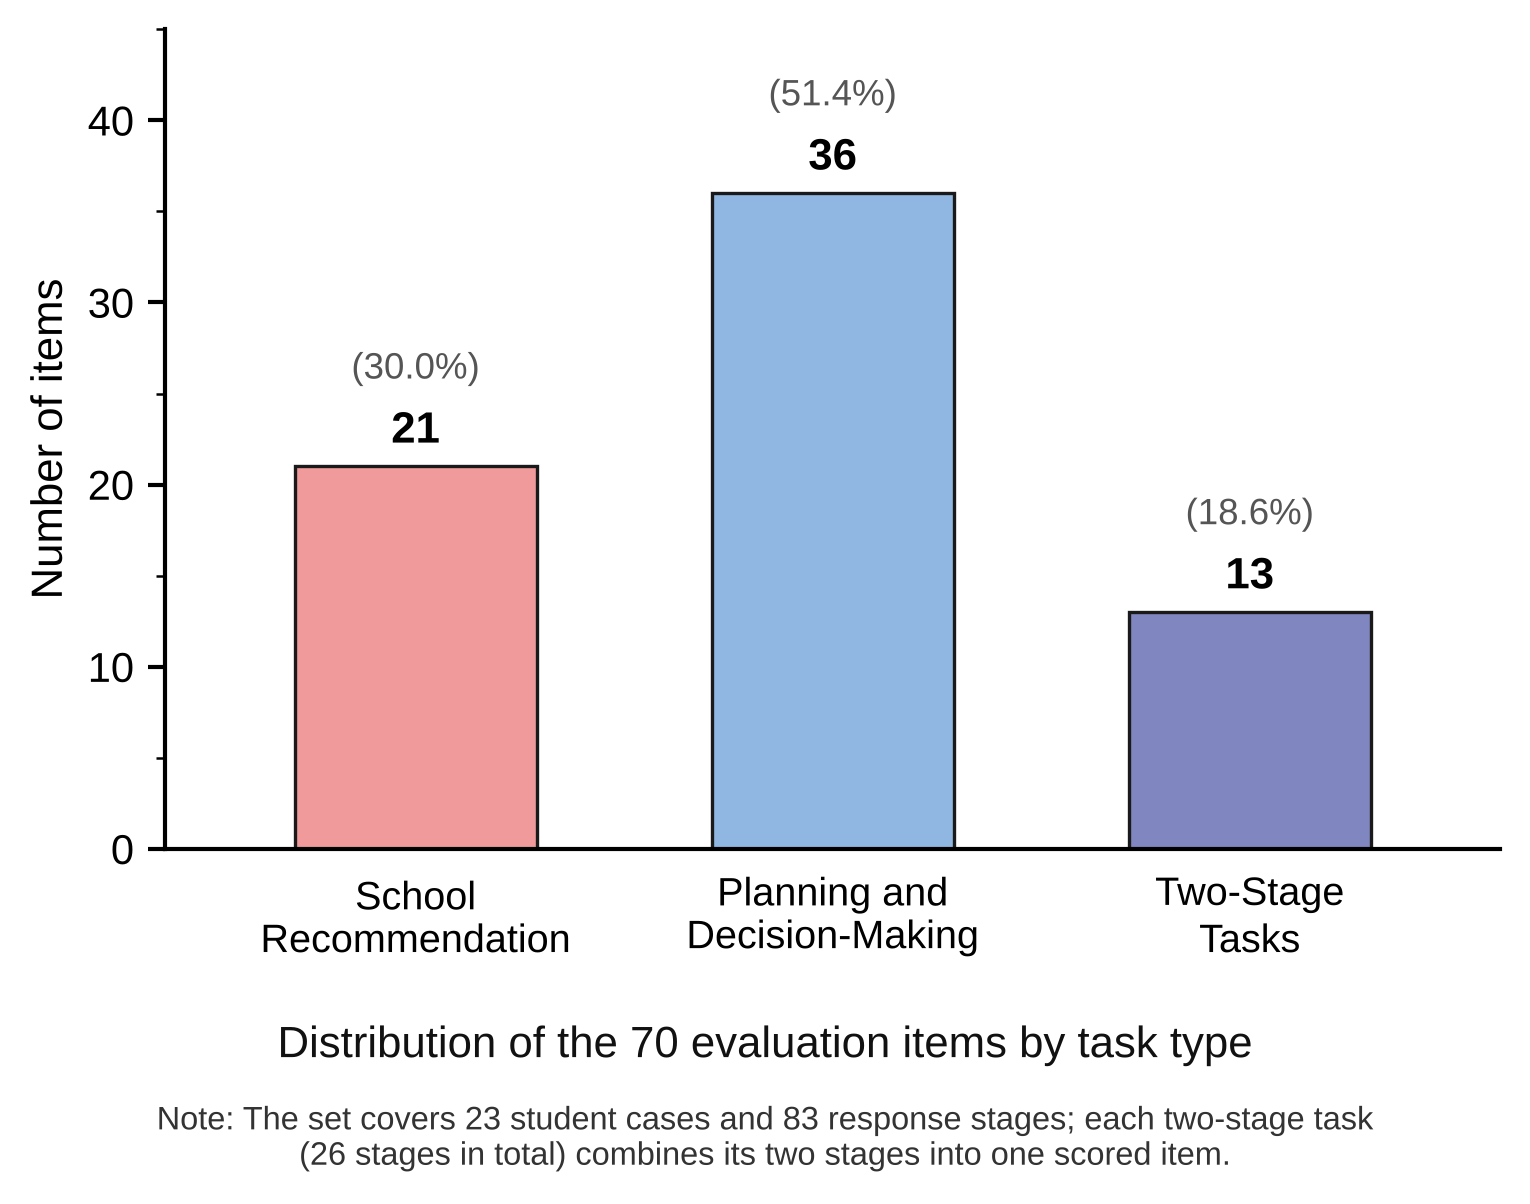
任务集合分为三类:
- 21项推荐任务:评估推荐项目与学生背景及限制条件的匹配程度。
- 36项规划与决策任务:评估准备计划、风险分析和可执行建议。
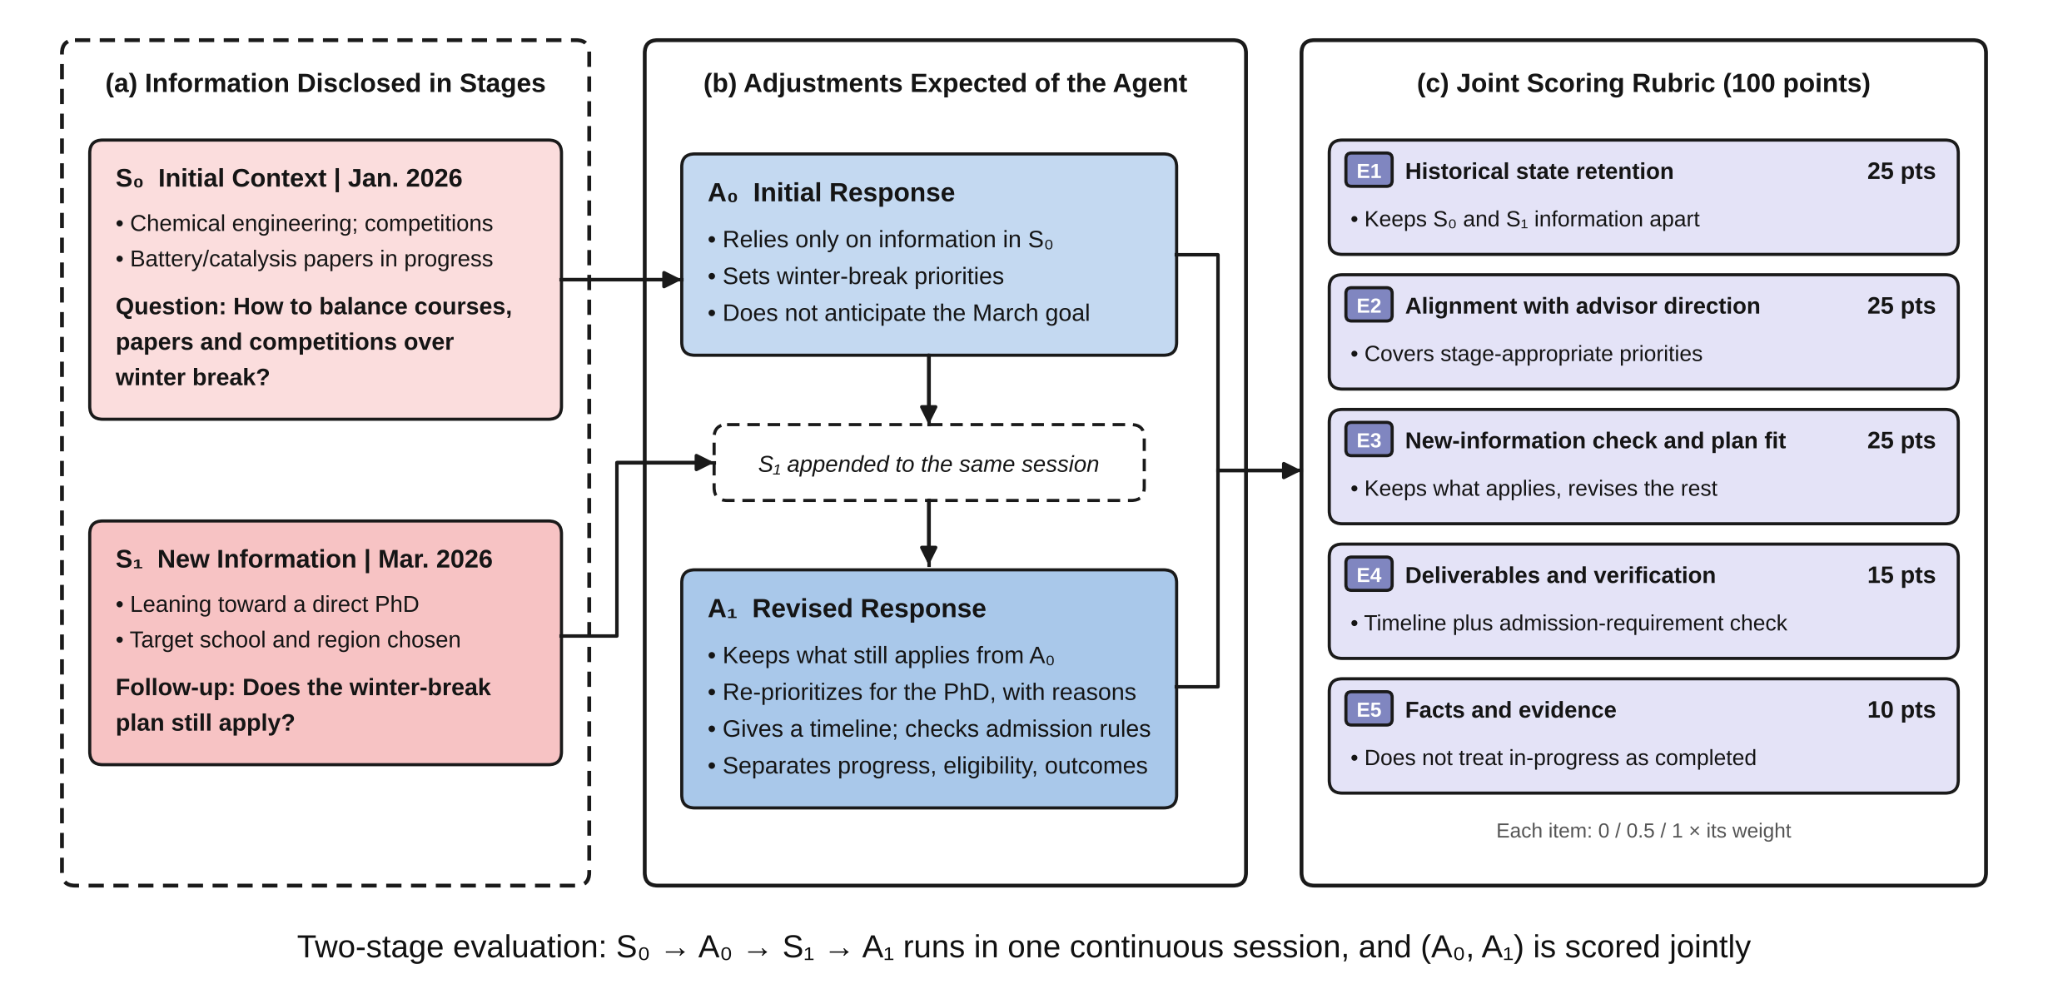
- 13项两阶段任务:在同一会话中提供新信息,测试智能体是否会修正先前的建议。
每项任务满分100分。推荐任务将70分分配给参考项目匹配度,30分分配给推荐质量。独立评审员会对完整答案进行评分,而评测标准不会出现在答题过程中。
两阶段任务首先提供初始上下文,称为S₀,随后提供更新信息,称为S₁。智能体在同一会话中生成初始答案A₀和修订答案A₁。两次回答会被联合评分。公开的O03-04示例展示了一个从1月到3月的场景,其中学生转而申请直博项目。
准备环境
请从仓库根目录运行命令。自动原生执行需要macOS Seatbelt和Python 3.10或更高版本。Kimi订阅配置需要Python 3.11或更高版本。
该框架仅使用Python标准库,因此仓库不需要执行pip install。不过,你必须安装所要运行配置对应的官方客户端,并准备好订阅登录信息或API密钥。
可用客户端包括Codex、Claude Code、Antigravity、DeepSeek Harness、Qwen Code和Kimi Code。不同客户端的身份验证方式有所不同:部分配置使用订阅或OAuth,而DeepSeek和Qwen使用基于API的身份验证,具体说明请参阅项目文档。
选择智能体配置
智能体ID来自仓库当前的注册表config/agents-cli.example.json。这些ID是基准测试配置标识符,并非直接传递给模型的参数。
gpt-6-astra用于搭配GPT Astra 6的Codexgpt-6-1-sol用于搭配GPT Sol 6.1的Codexclaude-opus-5-5用于搭配Claude Opus的Claude Codeclaude-sonnet-5-5用于搭配Claude Sonnet的Claude Codeantigravity-gemini-3-8-flash-high用于搭配Gemini Flash的Antigravitydeepseek-v4-1-flash用于搭配DeepSeek Flash的DeepSeek Harnessqwen3-8-max-0902用于搭配Qwen Max的Qwen Codekimi-k3用于搭配Kimi K3的Kimi Code
运行快速入门流程
每种配置都使用相同的基准测试流程。首先,将智能体ID赋值给AGENT shell变量:
AGENT=gpt-6-1-sol接下来,保存本地配置:
python3 -m benchmark setup --agent "$AGENT"
检查所选客户端和身份验证是否已准备就绪:
python3 -m benchmark cli-check --agent "$AGENT"当检查返回ready_for_trial时,使用当前任务选择运行批次:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
--agent "$AGENT" --out "./runs/current-$AGENT"默认情况下,批量执行会预览70项任务和83个阶段,但不会调用模型。准备使用账户额度时,请添加--execute:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
--execute在cli-check成功后,先运行一项试验任务。这有助于在启动完整批次前确认客户端、身份验证模式、沙箱和输出位置均能正常工作。
运行多种配置
分别配置并检查每个客户端,然后向批处理命令传入多个 --agent 选项。请使用新的输出目录,以免不同配置的结果相互覆盖。
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
确保每个配置的身份验证模式与注册表中列出的客户端保持一致。基于订阅的配置应使用其支持的订阅登录方式,而 API 配置应使用所需的 API 凭据。
检查任务和结果
任务索引位于 config/selections/current.json。有关问题、评判标准和评分定义,请参阅问题与评分、数据格式指南和评分规则。
已发布的结果有多种形式:
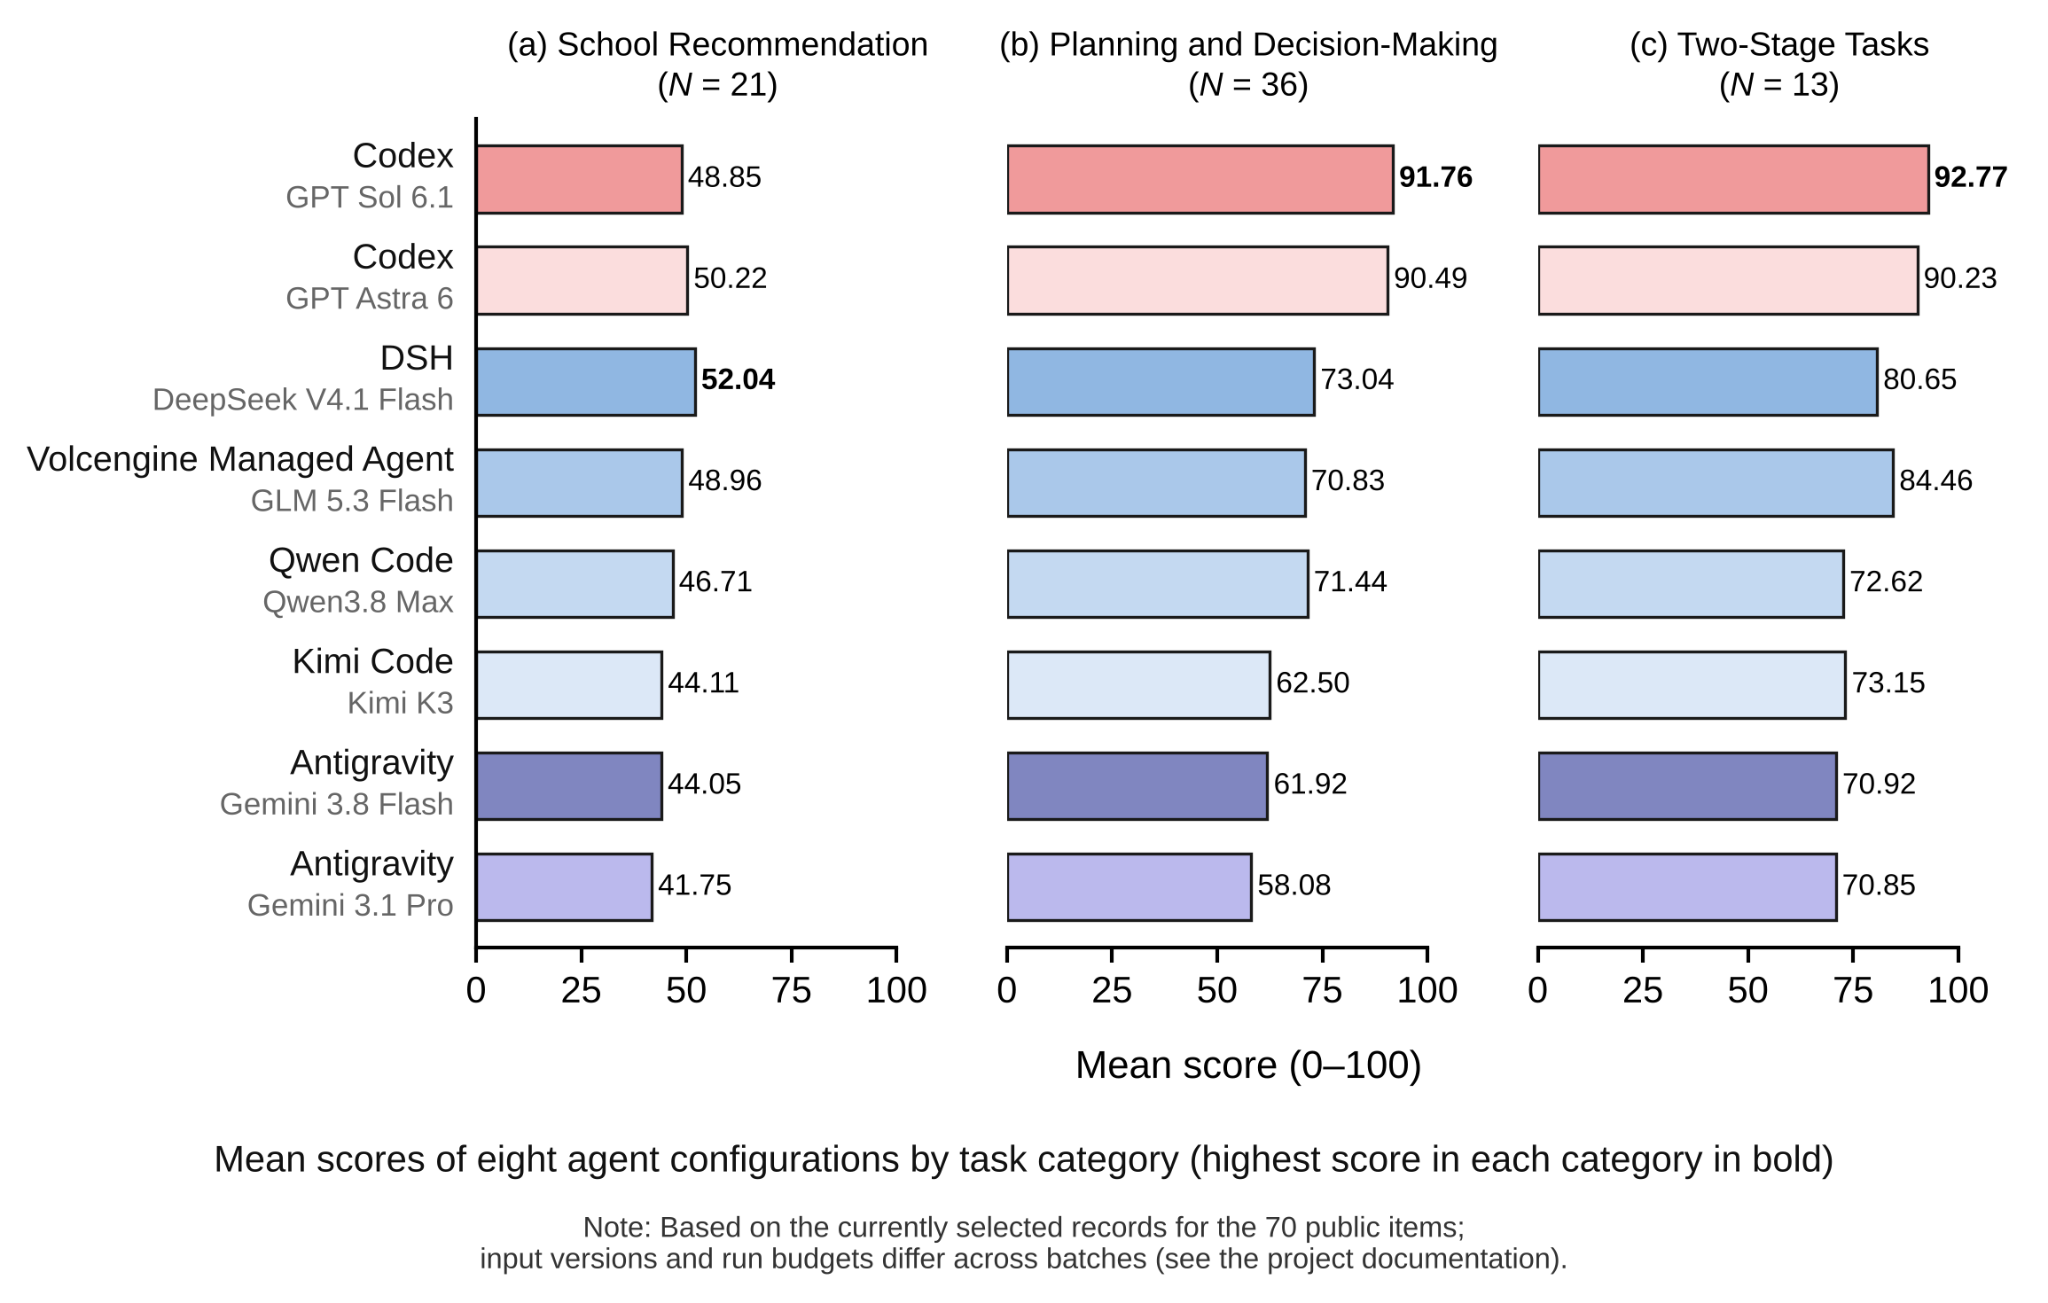
- 评分摘要,提供汇总结果。
- 逐任务结果,提供详细的任务级记录。
- 按配置划分的答案和分数,提供公开答案文本和评估信息。
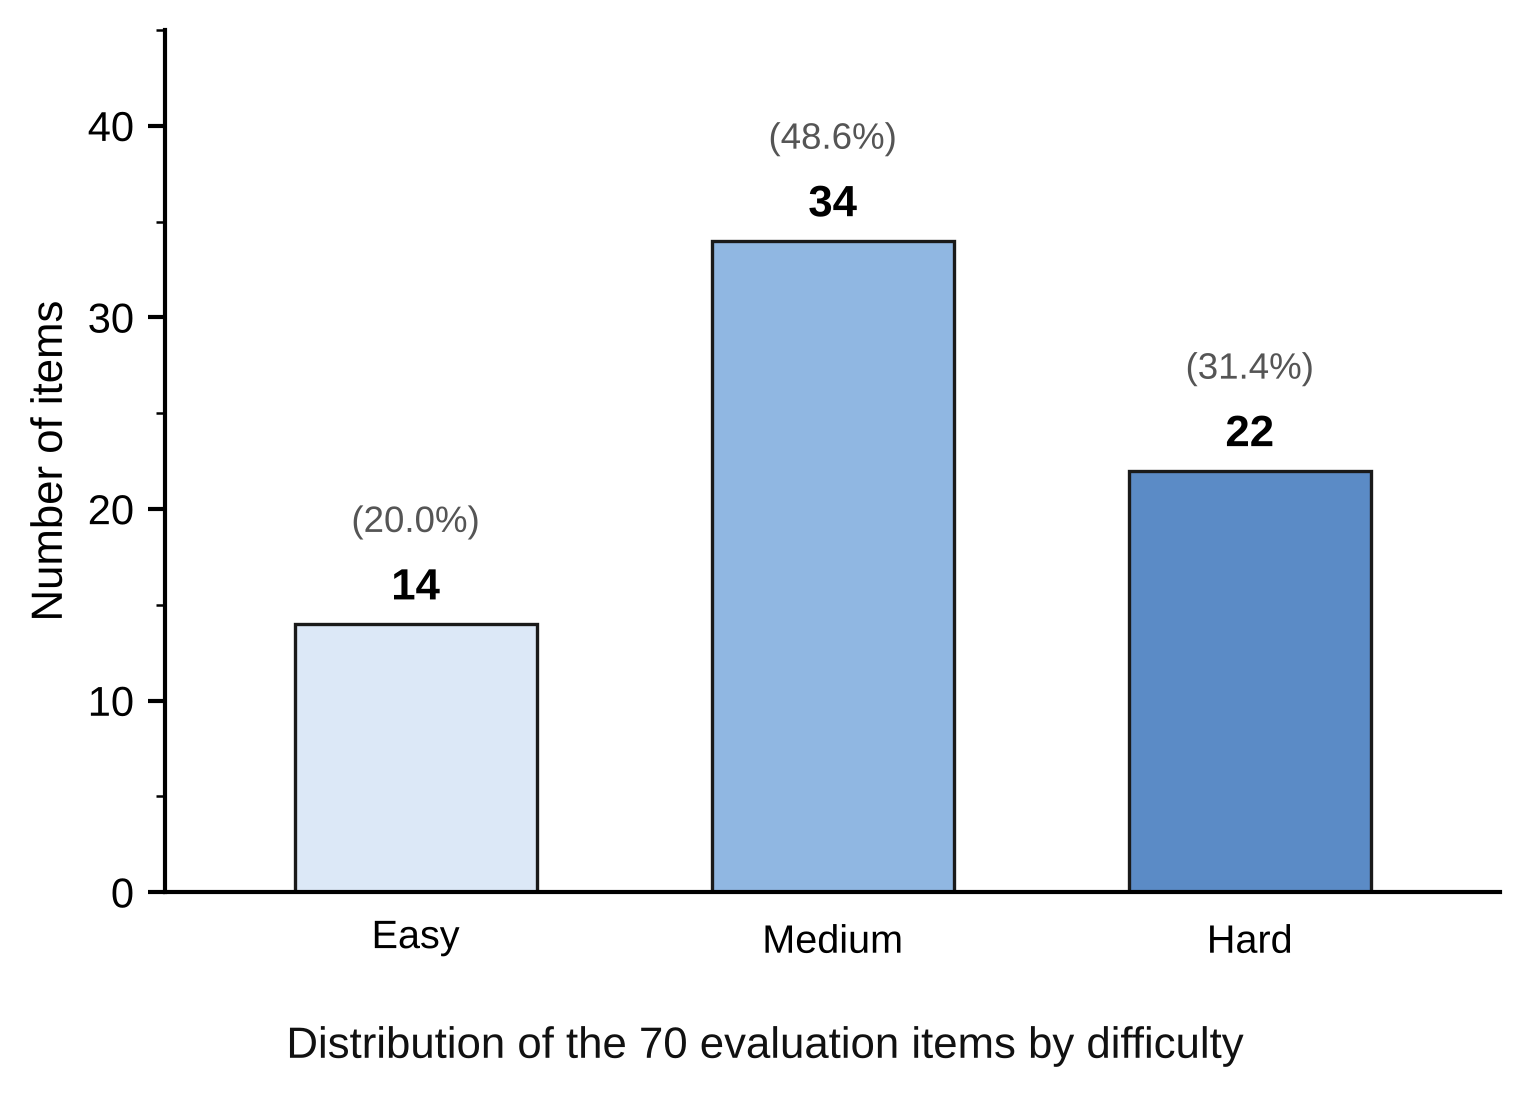
已发布的排行榜报告了八种经过评估的配置的平均分数和完成率。该仓库还记录了当前任务的难度标签:14 个简单、34 个中等和 22 个困难。这些标签经过教师校准并由任务负责人确认,并不代表独立的双重复核结果。
评分与复核提示
评分可能会使用单独的 Codex 订阅会话来复核导出的材料。可选的 API 评判需要额外配置。请将答题过程与评分材料分开,因为向受评估代理暴露评分标准或参考程序可能会使比较失效。
比较自己的运行结果时,请记录代理 ID、客户端版本、输入版本、执行预算、输出目录以及任何相关的内容哈希。该项目提醒,公开排行榜中的运行并不都具有完全相同的执行条件,因此应结合其方法和运行记录来比较结果。
如需进行可复现实验,请遵循复现指南,其中涵盖固定输入、提交内容和分数验证。方法文档解释了评估设置和局限性,而原生 CLI 指南则进一步介绍安装、身份验证和多个阶段。
结论
Graduate Admissions Agent Benchmark 提供了一种结构化方式,用于测试招生代理能否在学生情况发生变化时,给出准确的建议、有用的规划指导和恰当的更新。请设置受支持的客户端,从注册表中选择代理 ID,使用 cli-check 进行验证,预览批处理,然后执行试验或完整评估。请使用已发布的任务定义、结果和方法文档,负责任地解读分数并复现比较结果。