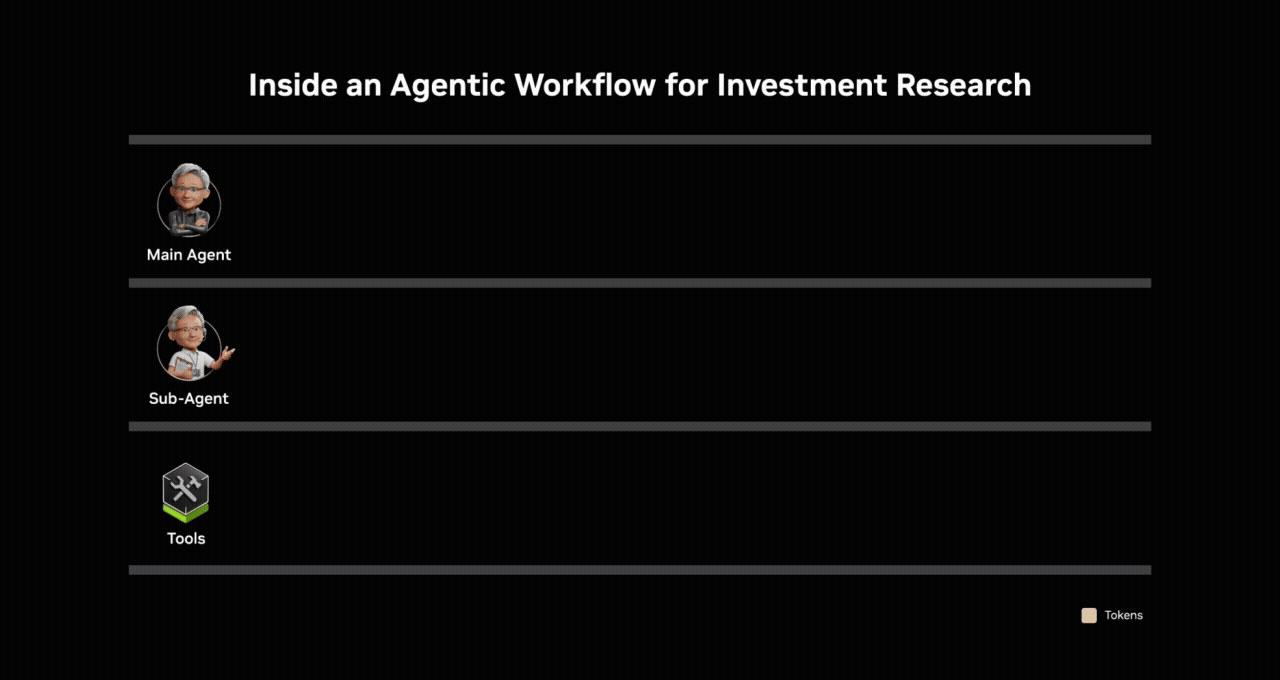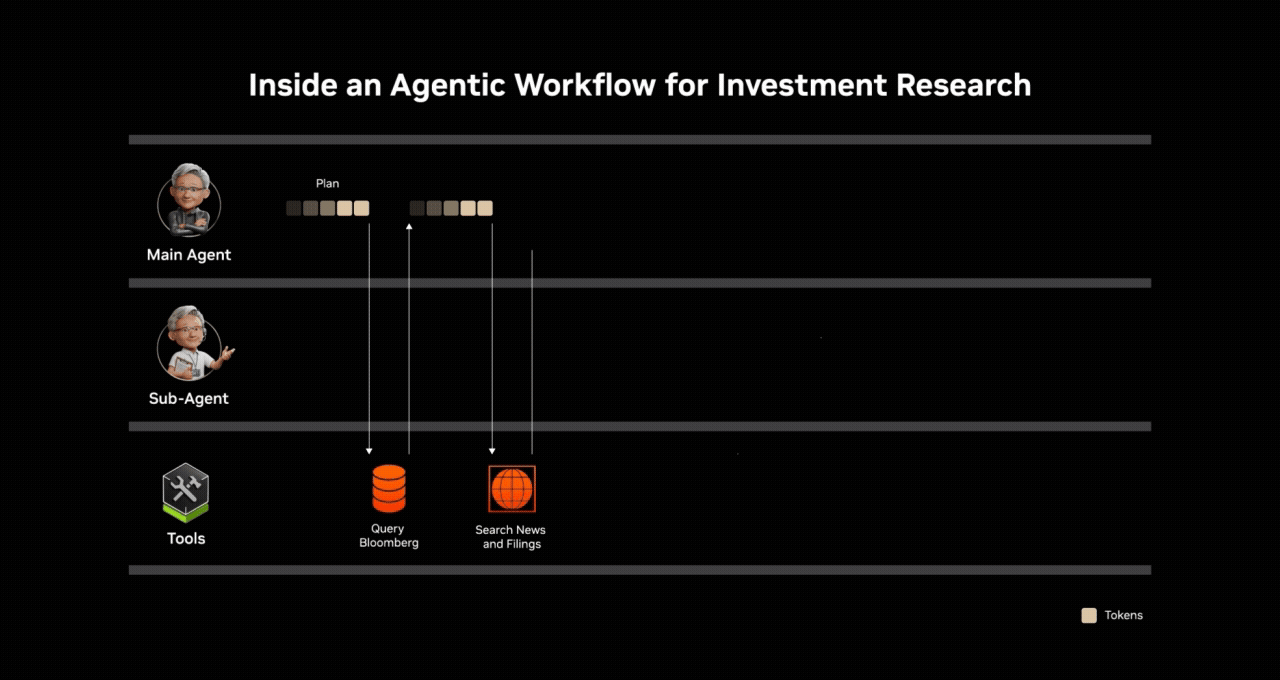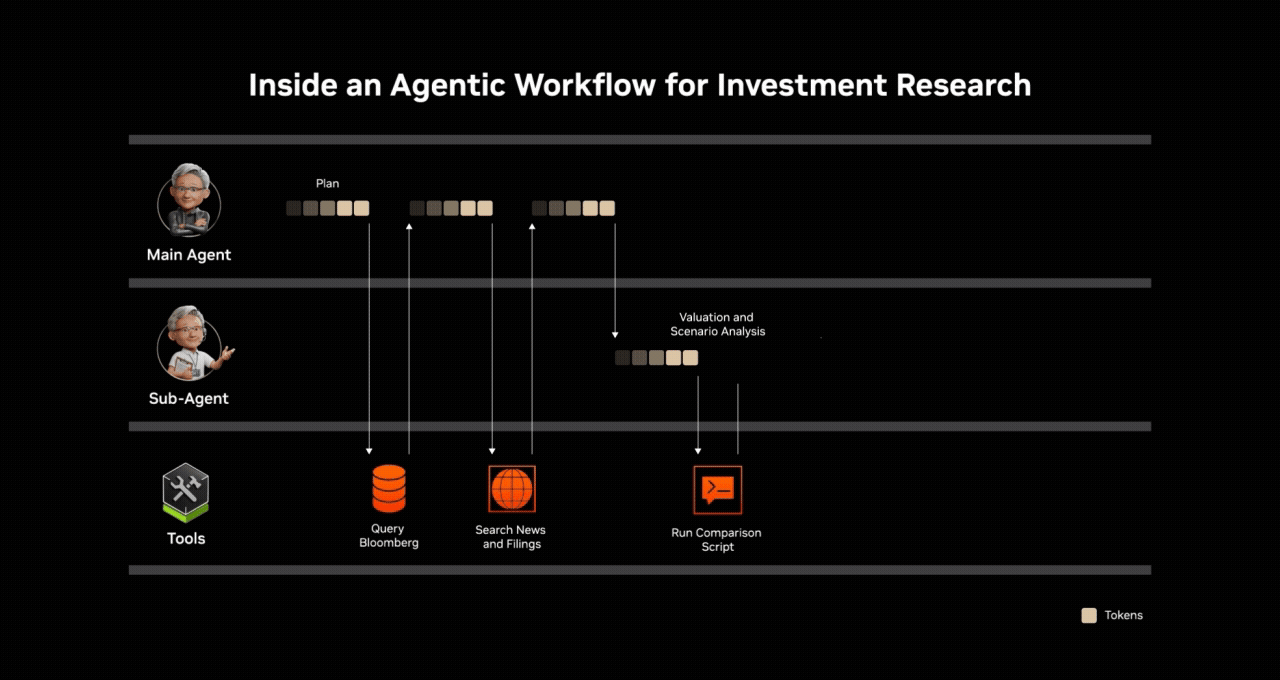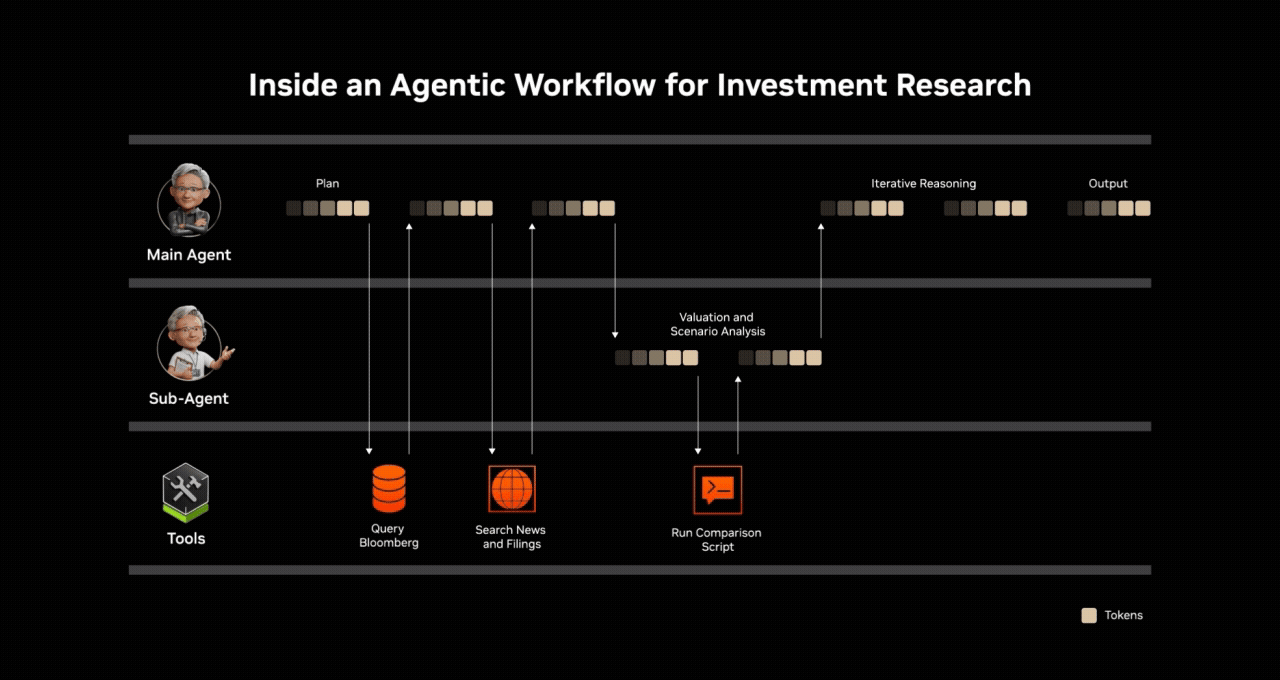
NVIDIA نے گزشتہ روز SemiAnalysis AgentX workload استعمال کرتے ہوئے DeepSeek-v4-PRO 1.6T ماڈل کا جائزہ اور ٹیسٹ کیا، جس سے ظاہر ہوا کہ Vera Rubin کی فی میگاواٹ تھروپٹ Blackwell سے 30 گنا زیادہ ہے۔
فی میگاواٹ تھروپٹ (Tokens per Megawatt، مختصراً tokens / MW) AI ڈیٹا سینٹر کی مقررہ بجلی کی حد میں پیدا کیے جانے والے AI Tokens کی مقدار ناپنے کا بنیادی توانائی کارکردگی اشاریہ ہے۔
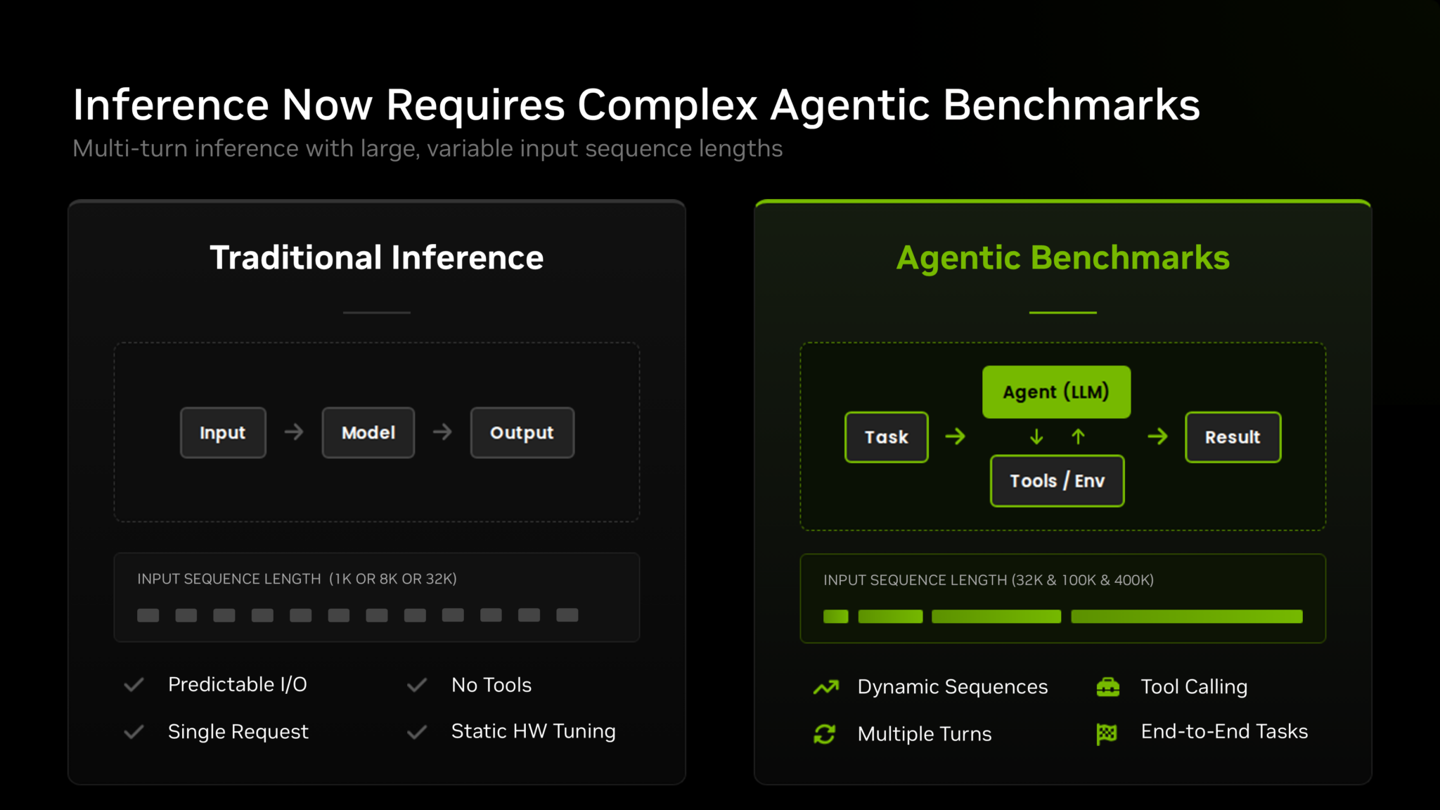
IT ہوم نے بلاگ پوسٹ کے حوالے سے بتایا کہ SemiAnalysis AgentX نے ایجنٹک پروگرامنگ اور استدلال کی workloads کا جائزہ لینے کے لیے 4 اشاریے استعمال کیے:
اینڈ ٹو اینڈ معمول پر مبنی تعامل پذیری، درخواست جمع کرانے سے آخری Token کے موصول ہونے تک کے مکمل وقت کے حساب سے ناپی جاتی ہے۔ یہ پہلے Token کے انتظار کے وقت سمیت صارف کو نظر آنے والی آؤٹ پٹ کارکردگی کی عکاسی کرتی ہے؛
معیاری تعامل پذیری صرف پہلے Token سے آخری Token کے درمیان کے تخلیقی مرحلے کو شمار کرتی ہے۔
اینڈ ٹو اینڈ تاخیر، ایک درخواست جمع کرانے سے آخری آؤٹ پٹ Token کے موصول ہونے تک کا مجموعی وقت شمار کرتی ہے۔
پہلے Token کی تاخیر (TTFT) درخواست جمع کرانے سے پہلے آؤٹ پٹ Token کے موصول ہونے تک کا وقت شمار کرتی ہے۔
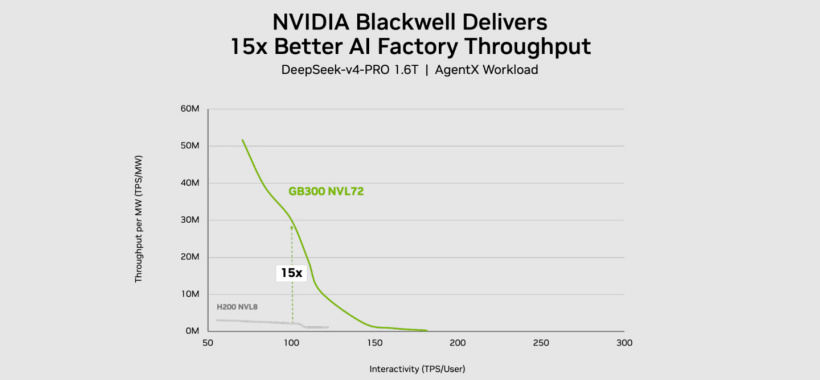
DeepSeek-v4-PRO 1.6T workload میں GB300 NVL72 پر مبنی Grace Blackwell سرور کی فی میگاواٹ تھروپٹ، H200 NVL8 Hopper حل کے مقابلے میں 15 گنا زیادہ ہے۔
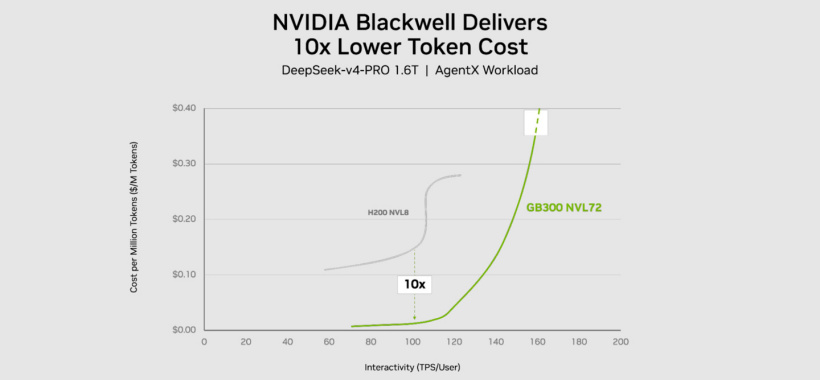
Blackwell پر فی ملین Token لاگت گزشتہ نسل کے مقابلے میں تقریباً 1/10 ہے۔ آپریٹرز اسی بجلی اور بنیادی ڈھانچے کے بجٹ میں زیادہ ایجنٹس کو سپورٹ کر سکتے ہیں، یا کم آپریٹنگ لاگت کے ساتھ اتنی ہی ایجنٹ صلاحیت برقرار رکھ سکتے ہیں۔
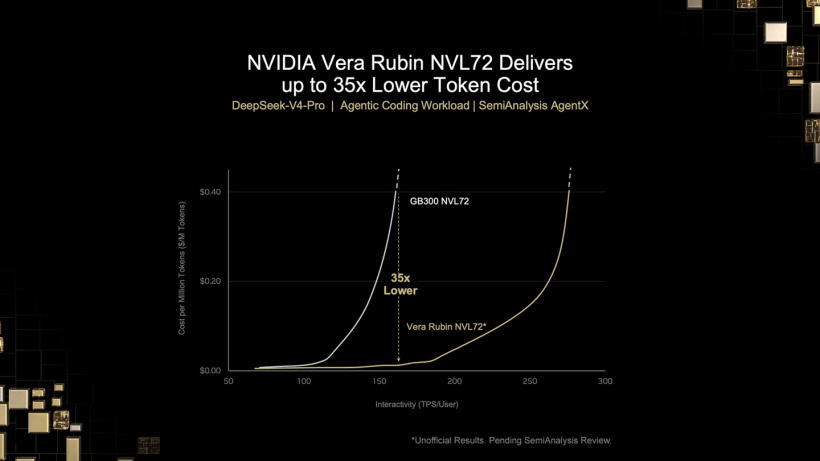
Vera Rubin اس برتری کو مزید بڑھاتا ہے۔ DeepSeek V4 Pro ماڈل پر Vera Rubin NVL72 کی فی میگاواٹ تھروپٹ، GB300 NVL72 کے مقابلے میں تقریباً 30 گنا ہے۔
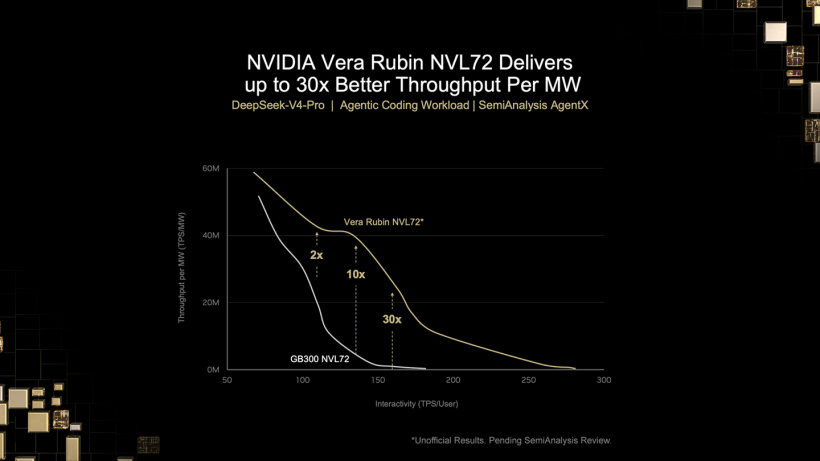
Vera Rubin NVL72 پر فی ملین Token لاگت، GB300 NVL72 کی 35 ویں حصے کے برابر ہے۔ یہ ایجنٹس کو مسلسل اور بڑے پیمانے پر چلانے کے قابل بناتا ہے اور صارفین کی مختلف workloads کی ضروریات پوری کرتا ہے۔