Thinking Machines Lab نے گزشتہ روز (30 جولائی) ایک بلاگ پوسٹ جاری کرتے ہوئے Inkling-Small ماڈل متعارف کرانے کا اعلان کیا، جس کی کارکردگی Inkling کے برابر ہے، تاہم اس کا حجم تقریباً ایک چوتھائی کم ہے۔
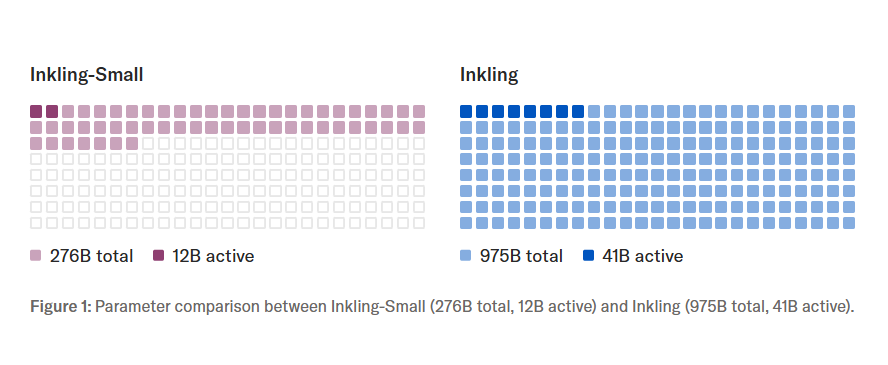
Inkling کو ’امریکا کا طاقتور ترین اوپن سورس AI ماڈل‘ کہا جاتا ہے۔ یہ مکسچر آف ایکسپرٹس (MoE) آرکیٹیکچر استعمال کرتا ہے، اس کے کل پیرامیٹرز 975B، فعال پیرامیٹرز 41B اور زیادہ سے زیادہ context 1M tokens ہے۔
اب متعارف کرایا گیا Inkling-Small ماڈل بھی مکسچر آف ایکسپرٹس (MoE) آرکیٹیکچر استعمال کرتا ہے۔ اس کے کل پیرامیٹرز 276B اور فعال پیرامیٹرز 12B ہیں۔ اس کا حجم Inkling کا تقریباً 1/4 ہے اور اسے NVIDIA GB300 NVL72 سسٹم پر تربیت دی گئی ہے۔
Inkling کی طرح Inkling-Small بھی آڈیو اور تصاویر کی مقامی inference، قابل تغیر سوچ کی شدت اور زیادہ سے زیادہ 1M token context window کو سپورٹ کرتا ہے، جبکہ متعدد بینچ مارک ٹیسٹس میں متوازن کارکردگی برقرار رکھتا ہے۔
Thinking Machines نے Inkling-Small کے مکمل weights دستیاب کر دیے ہیں، اسے Tinker fine-tuning سروس سے بھی منسلک کر دیا ہے، جبکہ Tinker Playground پر متن، تصاویر اور آڈیو کے ذریعے چیٹ کا تجربہ فراہم کیا گیا ہے۔
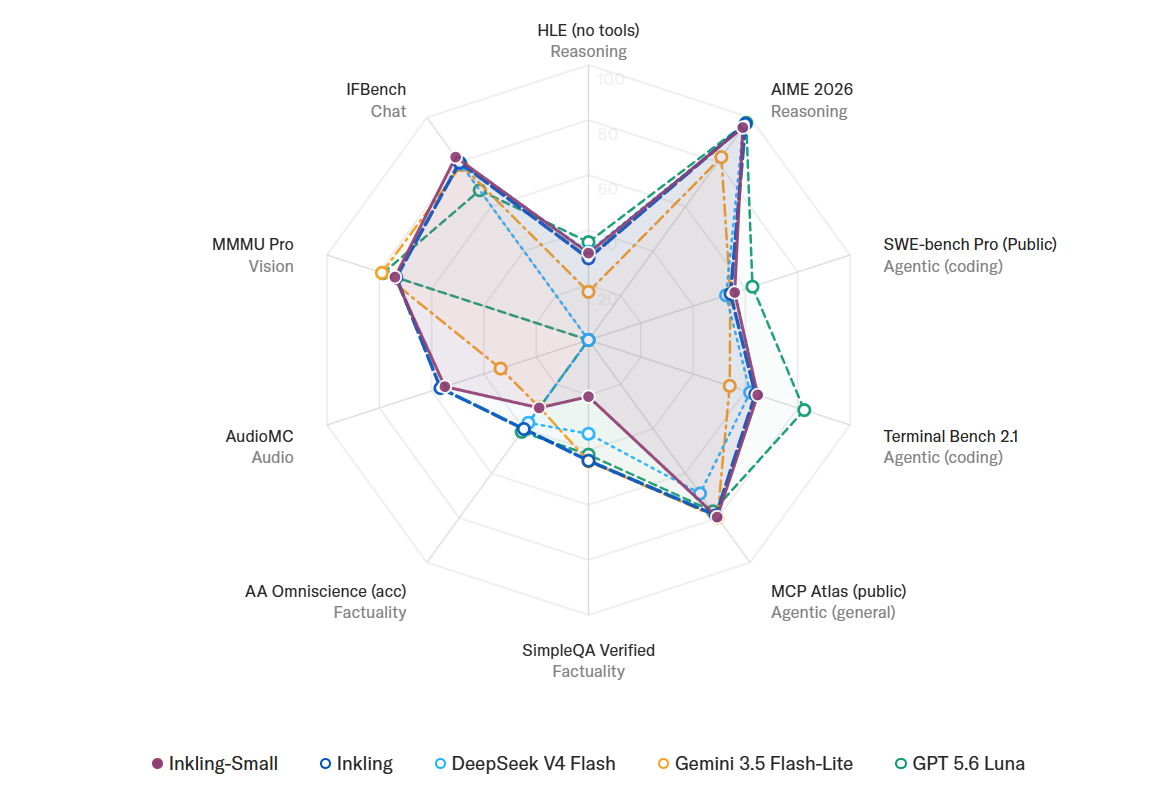
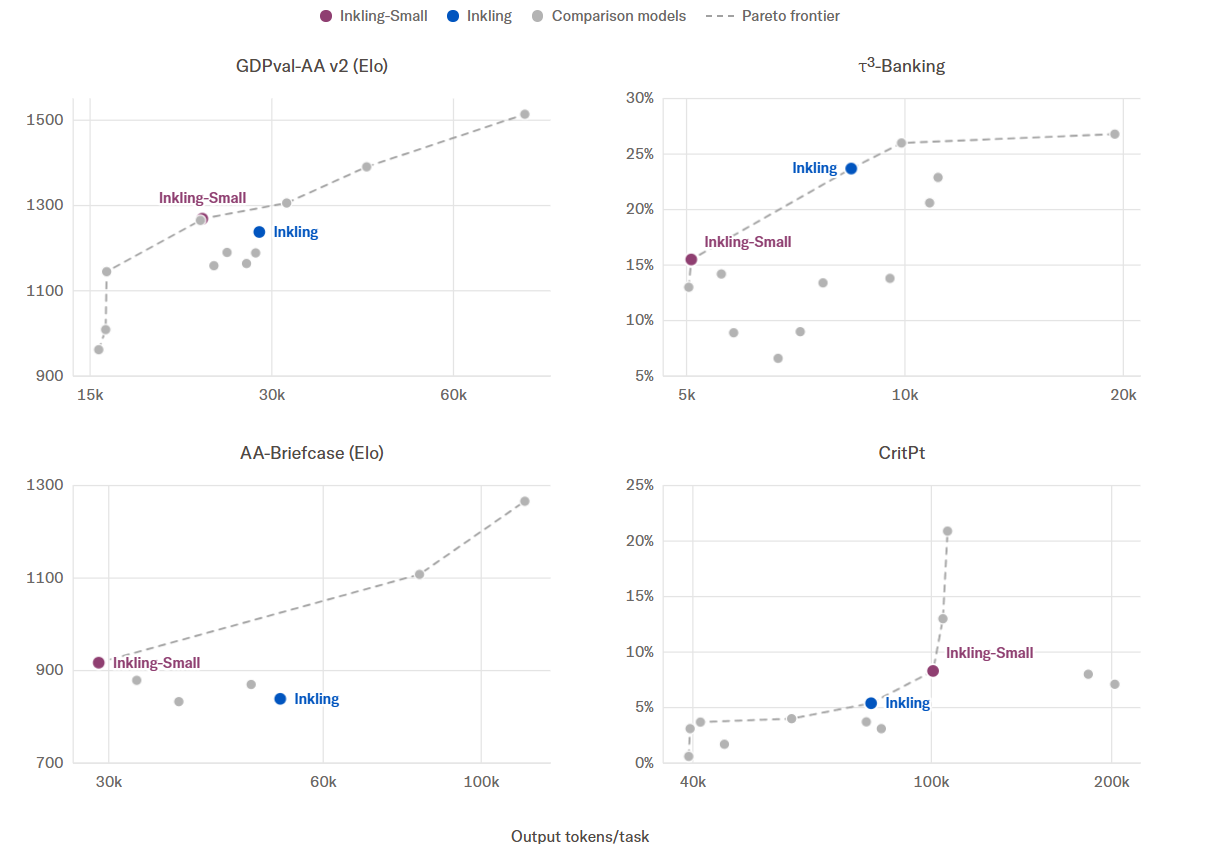
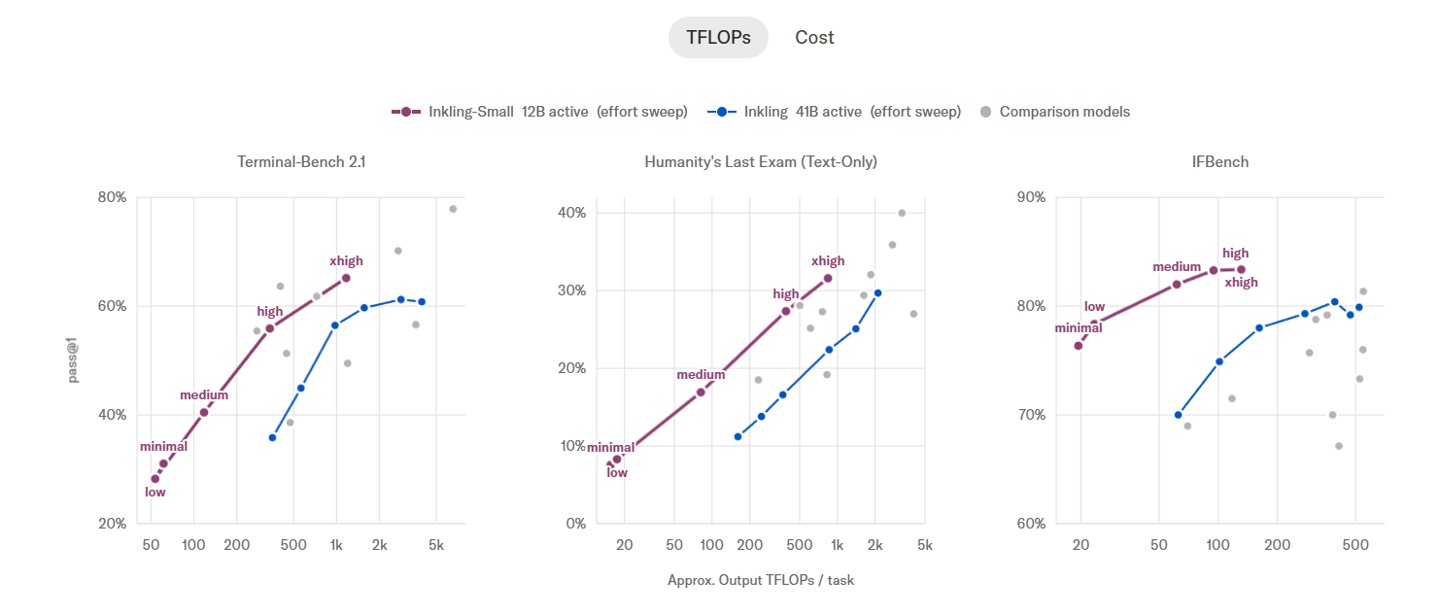
Thinking Machines کے مطابق Inkling-Small نے کم computational load کے ساتھ Inkling کے قریب کارکردگی حاصل کی ہے۔ ایجنٹ کے tool استعمال، reasoning اور instruction following کے ٹیسٹس میں Inkling-Small کی efficiency Inkling سے زیادہ ہے، اور یہ مساوی weight level والے دیگر ماڈلز کا مقابلہ کر سکتا ہے۔
reasoning اور agent tasks میں Inkling-Small نے Inkling کے برابر یا اس سے بہتر کارکردگی دکھائی۔ Humanity’s Last Exam ٹیسٹ میں Inkling-Small نے 31.6% اسکور کیا، جو Inkling کے 29.7% سے زیادہ ہے۔ Thinking Machines کے مطابق ہر thinking budget پر Inkling-Small کی test-time computation curve، Inkling سے بلند رہی۔