

چیونٹی گروپ کے تحت بائیلنگ بڑے ماڈل کی سرکاری ٹیم نے گزشتہ روز اعلان کیا کہ نئی نسل کا مقامی ہائبرڈ استدلالی ماڈل Ling-3.0-flash اب باضابطہ طور پر اوپن سورس کر دیا گیا ہے۔
Ling-3.0-flash میں کل 124B پیرامیٹرز اور 5.1B فعال پیرامیٹرز پر مشتمل MoE آرکیٹیکچر استعمال کیا گیا ہے۔ سرکاری ٹیم نے بنیادی ورژن کے ساتھ FP8، FP4 اور INT4 سمیت متعدد ورژن بھی فراہم کیے ہیں، جو تعیناتی کے تین مختلف اختیارات پیش کرتے ہیں:
API کے ذریعے رسائی: ان ڈویلپرز کے لیے جو فوری انضمام چاہتے ہیں اور اپنا استدلالی سروس سسٹم قائم نہیں کرنا چاہتے، Ling-3.0-flash کو کلاؤڈ API کے ذریعے براہِ راست استعمال کیا جا سکتا ہے؛
سنگل مشین پر نجی تعیناتی: ان اداروں اور ٹیموں کے لیے جن کا ڈیٹا ڈومین سے باہر نہیں جا سکتا، MXFP4 اور INT4 ورژن ایک ہی NVIDIA DGX Spark پر اینڈ ٹو اینڈ استدلال مکمل کر سکتے ہیں؛
اعلیٰ کارکردگی کی تعیناتی: سنگل ریکویسٹ کی تاخیر کے حوالے سے حساس اعلیٰ کارکردگی والی خدمات کے لیے، مخصوص GPU ٹیسٹ کنفیگریشن میں اوسط آؤٹ پٹ رفتار 1100 tokens/s سے تجاوز کر گئی۔
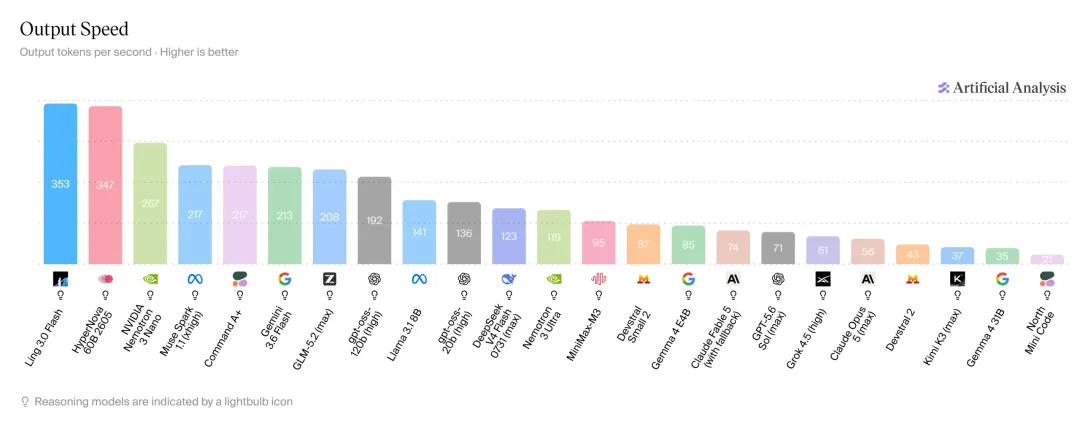
ان ڈویلپرز اور پروڈکٹ ٹیموں کے لیے جو مصنوعات کی فوری توثیق اور Agent ایپلی کیشنز کی لانچ چاہتے ہیں، API سب سے کم رکاوٹ والا رسائی کا طریقہ ہے۔ Artificial Analysis کی درجہ بندی میں Ling-3.0-flash کی آؤٹ پٹ رفتار 353 tokens/s تک پہنچ گئی۔
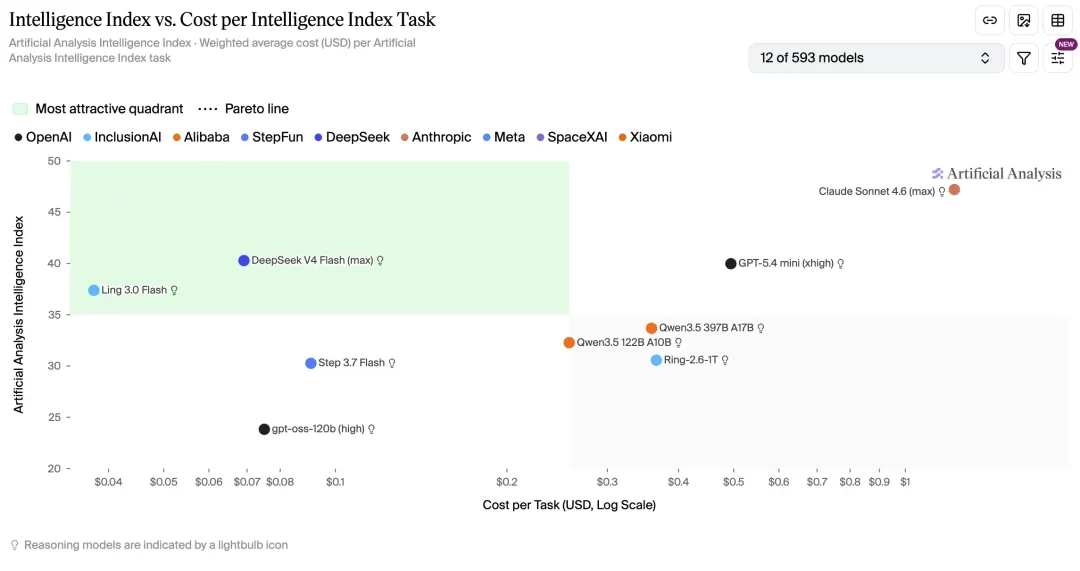
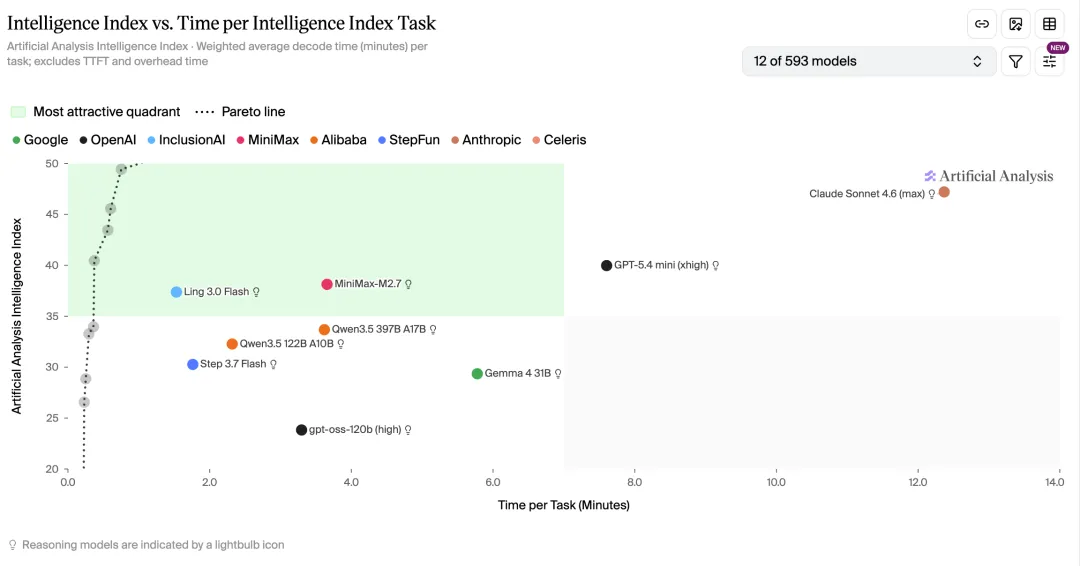
AA Intelligence Index کی درجہ بندی میں Ling-3.0-flash کے ہر کام کی وزنی اوسط کال لاگت تقریباً 0.04 امریکی ڈالر (موجودہ شرحِ تبادلہ کے مطابق تقریباً 0.27 چینی یوآن) ہے، جبکہ وزنی اوسط ڈی کوڈنگ وقت تقریباً 1.4 منٹ ہے۔ یہ بیک وقت “ذہانت کی سطح — کام کی لاگت” اور “ذہانت کی سطح — کام میں صرف ہونے والا وقت” کے لحاظ سے بہتر کارکردگی والے خطے میں بھی شامل ہے۔
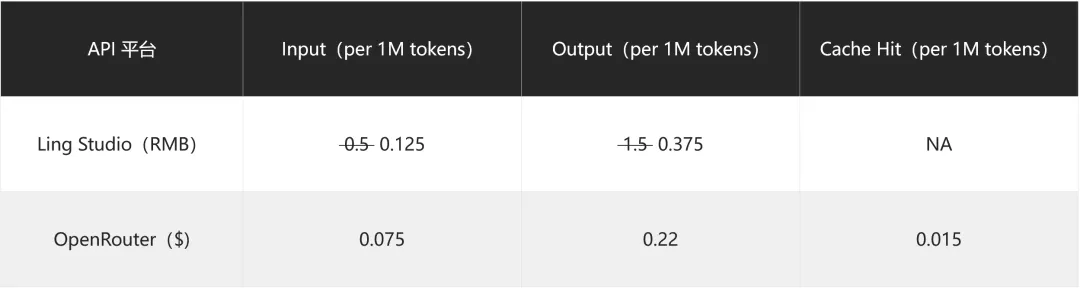
سرکاری ٹیم کے مطابق، 2026年 8 ماہ 7 تاریخ 00:00 سے 8 ماہ 31 تاریخ 24:00 تک Ling Studio میں Ling-3.0-flash پر محدود مدت کے لیے 2.5折 رعایت دی جائے گی؛ 9 ماہ 1 تاریخ 00:00 سے اصل قیمت بحال کر دی جائے گی۔
اوپن سورس روابط:
Hugging Face: https://huggingface.co/inclusionAI/Ling-3.0-flash
ModelScope: https://modelscope.cn/models/inclusionAI/Ling-3.0-flash