

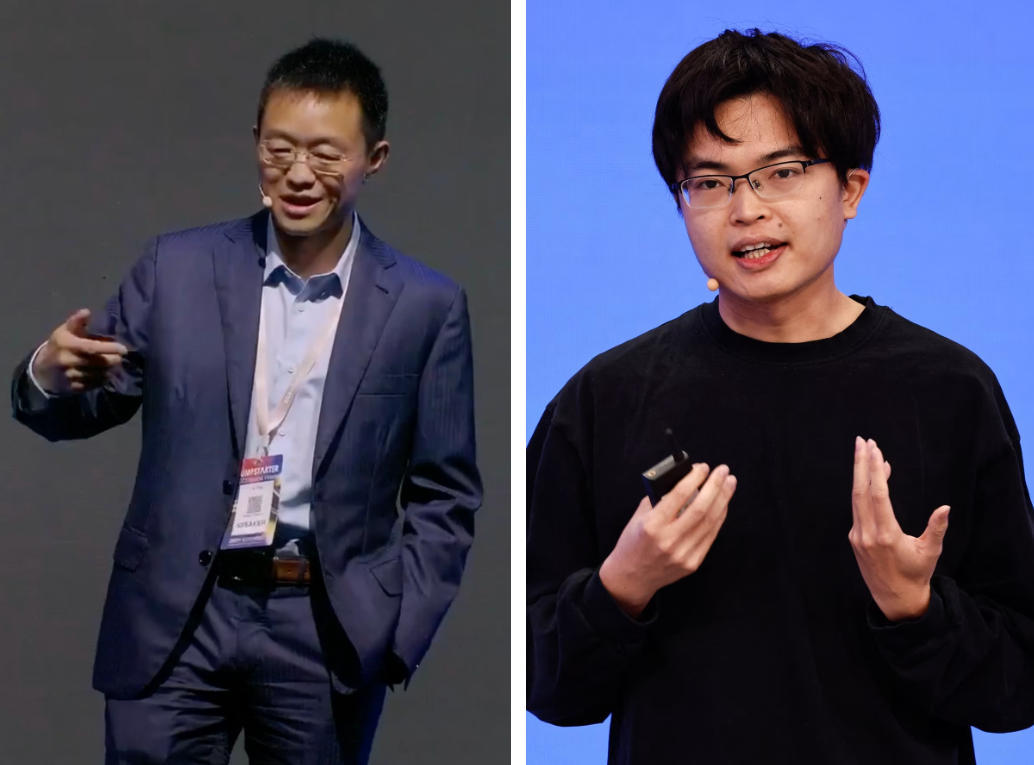
25 اگست کو وال اسٹریٹ جرنل کی رپورٹ کے مطابق، چین کے AI ماڈلز نے حالیہ برسوں میں امریکا کے معروف ماڈلز کے ساتھ موجود فرق کو تیزی سے کم کیا ہے۔ اس کے پس پشت کوئی قلیل مدتی اچانک سامنے آنے والی تکنیکی پیش رفت نہیں، بلکہ سنگھوا یونیورسٹی سمیت اعلیٰ تعلیمی اداروں میں طویل عرصے کے دوران تشکیل پانے والے ٹیلنٹ نیٹ ورک، اوپن سورس ٹیکنالوجی، ٹیلنٹ کی وطن واپسی اور زیادہ مؤثر کمپیوٹنگ سمیت متعدد عوامل کا مشترکہ کردار ہے۔ رپورٹ کے مطابق،智谱 AI کے شریک بانی تانگ جی، مون شاٹ AI کے بانی یانگ ژیلن اور DeepSeek کے بانی لیانگ وین فنگ سمیت محققین کا ایک گروہ چین کی اس مرحلے کی AI پیش قدمی کی اہم قوت ہے۔
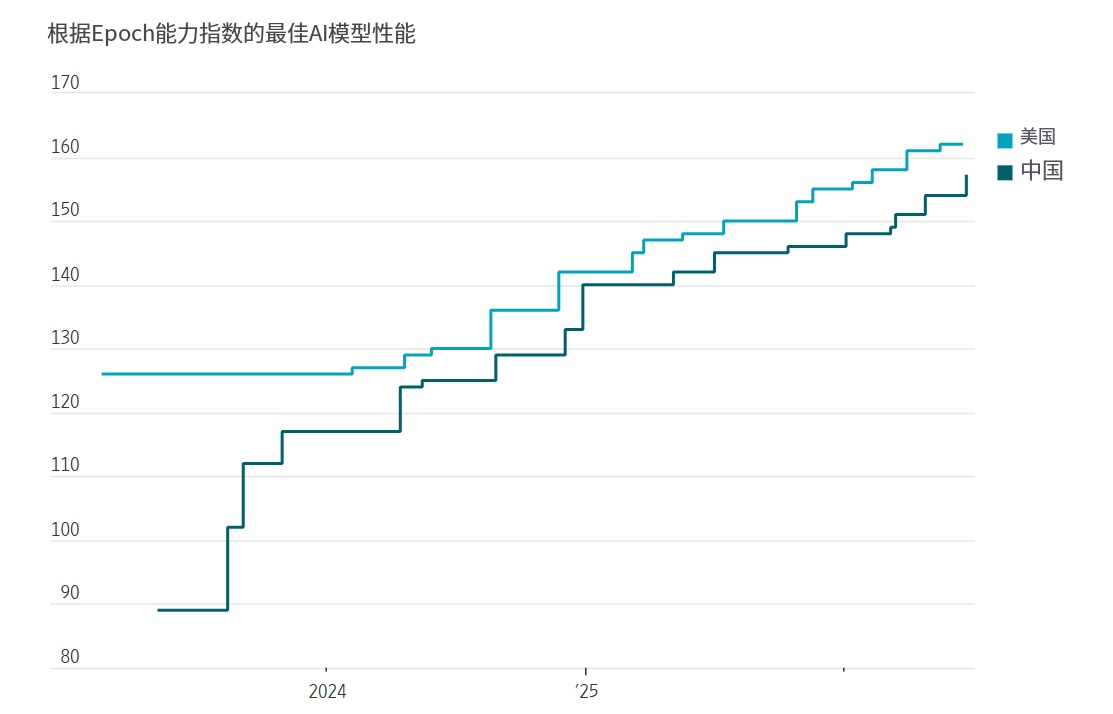
وال اسٹریٹ جرنل نے بتایا کہ چین اور امریکا کے متعدد صنعتی افراد کا خیال ہے کہ چین کے بہترین AI ماڈلز اور امریکا کے جدید ترین ماڈلز کی صلاحیتوں کے درمیان فرق اب چند ماہ تک محدود ہو گیا ہے۔ رواں سال جون میں ایلون مسک نے پیش گوئی کی تھی کہ چین Anthropic کے اعلیٰ ترین ماڈلز کی برابری 2027 کی پہلی سہ ماہی تک ہی کر سکے گا، جس پر تانگ جی نے جواب دیا تھا کہ ”اتنا وقت نہیں لگے گا“۔
رپورٹ نے چین کے AI ٹیلنٹ نظام کی تشکیل کا سراغ 20 سے زیادہ سال پہلے تک پہنچایا ہے۔ 2005 میں ٹورنگ ایوارڈ کے فاتح یاؤ چیچی نے سنگھوا یونیورسٹی میں ”یاؤ کلاس“ قائم کی، جہاں کمپیوٹر کے شعبے میں اعلیٰ صلاحیت رکھنے والے افراد کی تربیت کی گئی۔ اسی دوران تانگ جی نے طویل عرصے تک سنگھوا میں ڈیٹا مائننگ اور مشین لرننگ پر تحقیق کی، اور ان کی لیبارٹری بعد میں چین میں AI ٹیلنٹ کے اہم ذرائع میں سے ایک بن گئی۔ یانگ ژیلن نے تانگ جی کے زیرِ نگرانی تعلیم حاصل کی، سنگھوا میں مشین لرننگ الگورتھمز پر تحقیق کی، پھر کارنیگی میلن یونیورسٹی سے ڈاکٹریٹ کرنے امریکا گئے اور وطن واپسی کے بعد مون شاٹ AI قائم کیا۔
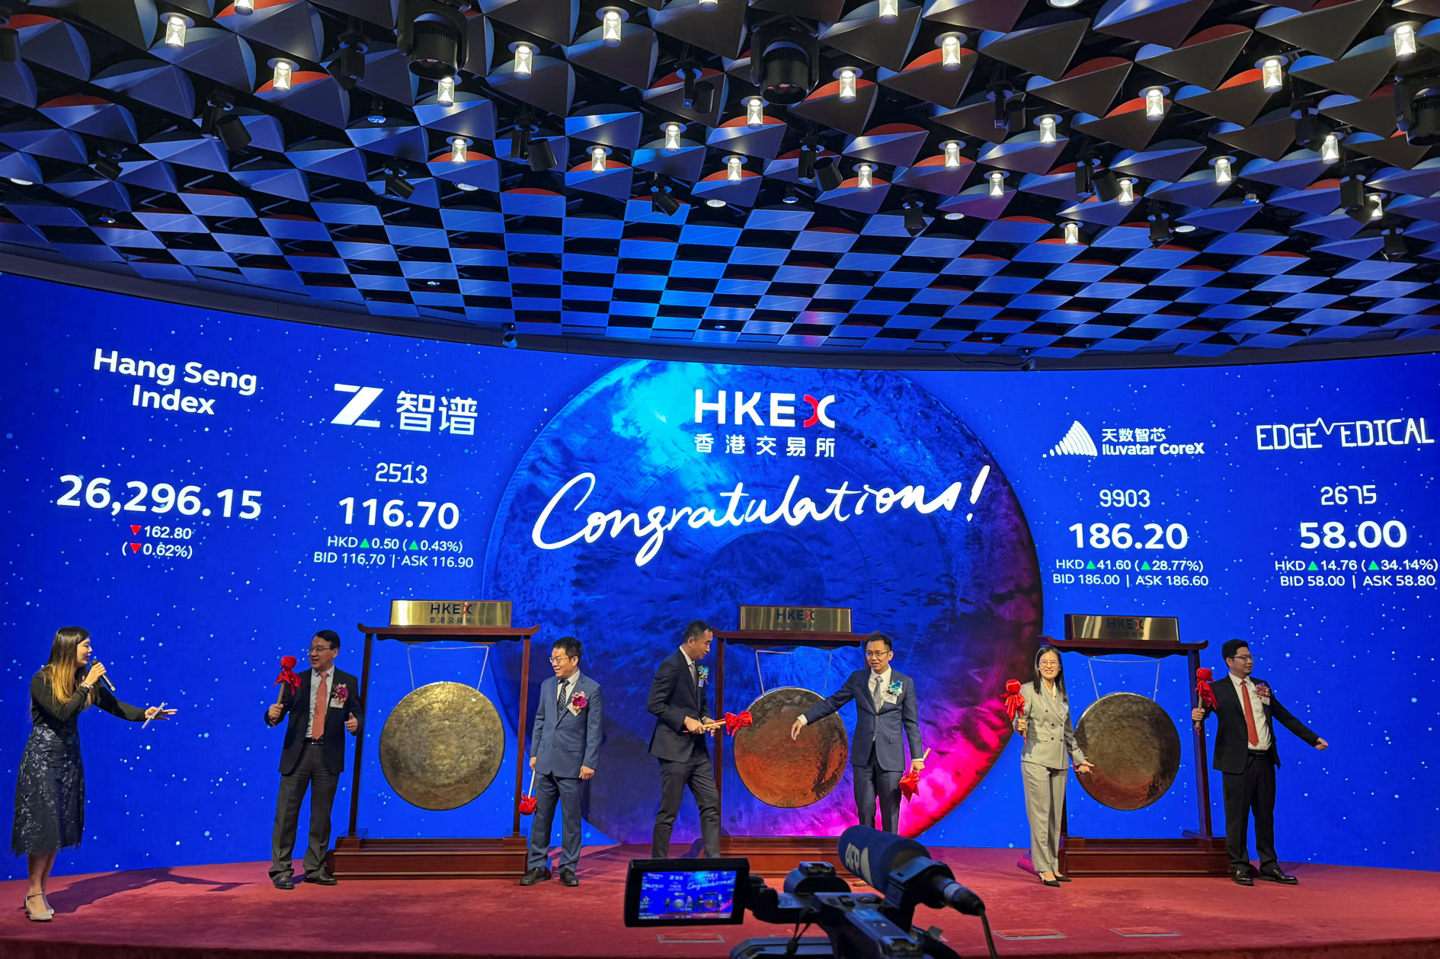
اعلیٰ تعلیمی اداروں اور اسٹارٹ اپ کمپنیوں کے درمیان افراد کی یہ آمدورفت بتدریج ایک AI ٹیلنٹ نیٹ ورک میں تبدیل ہو گئی۔ 2018 میں چین نے سائنسی محققین کے کاروبار شروع کرنے اور تحقیقی成果 کو تجارتی بنانے پر عائد پابندیوں میں مزید نرمی کی۔ اگلے سال تانگ جی نے سنگھوا کی لیبارٹری سے ایک ایسی کمپنی کو جنم دیا جو بعد میں智谱 AI کے طور پر ترقی کر گئی۔ OpenAI کی جانب سے 2020 میں GPT-3 جاری کیے جانے کے فوراً بعد智谱 نے اسی درجے کا ماڈل تیار کرنا اپنا ہدف بنا لیا تھا۔
تاہم امریکی AI کمپنیوں کے مقابلے میں چینی کمپنیاں طویل عرصے سے سرمائے اور جدید چپس کی کمی کا سامنا کر رہی ہیں۔ جیفریز کے اندازے کے مطابق، متعلقہ عرصے میں چینی ٹیکنالوجی کمپنیوں کی سرمایہ کاری امریکی ہم منصب کمپنیوں کے پانچویں حصے سے بھی کم تھی۔ اس پس منظر میں کمپیوٹنگ کی صلاحیت کے استعمال کی کارکردگی بہتر بنانا چینی AI کمپنیوں کے لیے آگے بڑھنے کا ایک اہم راستہ بن گیا۔
DeepSeek اس کی ایک نمایاں مثال ہے۔ رپورٹ کے مطابق، DeepSeek نے ملٹی ہیڈ لیٹنٹ اٹینشن میکانزم (MLA) کے ذریعے ماڈل چلانے کے دوران میموری کے استعمال کو کم کیا، اور چین میں نسبتاً ابتدائی مرحلے پر مکسڈ ایکسپرٹس ماڈل (MoE) اپنایا، تاکہ چپس کی کمپیوٹنگ صلاحیت پر انحصار کم کیا جا سکے۔ یہ ٹیکنالوجیز 2025 کے آغاز میں ”DeepSeek دھچکے“ کی اہم بنیاد بنیں۔ اس وقت اس کے کم لاگت والے اوپن سورس ماڈل نے امریکی ٹیکنالوجی حصص میں ہلچل مچا دی اور چینی ہم منصبوں کو بھی اپنی تکنیکی سمت پر ازسرنو غور کرنے پر مجبور کیا۔
چینی AI کمپنیوں کے درمیان تکنیکی تبادلے نے بھی تکراری ترقی کی رفتار مزید بڑھا دی ہے۔ مون شاٹ AI کے بعد کے ماڈلز میں DeepSeek کی جانب سے استعمال یا تصدیق کی گئی MoE اور MLA کی مختلف شکلیں اپنائی گئیں، جبکہ DeepSeek نے مون شاٹ AI کی بہتر بنائی ہوئی تربیتی ٹیکنالوجیز بھی استعمال کیں۔ مختلف ٹیموں نے تحقیقی مقالوں، اوپن سورس ماڈلز اور تکنیکی عملی تجربات کے ذریعے ایک دوسرے سے سیکھا، جس سے بند ماڈلز کے راستے سے مختلف ٹیکنالوجی کے پھیلاؤ کا ایک طریقہ کار تشکیل پایا۔
اسی دوران ٹیلنٹ کی وطن واپسی بھی ایک اور تکنیکی راستہ بن گئی۔ ٹینسینٹ نے سنگھوا سے فارغ التحصیل ایسے دو افراد کو بھرتی کیا جو پہلے OpenAI میں کام کر چکے تھے، جبکہ بائٹ ڈانس نے گوگل میں کام کرنے والے چینی محققین کو شامل کیا۔ رپورٹ کے مطابق، امریکی AI کمپنیوں کی تکنیکی پیش رفت، بیرون ملک موجود ٹیلنٹ کی وطن واپسی اور چین کا مقامی تحقیقی نیٹ ورک، تینوں نے مل کر چینی AI کمپنیوں کی پیش قدمی کی رفتار بڑھائی۔
لیکن کمپیوٹنگ صلاحیت اب بھی چینی AI کمپنیوں کے لیے ایک بڑی رکاوٹ ہے۔ لیانگ وین فنگ نے رواں سال مئی میں کہا تھا کہ چین اور امریکا کی AI کمپنیوں کے درمیان سب سے اہم فرق ٹیلنٹ نہیں بلکہ چپس ہیں۔ علی بابا،智谱 سمیت معروف لیبارٹریوں کے محققین کا کہنا ہے کہ انہیں ملنے والی اعلیٰ کارکردگی کی چپس کی تعداد اکثر OpenAI اور گوگل کے ہم منصبوں کے مقابلے میں صرف پانچواں حصہ ہوتی ہے۔