

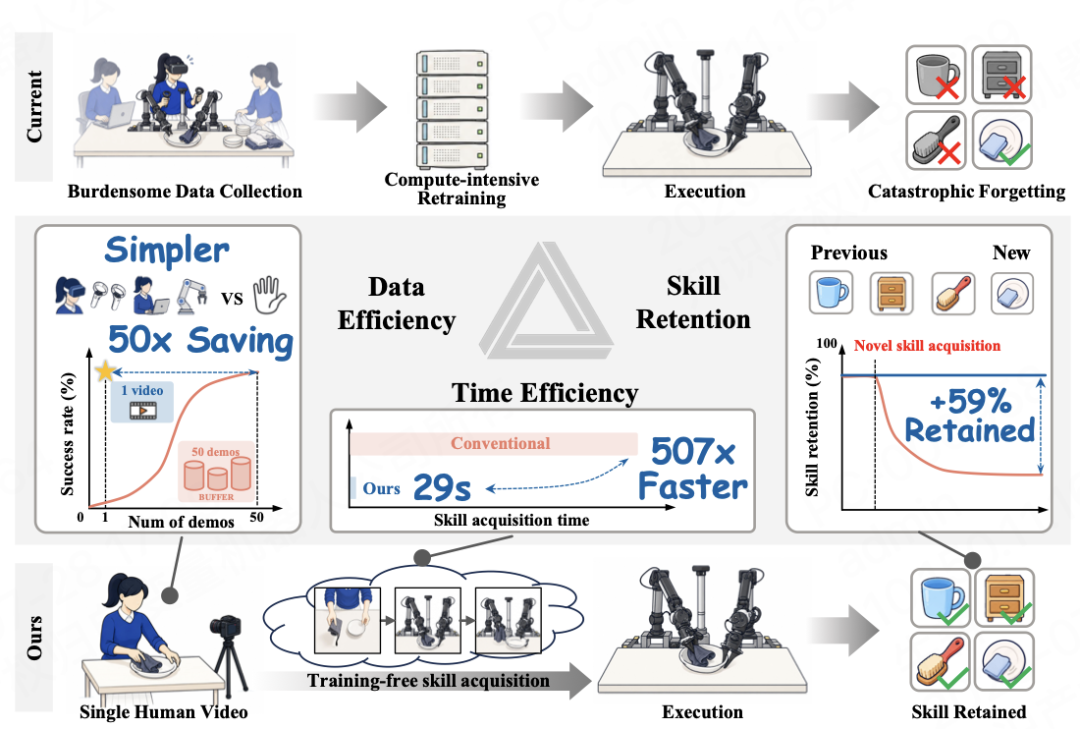
自变量机器人 نے آج HOST فریم ورک (Human-to-robot One-Shot Skill AcquisiTion، انسان سے روبوٹ تک یک نمونہ مہارت کا حصول) جاری کرکے اوپن سورس کر دیا۔ اس کا دعویٰ ہے کہ یہ روبوٹ کو صرف چند درجن سیکنڈ کی انسانی ویڈیو دیکھ کر نئی مہارت سیکھنے کے قابل بناتا ہے، جبکہ پہلے سے سیکھی ہوئی مہارتیں بھی برقرار رہتی ہیں۔
HOST نے ایک نئی نوعیت کا طریقہ اپنایا ہے: انسانی حرکات کو روبوٹ کی حرکات میں ترجمہ کرکے ان کی نقل کروانے کے بجائے، روبوٹ پہلے عمل مکمل ہونے کے بعد کے نتیجے کا تصور کرتا ہے، پھر اس نتیجے سے درکار حرکات اخذ کرتا ہے۔ اس نئے طریقے کے نتائج حوصلہ افزا ہیں: روبوٹ نے 29 سیکنڈ کی انسانی ویڈیو سے مہارت سیکھنے میں 62% کامیابی کی شرح حاصل کی، جو صفر نمونے کی بنیادی شرح 45% سے زیادہ ہے۔ Pi-0.5 + فائن ٹیوننگ حل کے مقابلے میں HOST کو درکار ڈیٹا 50 گنا کم ہے اور مہارت سیکھنے کی رفتار 500 گنا زیادہ ہے۔
HOST کا تصور ادراکی سائنس کے “مشاہداتی سیکھنے” کے نظریے سے ماخوذ ہے: انسان جب کسی نامانوس کام کا سامنا کرتا ہے تو اسے سیکھنے کے لیے طویل مشق یا تمام ممکنہ صورتوں کو آزمانے کی ضرورت نہیں ہوتی، بلکہ وہ اپنی پیشگی صلاحیتوں کی مدد سے دماغ میں عمل کے متوقع نتیجے کی نقالی کرتا ہے، پھر متعلقہ حرکات انجام دیتا ہے۔ 自变量 کی تحقیقی ٹیم نے اسی سے تحریک لے کر HOST کے سیکھنے کے طریقے کو “تربیت کے دوران فائن ٹیوننگ کے چکر” سے بدل کر “استدلال کے دوران مہارت کا حصول” کر دیا، جس سے روبوٹ انسانی کام کا مشاہدہ کرکے نئی مہارتیں سیکھ سکتا ہے۔
روبوٹ کو سب سے پہلے یہ مسئلہ حل کرنا ہوتا ہے: اپنی جانب سے کام کی پیش رفت اور ویڈیو میں دکھائی گئی پیش رفت کو کیسے ہم آہنگ کیا جائے؟
مثال کے طور پر، 10 سیکنڈ تک ایک ہی کام کرنے کے باوجود ویڈیو میں موجود شخص شاید سبزیاں کاٹ کر انہیں بھوننا شروع کر چکا ہو، جبکہ روبوٹ ابھی سبزیاں کاٹ رہا ہو۔ اگر صرف وقت کے مطابق ہم آہنگی کی جائے تو روبوٹ کام کی پیش رفت کھو دے گا۔
اس مسئلے کے لیے HOST “کام کی پیش رفت کے مطابق ہم آہنگی” کا طریقہ استعمال کرتا ہے۔ HOST ویڈیو کے ہر فریم اور روبوٹ کے ہر عملی قدم کو ایک ہی ویکٹر اسپیس میں ویکٹر میں تبدیل کرتا ہے، پھر “متحرک زمانی ترتیب” کے الگورتھم کے ذریعے “انسانی ویڈیو کے X ویں فریم اور روبوٹ کے Y ویں قدم” کو خودکار طور پر ہم آہنگ کرتا ہے۔ اس طرح روبوٹ جب بھی کوئی قدم انجام دیتا ہے، اسے ہمیشہ کام کی پیش رفت سے ہم آہنگ فریم دکھائی دیتا ہے۔
اس طریقے کی مدد سے HOST نے کام کی پیش رفت کو ہم آہنگ کرنے کی زمانی غلطی کو ایک درجہ کم کیا ہے، اور روبوٹ کے عمل اور ویڈیو مظاہرے کے درمیان انتہائی درست ہم وقتی حاصل کی جا سکتی ہے۔
HOST کا بنیادی حصہ بصری پیش گوئی کی صلاحیت رکھنے والا ایک سلسلہ وار پالیسی ماڈل ہے۔ یہ دو ماہرین پر مشتمل MoT ساخت استعمال کرتا ہے، جو واضح طور پر تقسیم شدہ دو دماغوں کی مانند ہے: “بصری دماغ” (ویڈیو ماہر) ویڈیو مناظر کو سمجھنے، کام کی پیش رفت کی نشاندہی کرنے اور مستقبل کے مناظر کی پیش گوئی کرنے کا ذمہ دار ہے؛ “عملی دماغ” (حرکت ماہر) پیش گوئی کردہ منظر کو درکار حرکات میں تبدیل کرتا اور ان کے نفاذ کو کنٹرول کرتا ہے۔
ماڈل کی تربیت کے دوران، 自变量 کی ٹیم نے تربیتی عمل کو “ہم نوع پیش تربیت” اور “انسان-روبوٹ ویڈیو تربیت” کے دو مراحل میں تقسیم کیا۔ ہم نوع پیش تربیت کے مرحلے میں روبوٹ اپنے کام انجام دینے کی ویڈیوز سے سیکھتا ہے، کام مکمل ہونے کے بعد کی حالت کی پیش گوئی کرنا اور متعلقہ حرکات پیدا کرنا سیکھتا ہے۔ انسان-روبوٹ ویڈیو تربیت کے مرحلے میں روبوٹ انسانی مظاہرے کی ویڈیوز سے مزید سیکھتا ہے، انسانی کام کے عمل کو روبوٹ کے نقطۂ نظر سے کام کے نتیجے میں تبدیل کرتا ہے، پھر ہدف کے نتیجے کی بنیاد پر کام مکمل کرنے کے لیے درکار حرکات کا استدلال کرتا ہے، یوں انسانی مظاہرے سے روبوٹ کی مہارت تک منتقلی ممکن ہوتی ہے۔
فی الحال HOST کا تحقیقی مقالہ اور کوڈ مکمل طور پر اوپن سورس کر دیے گئے ہیں۔ مستقبل میں گھریلو کام کرتے وقت روبوٹس خصوصی ڈیٹا جمع کرنے اور تربیت کے عمل سے آزاد ہو کر انسانی مظاہرے کو براہِ راست دیکھ کر نئی مہارتیں سیکھ سکیں گے۔
حوالہ
پروجیکٹ کا مرکزی صفحہ
مقالے کا لنک
Github لنک
Huggingface لنک