

علی بابا ٹونگیی چیان وین ٹیم نے آج رات باضابطہ طور پر Qwen3.8-Flash جاری کر دیا۔ ٹونگیی ٹیم نے Qwen3.8-Flash-Next کے اوپن سورس وزن بھی جاری کیے ہیں، جبکہ Next کا نیا آرکیٹیکچر بالکل نئی نسل کے Qwen4 سیریز ماڈلز کا ابتدائی نمونہ ہوگا۔
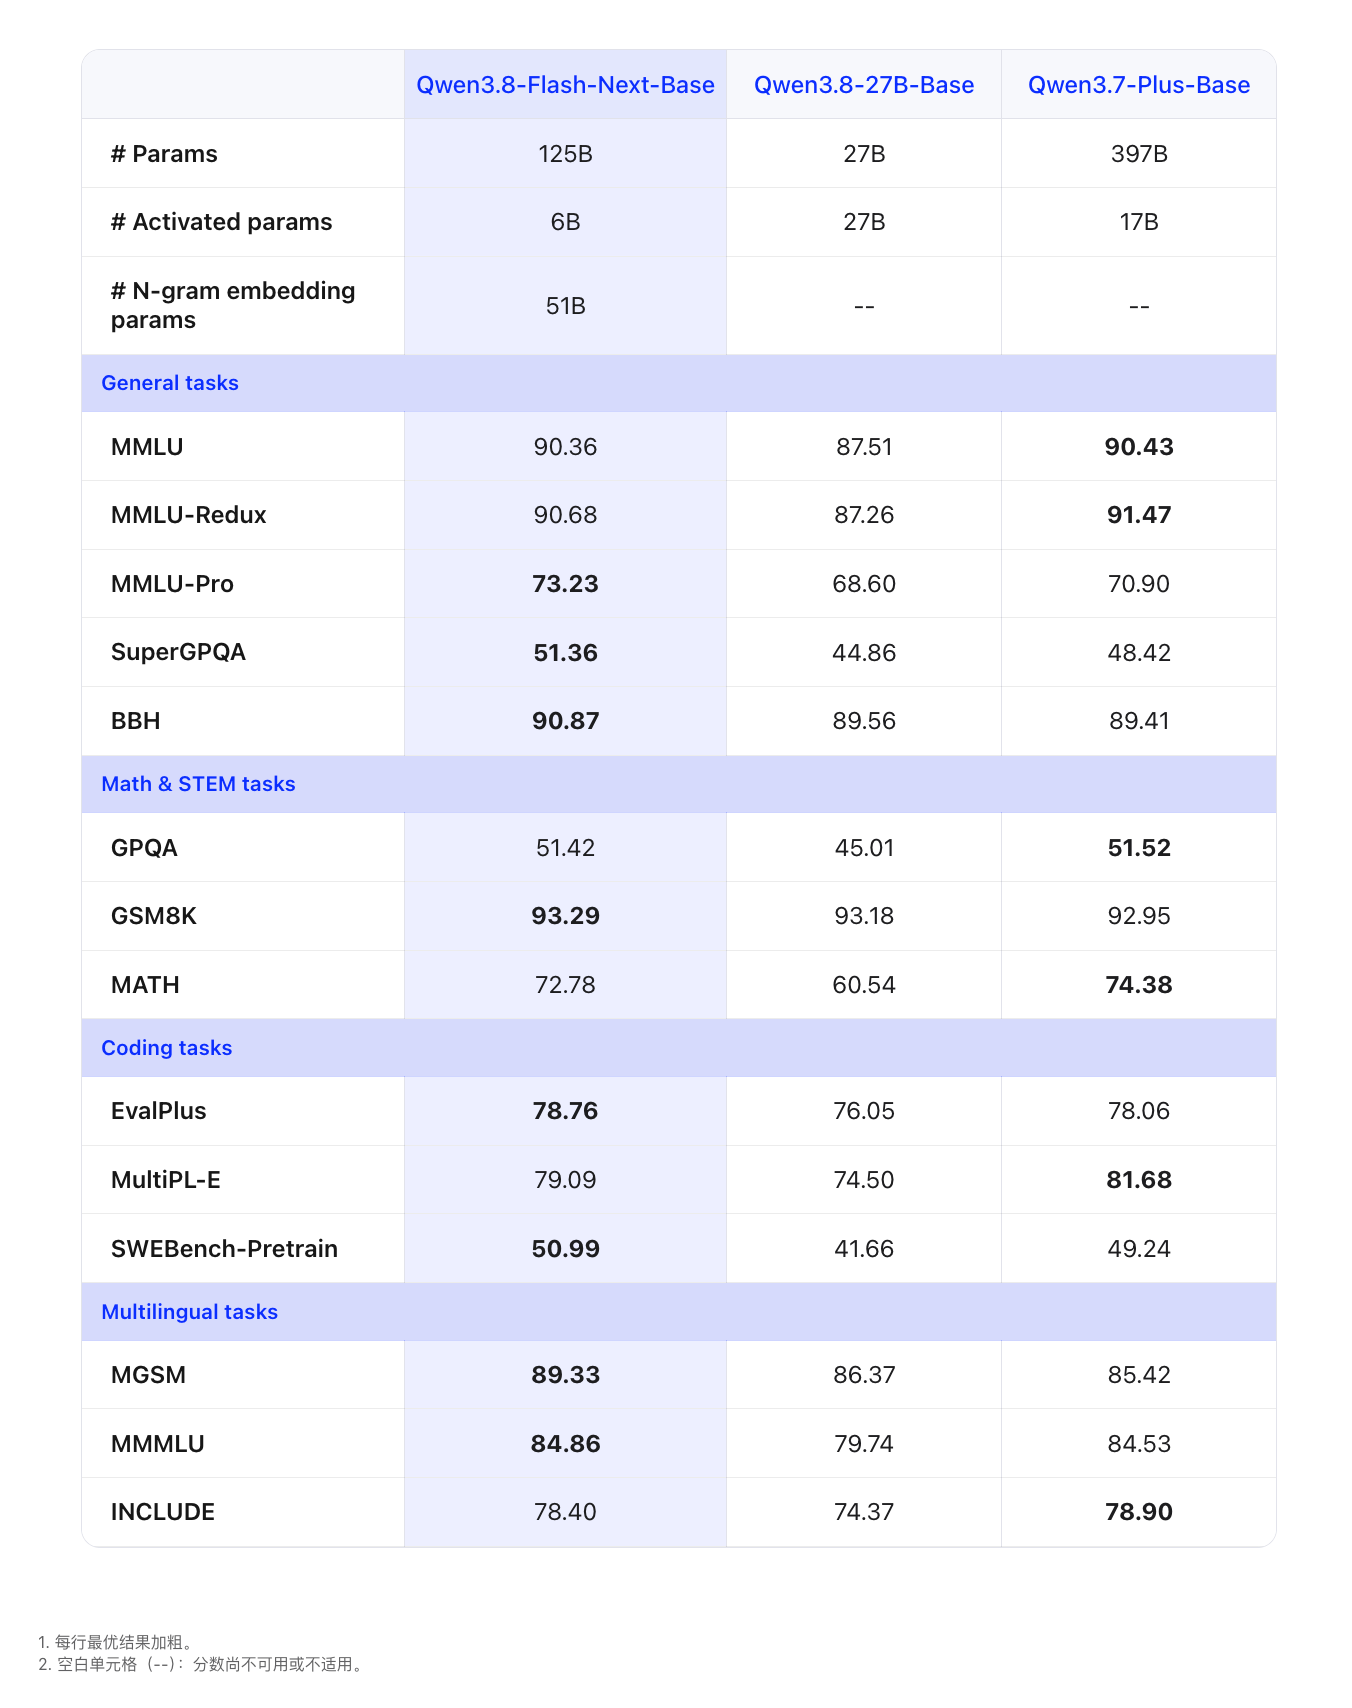
یہ ایک ملٹی موڈل MoE ماڈل ہے۔ مرکزی ماڈل میں 125B پیرامیٹرز ہیں، جبکہ اضافی طور پر 51B کا N-gram Embedding شامل ہے؛ ہر token پر 6B پیرامیٹرز فعال ہوتے ہیں۔ یہ مقامی طور پر 262,144 tokens کے سیاق و سباق کو سپورٹ کرتا ہے اور YaRN کے ذریعے اسے 1M tokens تک بڑھایا جا سکتا ہے۔
تعارف کے مطابق، Qwen3.8-Flash کو چار سمتوں میں منظم طور پر اپ گریڈ کیا گیا ہے:
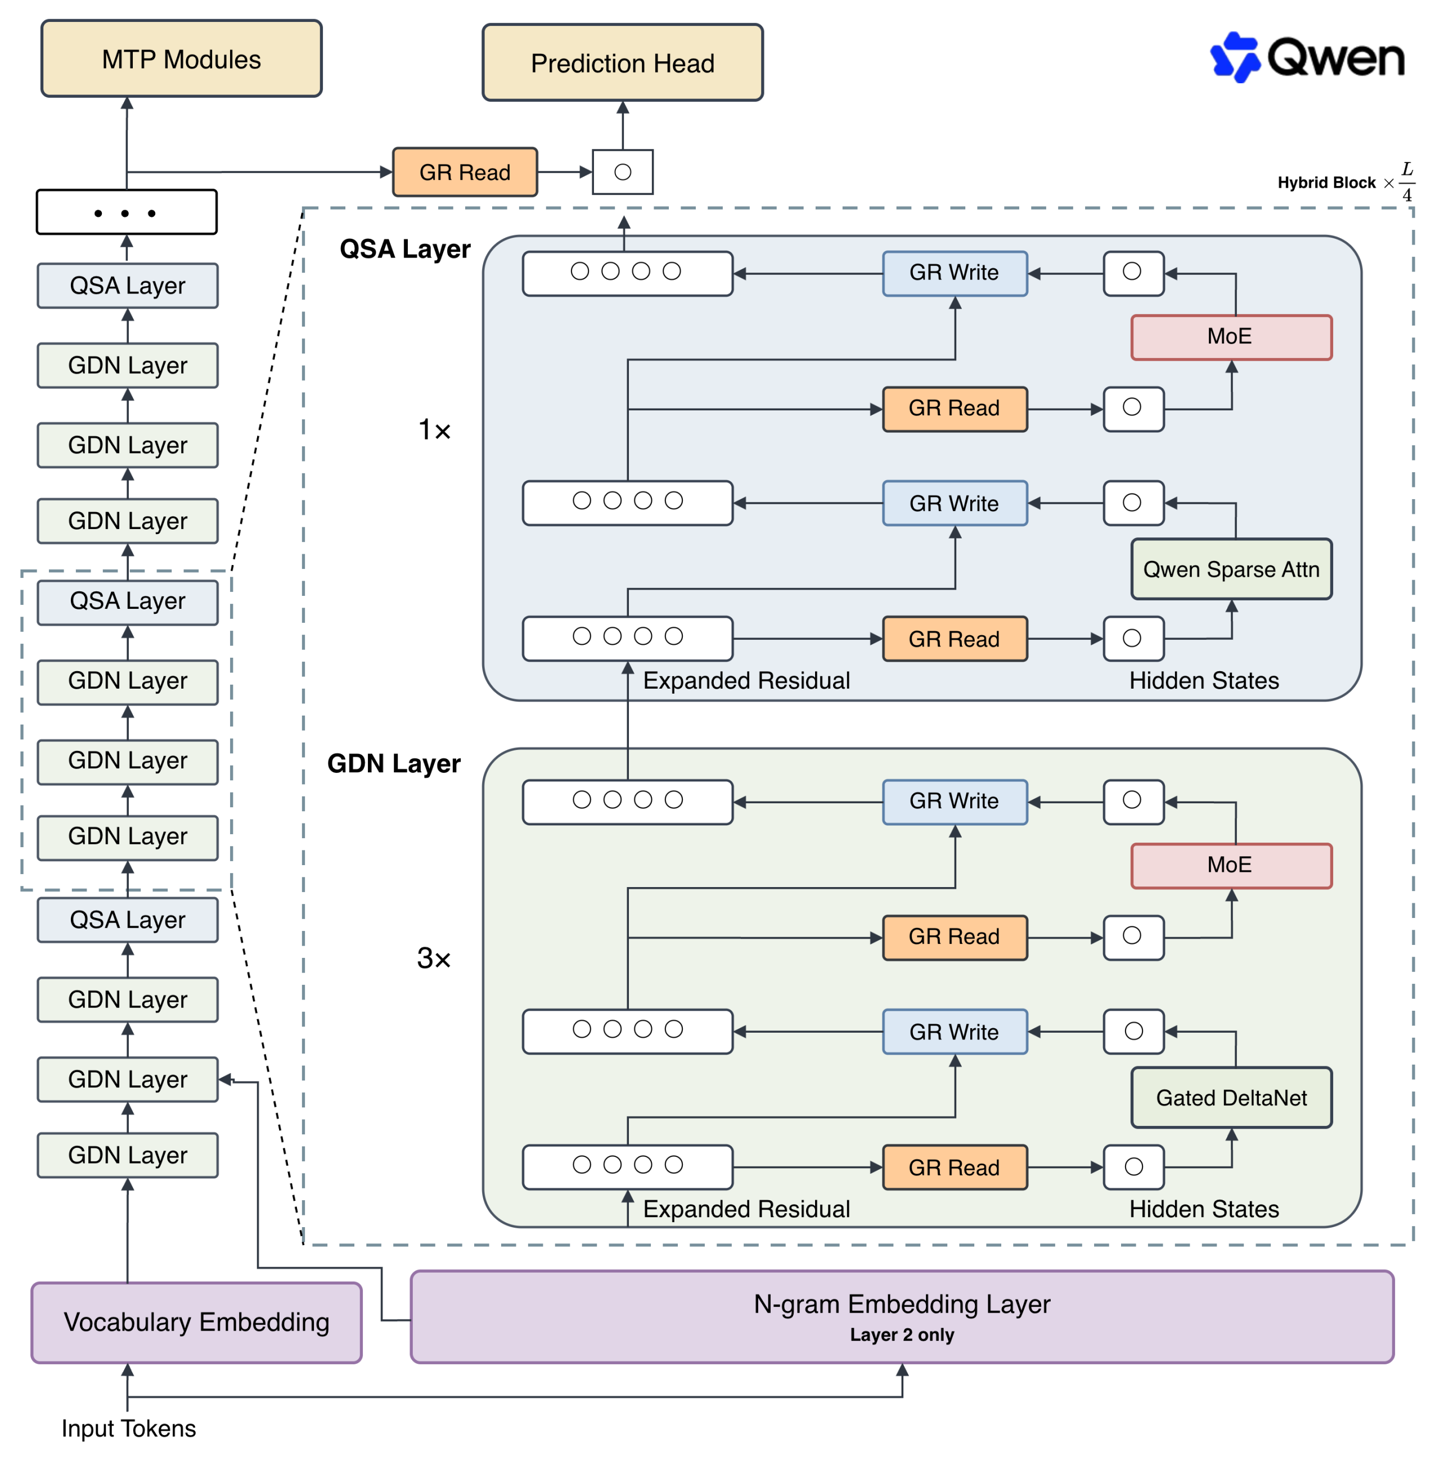
Attention کے لحاظ سے GDN(Gated DeltaNet)+ QSA(Qwen Sparse Attention)کا ہائبرڈ آرکیٹیکچر اپنایا گیا ہے۔ GDN تاریخی معلومات کو مؤثر انداز میں سکیڑنے کا ذمہ دار ہے، جبکہ QSA ہلکے پھلکے Indexer کے ذریعے micro-block کی سطح پر اہم سیاق و سباق کو منتخب کرتا ہے، جس سے طویل سلسلوں کی Attention لاگت نمایاں طور پر کم ہو جاتی ہے۔ 1M token کے انتہائی طویل سیاق و سباق میں QSA کے Attention Kernel نے Prefill اور Decode مراحل میں بالترتیب زیادہ سے زیادہ 7.6 گنا اور 4.9 گنا رفتار حاصل کی۔
Residual کے لحاظ سے Gated Residual(GR)میکانزم متعارف کرایا گیا ہے، جو residual flow کو 4 متوازی شاخوں تک پھیلاتا ہے اور معلومات کے پڑھنے اور لکھنے کو متحرک Gate کے ذریعے کنٹرول کرتا ہے۔ Residual state، FP8 اسٹوریج کو سپورٹ کرتی ہے، جس سے میموری تک رسائی کی لاگت نمایاں طور پر کم ہو جاتی ہے۔
Embedding کے لحاظ سے 51B پیرامیٹرز کا N-gram Embedding متعارف کرایا گیا ہے، جو مقامی سیاق و سباق سے ٹیبل تلاش کے ذریعے ماڈل کی گنجائش بڑھاتا ہے۔ ان پیرامیٹرز کو Host Memory میں منتقل کیا جا سکتا ہے اور asynchronous Prefetch کے ذریعے ماڈل کی computation کے ساتھ متوازی چلایا جا سکتا ہے، اس لیے یہ طویل عرصے تک GPU میموری پر قبضہ نہیں کرتے۔
Optimization کے لحاظ سے Muon Optimizer اپنایا گیا ہے، جبکہ orthogonalization کی درستگی، پیرامیٹرز کی تقسیم اور fused matrix splitting سمیت حکمت عملیوں کو بہتر بنایا گیا ہے۔ نئے آرکیٹیکچر کے لیے Scaling Law کو دوبارہ فٹ کیا گیا ہے۔
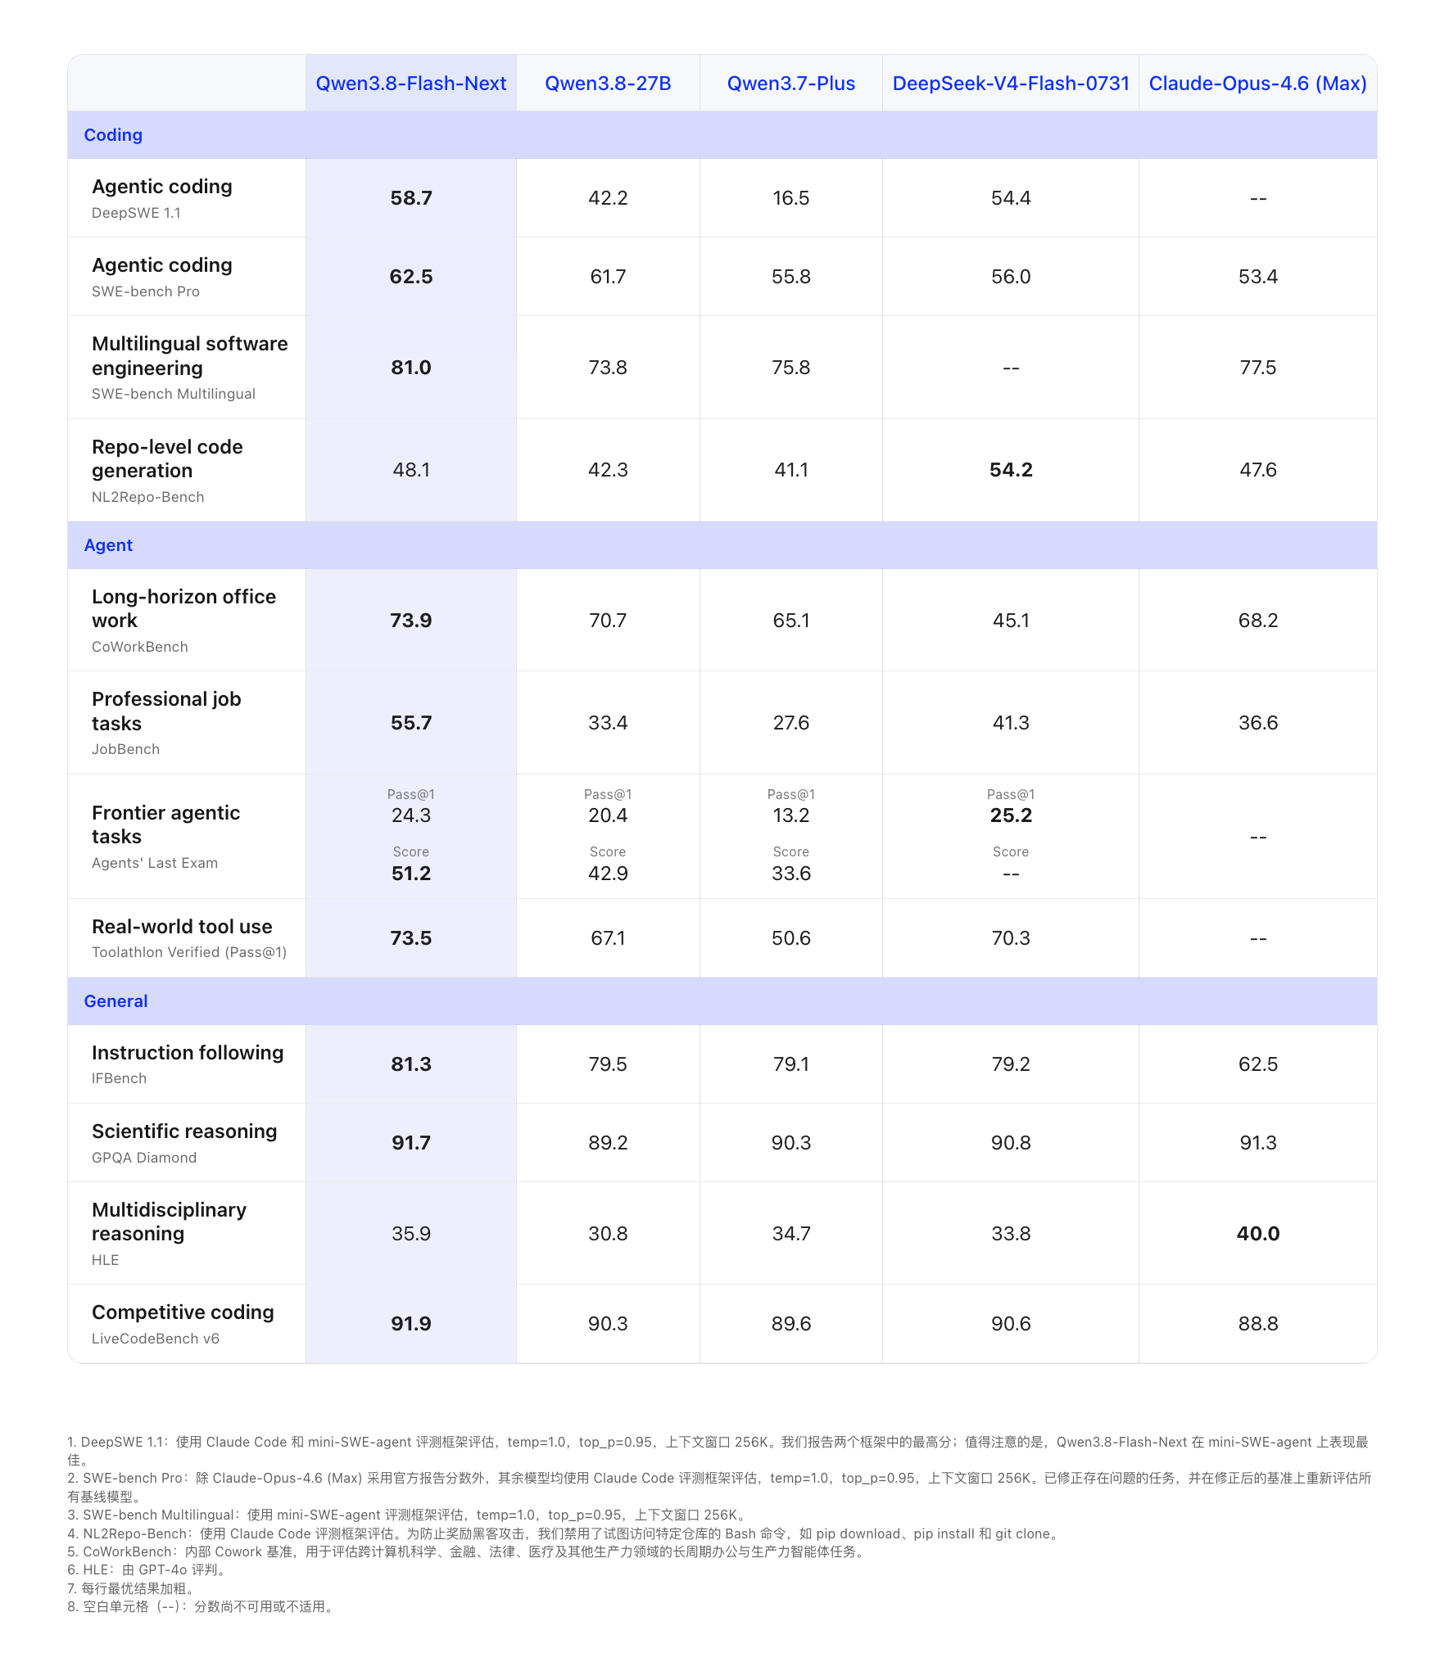
Qwen3.7-Plus کے مقابلے میں Qwen3.8-Flash کی تربیتی لاگت سابقہ ماڈل کی تقریباً نویں حصے کے برابر ہے، تاہم coding اور دفتری کاموں میں یہ زیادہ مضبوط صلاحیت رکھتا ہے۔
6B فعال پیرامیٹرز کے ساتھ Qwen3.8-Flash-Next-Base نے 14 benchmarks میں سے 8 پر بہترین نتائج حاصل کیے، جن میں MMLU-Pro، SuperGPQA، BBH، SWEBench-Pretrain، MGSM اور MMMU شامل ہیں۔
صرف متن:
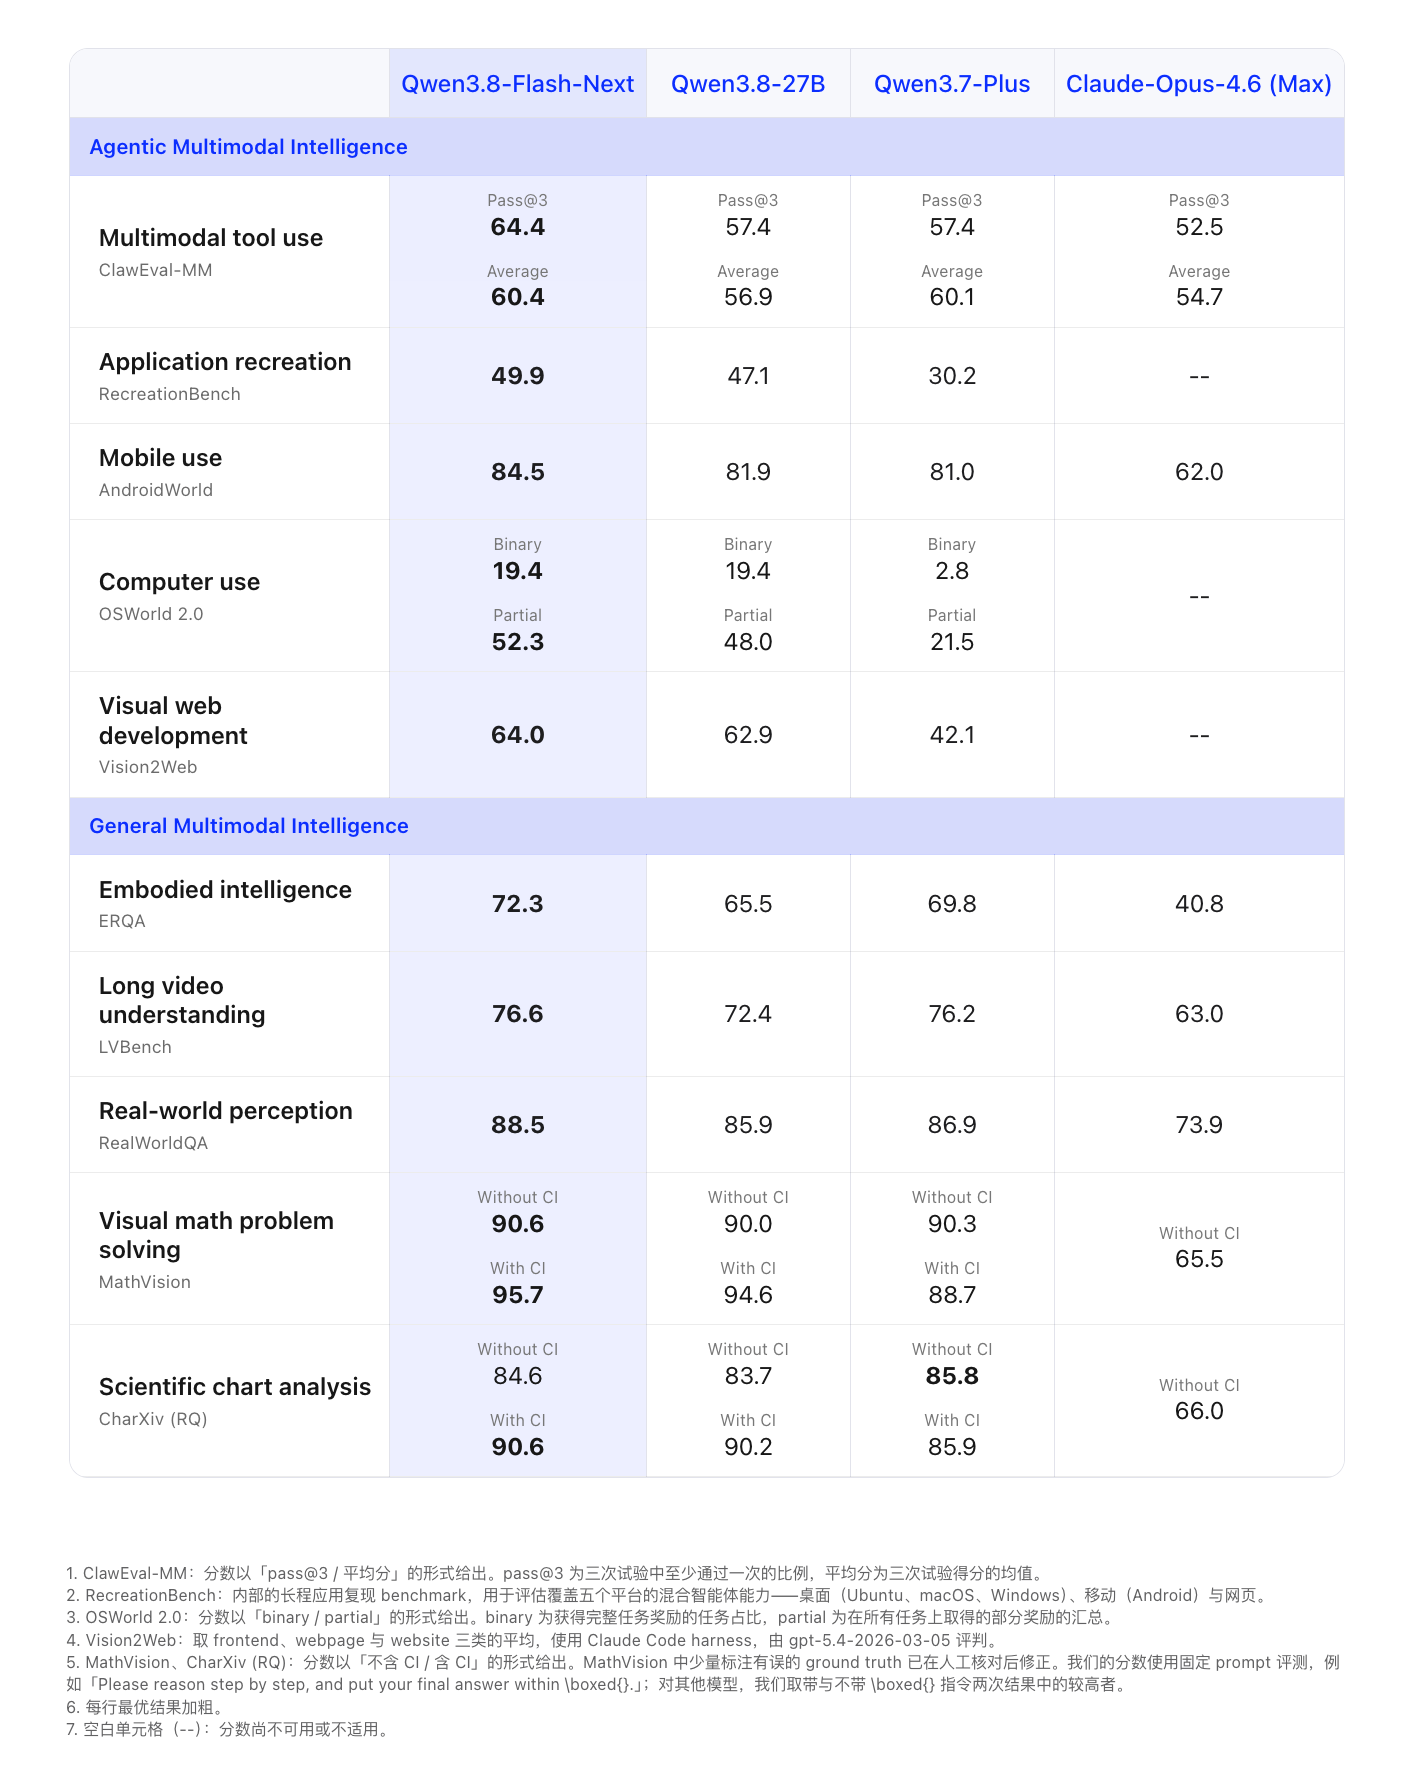
ملٹی موڈل:
ماڈل کا ڈھانچا:
Base ماڈل کی کارکردگی:
Qwen3.8-Flash جلد ہی چیان وین AI پلیٹ فارم پر دستیاب ہوگا اور عوام کے لیے API سروس فراہم کرے گا، جس کی قیمت ہر دس لاکھ Tokens کے لیے input پر 1 یوان اور output پر 3 یوان ہوگی۔
ماڈل کے وزن بیجنگ کے وقت 26 اگست کو 23:00 بجے Hugging Face اور ModelScope پلیٹ فارمز پر اوپن سورس کر دیے گئے، جبکہ FP8 quantized ورژن بھی بیک وقت جاری کیا گیا۔ Qwen3.8-Flash-Next بطور ڈیفالٹ 1M سیاق و سباق کو سپورٹ کرتا ہے اور اس میں سرکاری tools شامل ہیں۔
حوالہ جاتی مواد:
تکنیکی رپورٹ: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
تکنیکی بلاگ: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next