

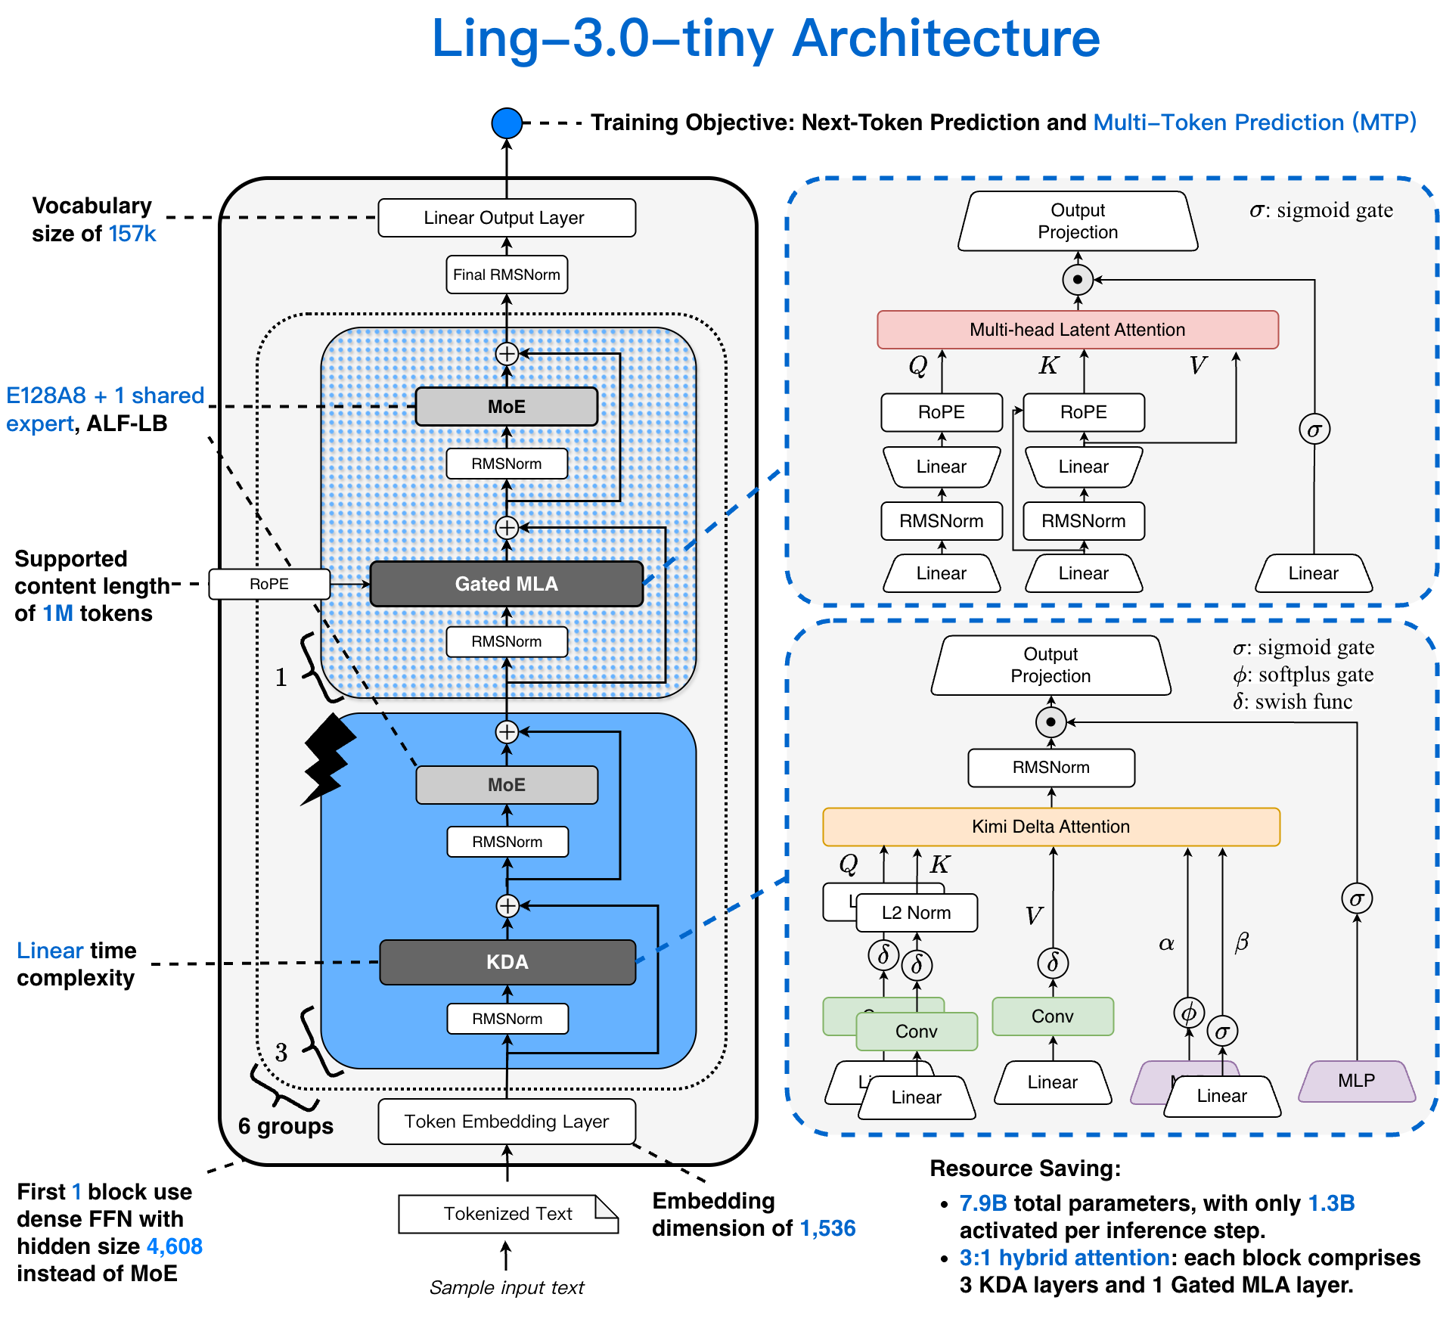
Ant Group کے Ling-3.0-tiny ماڈل کو آج Hugging Face پلیٹ فارم پر اوپن سورس کیا گیا۔ یہ ماڈل ہلکے وزن کے ہائبرڈ ریزننگ MoE آرکیٹیکچر پر مبنی ہے، جس کے کل 7.9B پیرامیٹرز ہیں، جبکہ ہر Token پر 1.3B پیرامیٹرز فعال ہوتے ہیں۔ کمپنی نے BF16، FP8 اور INT4 وزن کے ورژن فراہم کیے ہیں، جو مختلف پلیٹ فارمز کی تعیناتی کی ضروریات کے مطابق ہیں۔
تعارف کے مطابق، Ling-3.0-tiny کم لاگت والی inference پر توجہ دیتا ہے اور ایک مؤثر ہائبرڈ لکیری آرکیٹیکچر استعمال کرتا ہے، جس میں KDA (Kimi Delta Attention) اور MLA (Multi-Head Latent Attention، ملٹی ہیڈ لیٹنٹ اٹینشن) کو 3:1 کے تناسب سے باری باری اسٹیک کیا گیا ہے۔ اس میں 128 روٹڈ ایکسپرٹس (routed experts) پر مشتمل sparse MoE فیڈ فارورڈ نیٹ ورک (FFN) استعمال ہوتا ہے، جو context پروسیسنگ کی صلاحیت اور حسابی لاگت کے درمیان توازن قائم کرتا ہے۔
یہ ماڈل فوری ردِعمل کے موڈ اور کثیر مرحلہ ریزننگ موڈ کو سپورٹ کرتا ہے اور اسے مقامی تعیناتی کے لیے ڈیزائن کیا گیا ہے۔ کمپنی نے NVIDIA DGX Spark، Apple Silicon MacBook اور Mac mini سمیت کمپیوٹرز پر اس کی تصدیق کی ہے۔ M4 Pro والے MacBook پر inference کی رفتار تقریباً 86-90 Token/s تک پہنچ سکتی ہے۔ 8K context length کے تحت زیادہ سے زیادہ میموری استعمال تقریباً 8.34 GiB ہے۔
حوالہ:
inclusionAI/Ling-3.0-tiny · Hugging Face