

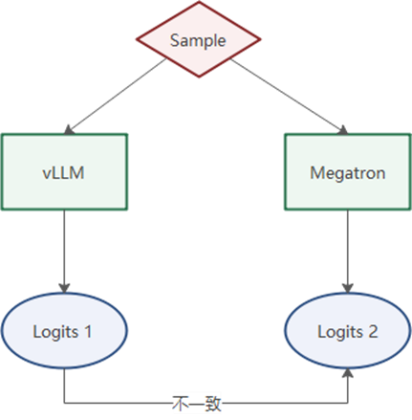
تقویتی سیکھنا بڑے ماڈلز کی تربیت کا مرکزی طریقہ بن چکا ہے، جو ماڈل ٹیکنالوجی کو صنعت کے اہم منظرناموں میں انجینئرنگ کے ذریعے نافذ کرنے کی رفتار بڑھا رہا ہے۔ ان میں ٹریننگ اور انفرنس کی مستقل مزاجی نہایت اہم ہے، کیونکہ انفرنس اور ٹریننگ کے عمل باہم جڑے ہوتے ہیں اور بنیادی ڈھانچے کے فرق سے غیر یقینی پن بڑھ سکتا ہے۔
ہواوے کمپیوٹنگ نے 5 اگست کو باضابطہ اعلان کیا کہ Ascend نے Ascend C پروگرامنگ زبان کی بنیاد پر ٹریننگ-انفرنس مستقل مزاجی کے لیے مکمل آپریٹر سیٹ فراہم کیا ہے۔ Qwen3-30B MoE ماڈل پر کیے گئے تجربے میں Logdiff کی قدر 0 رہی، جبکہ Ascend سے ہم آہنگ FA آپریٹر کی اصلاح کے ذریعے Eager موڈ میں 20%-60% کارکردگی کا فائدہ حاصل ہوا، جس سے ڈیولپرز کو تقویتی سیکھنے کی تربیت کا مؤثر اور قابلِ اعتماد حل فراہم کیا گیا۔
RL پوسٹ ٹریننگ میں ٹریننگ اور انفرنس کے عدمِ تسلسل کی بنیادی وجہ یہ ہے کہ زیریں سطح کی کمپیوٹنگ کے دوران جمع کرنے کی ترتیب محفوظ نہیں رہتی۔ اگر اوپر سے نیچے تک ٹریننگ انجن اور انفرنس انجن کے ہر جمع کے عمل کی ترتیب یکساں رکھنی ہو تو فریم ورک اور آپریٹر، دونوں سطحوں پر کام کرنا ہوگا۔ ماڈل کے پیرامیٹرز جتنے بڑے ہوں، مسئلہ اتنا ہی بڑھتا ہے: ٹینسر پیریلیل ازم، ایکسپرٹ پیریلیل ازم جیسی تقسیم کی حکمتِ عملیاں اور اجتماعی مواصلاتی راستے، کسی بھی مرحلے میں عدم مطابقت کی صورت میں حتمی true-on-policy حاصل نہیں کیا جا سکتا۔ آپریٹرز کو متعدد کالنگ منظرناموں کا بھی احاطہ کرنا ہوگا، اہم کمپیوٹنگ مراحل پر پابندیاں عائد کرنی ہوں گی، اور ساتھ ہی کارکردگی کے نقصان کو قابلِ استعمال حد میں رکھنا ہوگا، جو ایک نظامی انجینئرنگ چیلنج ہے۔
ٹریننگ اور انفرنس کے عدمِ تسلسل سے مراد Rollout (انفرنس) انجن اور ٹریننگ انجن کے درمیان عددی عدم مطابقت ہے۔ اگرچہ دونوں بالکل یکساں ماڈل وزن استعمال کریں، پھر بھی ایک ہی Token سلسلے پر حاصل ہونے والے لاگ امکانات (logprob) میں معمولی فرق ہو سکتا ہے؛ اس فرق کو عموماً logdiff سے ناپا جاتا ہے۔
Ascend نے Ascend C پروگرامنگ زبان کی بنیاد پر ٹریننگ-انفرنس سلسلے کے اہم آپریٹرز پر منظم پابندیاں اور ہم آہنگی نافذ کی ہے۔ بنیادی تصور یہ ہے کہ ٹریننگ اور انفرنس ان مقامات پر ایک ہی عددی راستہ اختیار کریں جہاں جمع کا عمل ہونا چاہیے۔ اس میں بنیادی طور پر درج ذیل 4 تبدیلیاں شامل ہیں:
توجہ کے مفہوم کو یکساں بنانا: ٹریننگ ماسک Softmax اور انفرنس کی مرحلہ وار توجہ میں مؤثر مقامات کے حسابی دائرے کو ہم آہنگ کرنا، تاکہ قابلِ مشاہدہ Token مجموعوں کے فرق سے پیدا ہونے والا عددی فرق ختم ہو۔
reduce جمع کی ترتیب کو مقفل کرنا: ٹریننگ FA، انفرنس PFA / PagedAttention میں reduction کے محور پر تقسیم اور جمع کی ترتیب کو محدود کرنا، تاکہ «ایک ہی ٹیمپلیٹ، مختلف تقسیم» سے پیدا ہونے والی بے ترتیب جمع سے بچا جا سکے۔
آن لائن Softmax بلاک حکمتِ عملی کو ہم آہنگ کرنا: بلاک کے حجم اور reduction کی رفتار کو یکساں بنانا، تاکہ decoder کی جانب متعدد بلاکس کے ملاپ والے Softmax اور ٹریننگ کی جانب بلاک شدہ Softmax میں عدم مطابقت نہ رہے۔
اہم راستے کی درستگی کو ہم آہنگ کرنا: Softmax جمع جیسے حساس مراحل میں درستگی کی تبدیلی کی حکمتِ عملی کو یکساں بنانا، تاکہ مخلوط درستگی کے نفاذ کے فرق سے پیدا ہونے والی آخری ہندسوں کی غلطی کم ہو۔
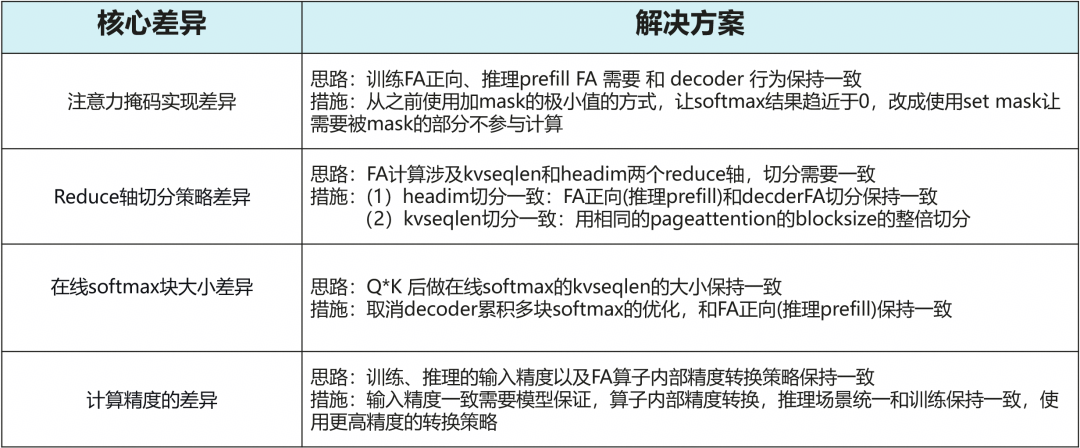
اس بنیاد پر FA کی ترسیل اور شیڈولنگ کی اصلاحات کو شامل کرنے سے ٹریننگ-انفرنس مستقل مزاجی اب نمایاں کارکردگی میں کمی کی قیمت پر حاصل نہیں ہوتی، بلکہ عملی تجربے میں بیک وقت logdiff=0 اور اینڈ ٹو اینڈ رفتار میں اضافہ حاصل ہوا۔
ہواوے نے اعلان کیا کہ متعلقہ بنیادی ڈھانچہ اوپن سورس کر دیا گیا ہے، اور «ٹریننگ-انفرنس مستقل مزاجی کے مسائل کی شناخت Skill» بھی شروع کیا جائے گا، جو باقی ماندہ logdiff کی جانچ اور یہ تعین کرنے میں مدد دے گا کہ مسئلہ آپریٹر کے راستے میں ہے یا فریم ورک کے نفاذ کے فرق میں۔
اوپن سورس پتہ:
https://github.com/verl-project/verl-ascend-recipe/tree/main/true_on_policy