

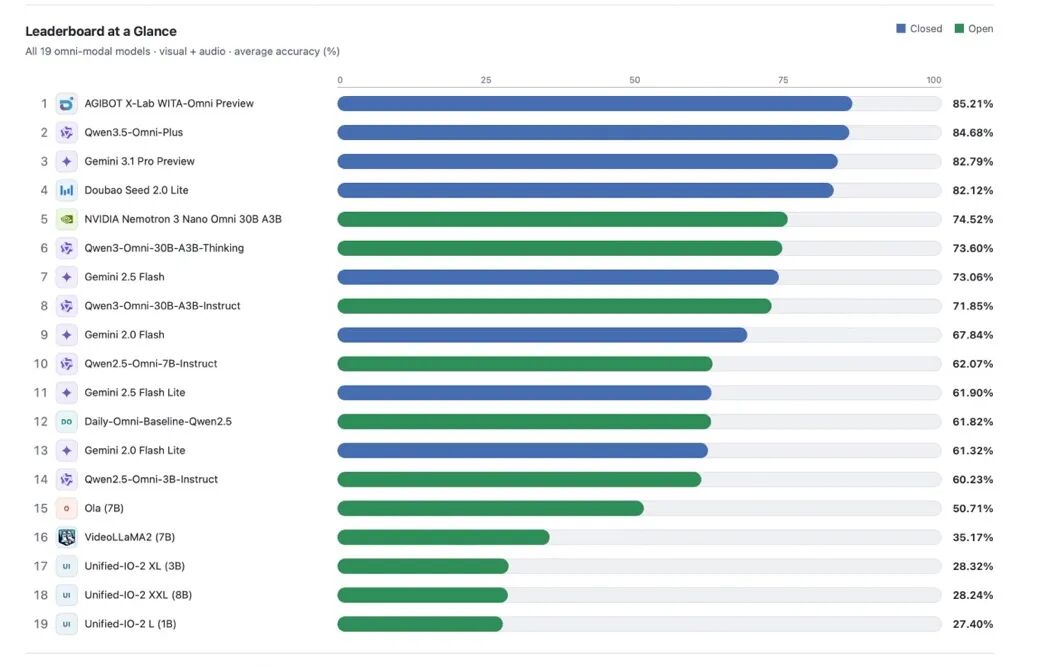
Zhiyuan AGIBOT کے WeChat آفیشل اکاؤنٹ کے مطابق، حال ہی میں ایمبوڈیڈ آل موڈل فہم کے مستند جدول DailyOmni کے تازہ ترین جائزے کے نتائج جاری ہوئے۔ Zhiyuan کے خود تیار کردہ ایمبوڈیڈ نیٹو آل موڈل بڑے ماڈل WITA-Omni Preview نے آڈیو و ویڈیو کی مشترکہ تفہیم اور زمانی استدلال کی نمایاں صلاحیتوں کے باعث 85.21 پوائنٹس کے مجموعی اسکور کے ساتھ سرفہرست مقام حاصل کیا۔ اس نے Qianwen، Gemini، Doubao اور NVIDIA سمیت اندرون و بیرون ملک کے معروف ماڈلز کو پیچھے چھوڑ دیا، جبکہ آٹھ ذیلی اشاریوں میں سے چھ میں پہلی پوزیشن حاصل کی۔
IT之家 کے مطابق، DailyOmni صنعت میں آڈیو و ویڈیو کی زمانی ہم آہنگی اور بین الموڈل مشترکہ استدلال کی صلاحیت جانچنے والا مستند تیسرے فریق کا جدول ہے۔ تصاویر و متن اور مختصر ویڈیوز پر مبنی معمول کے جائزہ کاموں سے مختلف، اس جدول میں کھلے حقیقی ماحول سے حاصل کردہ آڈیو و ویڈیو مواد بڑی مقدار میں استعمال کیا جاتا ہے۔ اس کا بنیادی امتحان ماڈل کی بصری مناظر اور ماحولیاتی آڈیو معلومات کو یکجا کرنے، آواز اور تصویر کے باہمی تعلق، واقعات کی زمانی ترتیب اور بین الموڈل معنوی معلومات کو درست طور پر سمجھنے کی جامع صلاحیت ہے۔ یہ حقیقی طبعی ماحول میں انسان نما روبوٹ کے انسان و مشین تعامل کے لیے درکار بنیادی ادراکی صلاحیتوں سے گہری مطابقت رکھتا ہے۔
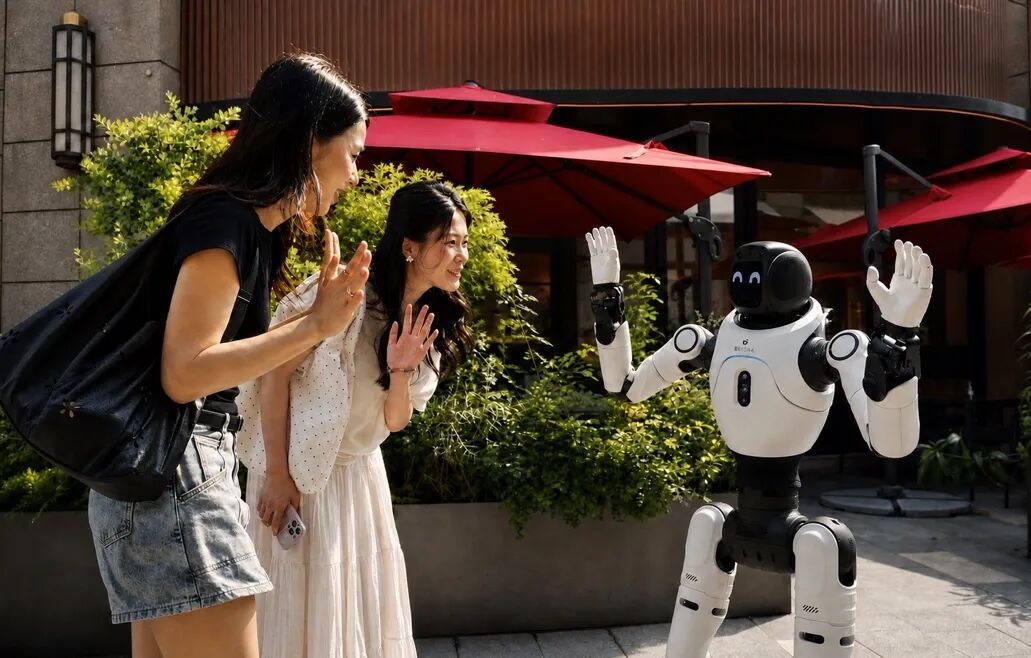
آفیشل بیان کے مطابق، WITA-Omni کی برتری کی کلیدی وجہ یہ ہے کہ یہ محض چیٹ ماڈل کو روبوٹ میں شامل نہیں کرتا، بلکہ جسمانی حرکات اور تاثرات کو آواز کے برابر درجہ اول کے آؤٹ پٹ میں تبدیل کرتا ہے۔ ایک نیٹو اینڈ ٹو اینڈ ماڈل کے ذریعے ادراک، فیصلہ سازی اور اظہار کو متحدہ طور پر کنٹرول کرتے ہوئے، یہ Thinker–Talker پیراڈائم کو مزید وسعت دے کر ایمبوڈیڈ آؤٹ پٹ کے لیے Thinker–Talker–Actor آرکیٹیکچر تشکیل دیتا ہے۔
WITA-Omni کی برتری محض ماڈل کے حجم پر منحصر نہیں، بلکہ ایمبوڈیڈ آل موڈل تعامل کے گرد تشکیل دیے گئے درجہ بند ڈیٹا نظام اور ہدفی تربیتی طریقوں سے حاصل ہوتی ہے۔ تربیت کے درمیانی مرحلے میں، WITA-Omni نے مجموعی طور پر کروڑوں گھنٹوں پر مشتمل اوپن سورس اور خود تیار کردہ ملٹی موڈل ڈیٹا استعمال کیا، جس کے ذریعے مضبوط متنی اور بصری بنیاد کو مزید ترقی دے کر ایسا آل موڈل ماڈل بنایا گیا جو “سن سکتا، سمجھ سکتا اور آواز و تصویر کی مشترکہ منطق انجام دے سکتا” ہے۔
اس کے علاوہ، عوامی آڈیو و ویڈیو ڈیٹا میں حقیقی تعامل کے دوران عام طور پر باری کی تبدیلی، ردعمل کا وقت، حرکات اور تاثرات کی معلومات موجود نہیں ہوتیں، اس لیے اسے اینڈ ٹو اینڈ ایمبوڈیڈ تعامل کے ماڈل کی براہ راست تربیت کے لیے استعمال کرنا مشکل ہوتا ہے۔ اسی مقصد کے لیے Zhiyuan نے انسان مرکز اور حقیقی تعامل کے منظرناموں پر مبنی بڑے پیمانے کا اعلیٰ معیار کا آل موڈل ڈیٹا سیٹ تیار کیا، جس میں آواز، منظر، زبان، حرکات اور تاثرات کے درمیان فطری زمانی تعلق کو مکمل طور پر محفوظ رکھا گیا ہے۔