

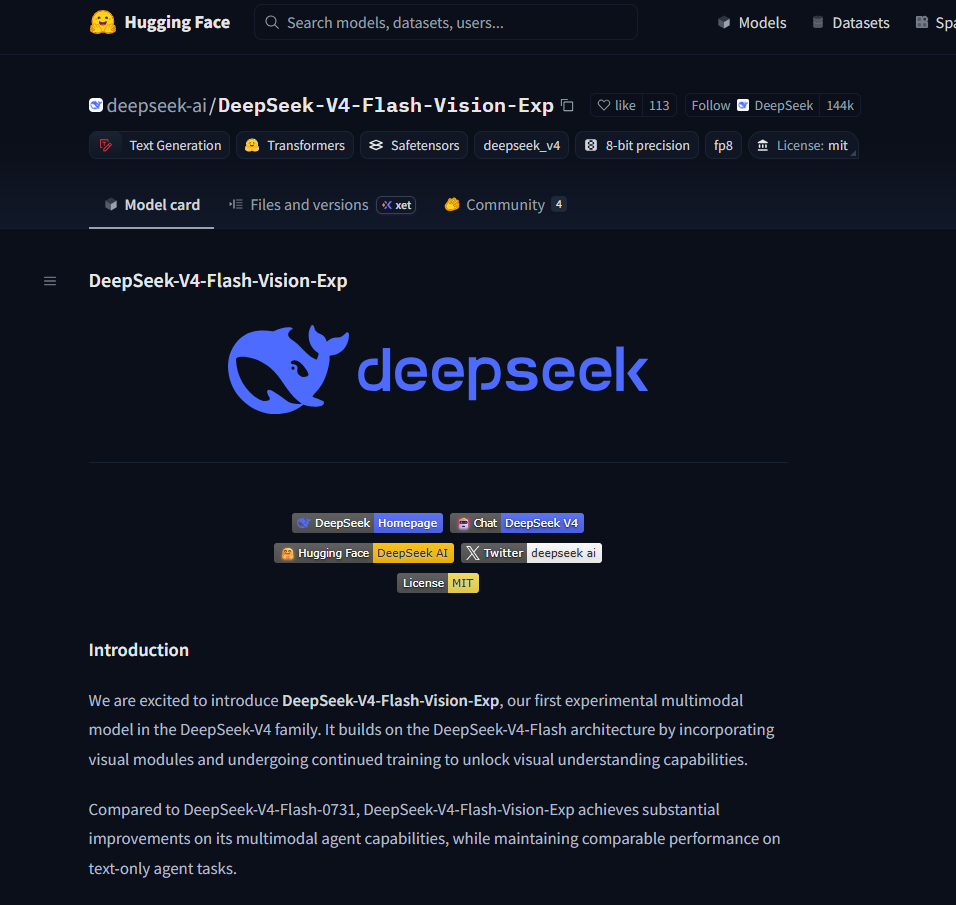
ابھی ابھی، DeepSeek V4 کا پہلا ملٹی موڈل ماڈل DeepSeek-V4-Flash-Vision-Exp، Hugging Face پر جاری کر دیا گیا ہے اور MIT License کے تحت اوپن سورس ہے۔
عوامی طور پر دستیاب مواد میں ماڈل فائلیں، Tokenizer، Prompt Encoding کا حوالہ جاتی نفاذ، اور کم سے کم PyTorch inference implementation شامل ہیں، جو وژن انکوڈر، Aligner، DFlash Attention، MoE، Hyper-Connections اور DSpark جیسے بنیادی ماڈیولز کا احاطہ کرتے ہیں۔
IT ہوم کی معلومات کے مطابق، DeepSeek-V4-Flash-Vision-Exp، DeepSeek V4 سیریز کا پہلا وژن ماڈل ہے جو مقامی طور پر تصویر ان پٹ کو سپورٹ کرتا ہے۔ اسے باضابطہ طور پر “Exp” تجرباتی ورژن کے طور پر نشان زد کیا گیا ہے اور یہ 2026 年 8 月 21 日 کو DeepSeek API پلیٹ فارم پر جاری ہوا۔
یہ ماڈل متن کے علاوہ تصاویر کو بھی ان پٹ کے طور پر قبول کرتا ہے، جس سے ماڈل تصاویر کی وضاحت، اسکرین شاٹس میں موجود متن کی شناخت اور چارٹس کا تجزیہ کر سکتا ہے۔ معاون تصویری فارمیٹس میں JPEG، PNG، GIF اور WebP شامل ہیں۔
DeepSeek کے مطابق، V4-Flash-Vision-Exp نے مختلف Agent فریم ورکس میں اچھی ملٹی موڈل موافقتی صلاحیت کا مظاہرہ کیا ہے اور متنوع Agent ٹولز کے ذریعے مزید عملی کام کے منظرنامے فعال کرنے میں مؤثر معاونت فراہم کر سکتا ہے۔ Agent، reasoning اور دنیا کے علم جیسے خالص متنی کاموں میں یہ V4-Flash کے حتمی ورژن کے برابر ہے اور اس کی سابقہ برتری مکمل طور پر برقرار ہے۔ بصری فہم درکار Agent بینچ مارک ٹیسٹوں میں اس نے V4-Flash کے مقابلے میں نمایاں بہتری دکھائی ہے، جبکہ ملٹی موڈل Agent صلاحیت Opus-4.8 کے قریب پہنچ گئی ہے۔