

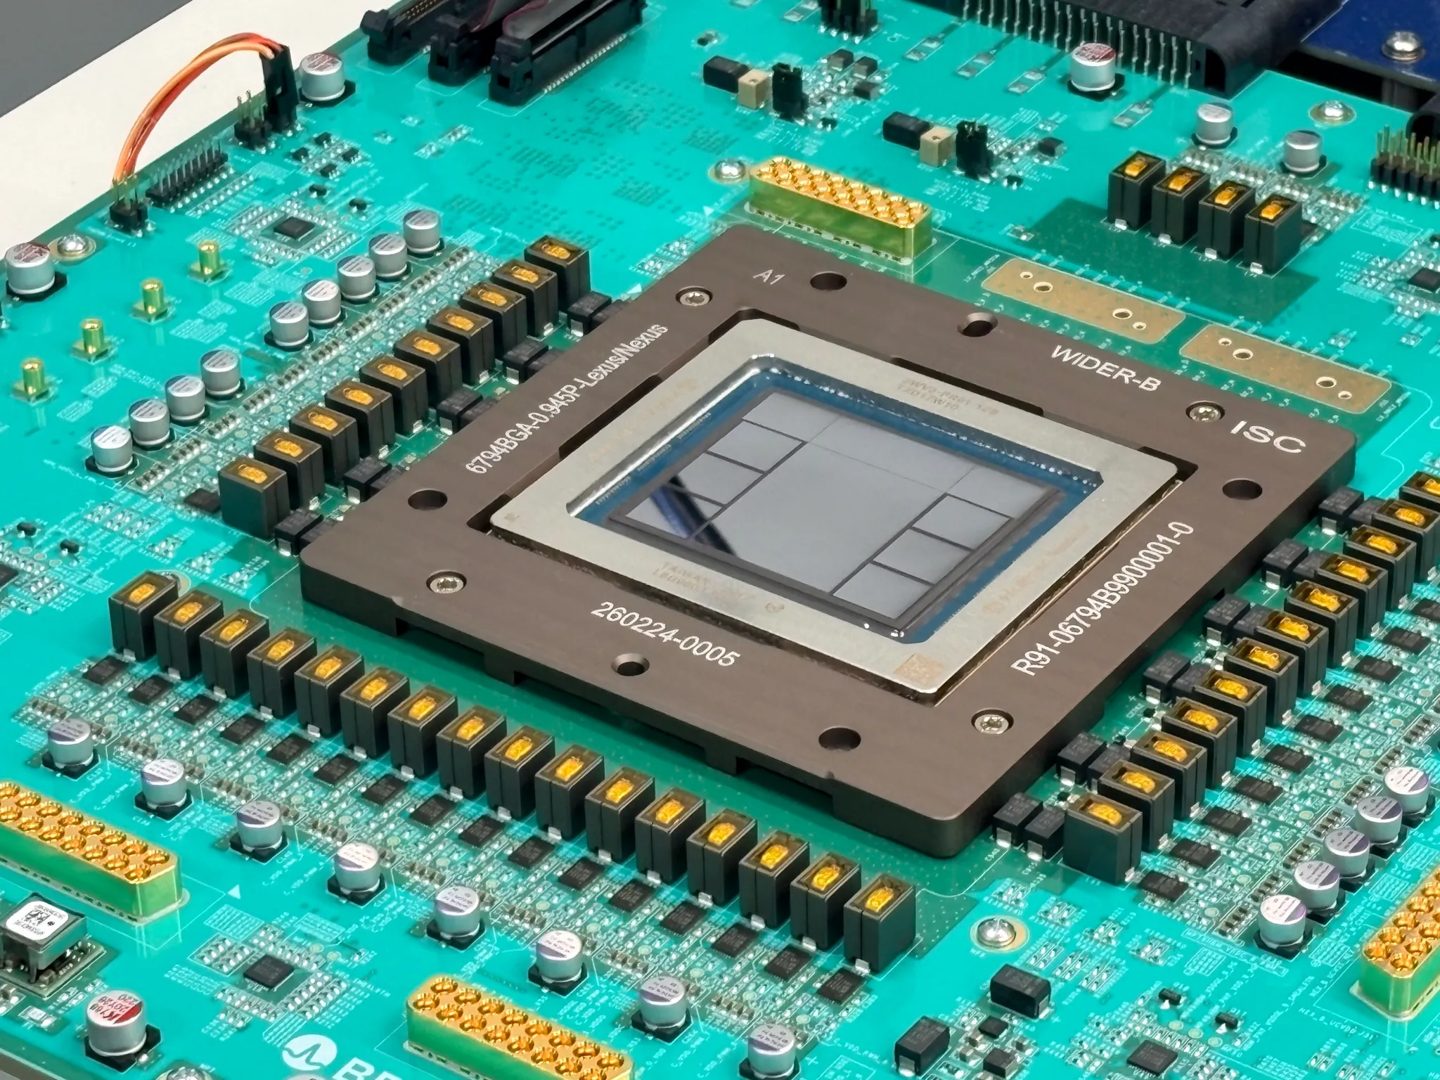
OpenAI نے آج (25 تاریخ) کی رات Hot Chips کانفرنس میں نئے انفرنس سسٹم Jalapeño کی مزید تفصیلات پیش کیں اور پہلی مرتبہ بینچ مارک ٹیسٹ کے نتائج بھی ظاہر کیے۔ SemiAnalysis کے InferenceX ٹیسٹ میں Jalapeño نے فی صارف ٹوکن پراسیسنگ اور فی کلوواٹ تھروپٹ، دونوں میں، مارکیٹ میں دستیاب معروف ترین انفرنس پروسیسرز کو پیچھے چھوڑ دیا۔
OpenAI کے ہارڈویئر سربراہ رچرڈ ہو نے میڈیا کے ساتھ ٹیلی فونک گفتگو میں کہا: “ٹیسٹ کے نتائج میں سب سے اہم بات یہ ہے کہ Jalapeño نے موجودہ جدید ترین مصنوعات کے مقابلے میں کارکردگی میں نمایاں بہتری حاصل کی ہے۔ یہ اتنی ہی بجلی استعمال کرتے ہوئے زیادہ AI ورک لوڈ پراسیس کر سکتی ہے اور ساتھ ہی زیادہ تیزی سے جواب دے سکتی ہے۔ Jalapeño بڑی تعداد میں صارفین کو مؤثر خدمات فراہم کرنے کے لیے موزوں ہے اور کم تاخیر بھی برقرار رکھتی ہے۔”
Jalapeño کو OpenAI اور Broadcom نے مشترکہ طور پر تیار کیا ہے، جبکہ OpenAI کے اپنے ماڈلز نے بھی اس کی تحقیق و ترقی میں حصہ لیا۔ OpenAI کو امید ہے کہ Jalapeño کو ایک ایسے ٹیکنالوجی پلیٹ فارم کے طور پر ترقی دی جائے گی جو کئی نسلوں تک جاری رہے، تاکہ AI مصنوعات، ماڈلز، چپس اور میموری کو ابتدا ہی سے باہمی ہم آہنگی کے ساتھ ڈیزائن کیا جا سکے۔
یہ چپ بنیادی طور پر AI انفرنس کے لیے ذمہ دار ہے، یعنی تربیت یافتہ AI ماڈلز کو حقیقتاً چلانا، کام مکمل کرنا یا AI ایجنٹس کو فعال کرنا۔
OpenAI نے Jalapeño کی انفرنس کارکردگی جانچنے کے لیے InferenceX پلیٹ فارم استعمال کیا اور اس کا موازنہ Nvidia GB200 اور GB300 سپر چپ سسٹمز سے کیا۔ OpenAI کے مطابق GPT-OSS 120B، DeepSeek R1 اور Kimi K2.5 1T تینوں ماڈلز پر Jalapeño فی واٹ مکمل کیے جانے والے AI ورک لوڈ کے لحاظ سے تقابلی نظاموں سے 1.5 سے 1.9 گنا بہتر ہے، جبکہ اینڈ ٹو اینڈ تاخیر تقابلی نظاموں کی تقریباً 28% سے 59% ہے۔
مکمل اسٹیک کی باہمی ہم آہنگ ترقی نے OpenAI کو انفرنس کے دوران رفتار کم کرنے والے اہم مراحل کو براہِ راست بہتر بنانے کے قابل بھی بنایا۔ Jalapeño پری فل اور کمیونیکیشن کے مراحل کی تاخیر کم کرنے پر خصوصی توجہ دیتی ہے، کیونکہ OpenAI کے خیال میں یہ دونوں مراحل اکثر انفرنس کارکردگی کی بنیادی رکاوٹ ہوتے ہیں۔
OpenAI نے ٹیسٹ کے نتائج جاری کرنے والی بلاگ پوسٹ میں بتایا کہ Jalapeño کو ڈیزائن کے آغاز ہی سے ڈیٹا منتقلی اور کمیونیکیشن کی تاخیر کم سے کم رکھنے کے لیے تیار کیا گیا۔ جواب تیار کرتے وقت استعمال ہونے والی KV کیش جیسی ماڈل حالتوں کو واضح طور پر مقامی طور پر محفوظ اور برقرار رکھا جا سکتا ہے، جبکہ نظام انفرنس کے مختلف مراحل کے مطابق مناسب کمپیوٹنگ، میموری اور نیٹ ورک وسائل مختص کرتا ہے۔
آئی ٹی ہوم کے مطابق، OpenAI کا منصوبہ ہے کہ رواں سال کے اختتام سے پہلے Jalapeño کو پہلے “محدود پیمانے” پر تعینات کیا جائے، پھر 2027 میں تعیناتی کا حجم بتدریج بڑھایا جائے، تاہم اگلے سال استعمال کی جانے والی چپس کی مخصوص تعداد ظاہر نہیں کی گئی۔
حوالہ
OpenAI کا سرکاری مضمون: Jalapeño’s first results show industry-leading speed and efficiency in AI inference