

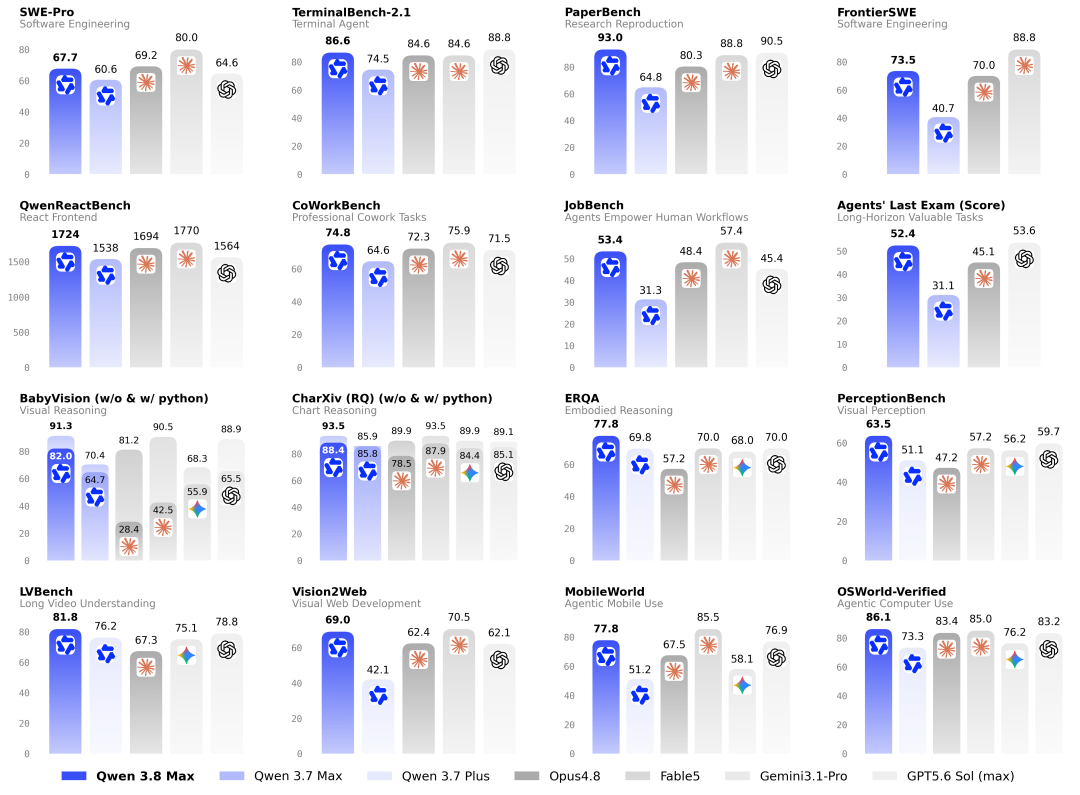
علی کلاؤڈ کی “ModelScope کمیونٹی” کے آفیشل اکاؤنٹ نے گزشتہ روز (12 تاریخ) نصف شب کے بعد اعلان کیا کہ علی کا Qwen گروپ باضابطہ طور پر Qwen3.8-2.4T-A95B ماڈل کے وزن جاری کر رہا ہے۔
یہ Qwen-Max سطح کے ماڈل کے وزن پہلی مرتبہ اوپن سورس کیے گئے ہیں: ماڈل کے کل پیرامیٹرز 2.4T ہیں، ہر Token پر 95B پیرامیٹرز فعال ہوتے ہیں، مقامی طور پر 262,144 Token کانٹیکسٹ سپورٹ کرتا ہے، اور اسے 1,010,000 Token تک بڑھایا جا سکتا ہے۔
Qwen3.8 نے Qwen3.5 کا ہائبرڈ آرکیٹیکچر برقرار رکھتے ہوئے پروگرامنگ، دفتری امور، سائنسی تحقیق اور طویل مدتی Agent کاموں کو آخر تا آخر مکمل کرنے کی صلاحیت میں بہتری پر توجہ دی ہے۔ آفیشل کلاؤڈ ورژن Qwen3.8-Max اسی جاری کردہ ماڈل کے وزن پر مبنی ہے اور اس میں پیداواری ماحول کی مزید صلاحیتیں شامل کی گئی ہیں۔
سرکاری جائزوں میں پروگرامنگ Agent، عمومی Agent، پیشہ ورانہ کام اور طویل کانٹیکسٹ سمیت مختلف شعبوں کا احاطہ کیا گیا ہے؛ Opus 4.8، Fable 5 اور GPT 5.6 Sol جیسے ماڈلز کے مقابلے میں نتائج مختلف شعبوں میں بلند و پست رہے، جبکہ PaperBench اور IFBench جیسے Benchmark میں درج ماڈلز میں نسبتاً بہتر کارکردگی حاصل کی گئی۔
متعلقہ روابط درج ذیل ہیں:
ماڈل: https://modelscope.cn/models/Qwen/Qwen3.8-2.4T-A95B
blog: https://qwen.ai/blog?id=qwen3.8
Qwen Studio: https://chat.qwen.ai
Qwen3.8-2.4T-A95B ایک causal language model ہے، جس کے کل پیرامیٹرز 2.4T ہیں اور ہر Token پر 95B پیرامیٹرز فعال ہوتے ہیں۔ ماڈل کی ہر MoE پرت میں 512 ماہرین شامل ہیں؛ ہر Token کے لیے 10 روٹنگ ماہرین منتخب کیے جاتے ہیں اور بیک وقت 1 مشترکہ ماہر بھی فعال ہوتا ہے۔
ماڈل کو متعدد مراحل پر مشتمل MTP (Multi-Token Prediction) تربیت بھی دی گئی ہے، جس سے متعلقہ میکانزم کو سپورٹ کرنے والے inference انجن کو متعدد بعد کے Token کی پیش گوئی کرنے کی صلاحیت ملتی ہے۔
تعارف کے مطابق، Qwen3.8-Max کی دفتری اور Agent بعد از تربیت کو تین مراحل میں بیان کیا گیا ہے:
حقیقی ماحول کو مسلسل وسعت دینا اور ان آزاد جہتوں کو ایک دوسرے سے الگ رکھنا: کام (Task) (واحد کام → متعدد کام → کئی دنوں پر محیط کام)، ورک اسپیس (Workspace) (متعدد فائلیں → درجہ بند ڈائریکٹریاں → پیچیدہ مختلف النوع ڈائریکٹریاں)، اور Harness (مختلف زمرے، ورژنز اور مہارتیں)۔ اس سے ماحول کی تعداد逐一 حسب ضرورت انضمام پر انحصار کرنے کے بجائے امتزاجی طریقے سے قدرتی طور پر بڑھ سکتی ہے۔
ایک متحدہ reward system تیار کرنا، جو حقیقی کاموں میں مختلف نوعیت کے verification طریقوں کو اپنے اندر شامل کرے۔ یہ نظام execution پر مبنی جانچ، متن اور render کیے گئے بصری output کی rubric تشخیص، اور agentic جانچ پر مشتمل ہے۔ ہم نے مختلف شکلوں اور modalities کو ایک ہی reward system میں متحد کیا ہے، جس سے تمام ماحول کے لیے یکساں اور قابل اعتماد reward signal فراہم ہوتا ہے اور کام کے لیے مخصوص verifier برقرار رکھنے میں موجود عدم مطابقت ختم ہوتی ہے۔
ایک online data balancer تیار کرنا، جو ہر batch کی تشکیل نو کرے تاکہ Task، difficulty، Workspace اور Harness کے لحاظ سے اس کی تقسیم انتہائی متوازن رہے، batch کے درمیان gradient variance کم ہو، اور یوں reinforcement learning کی تربیتی compute کو مستحکم اور مسلسل طور پر وسعت دینا ممکن ہو۔