

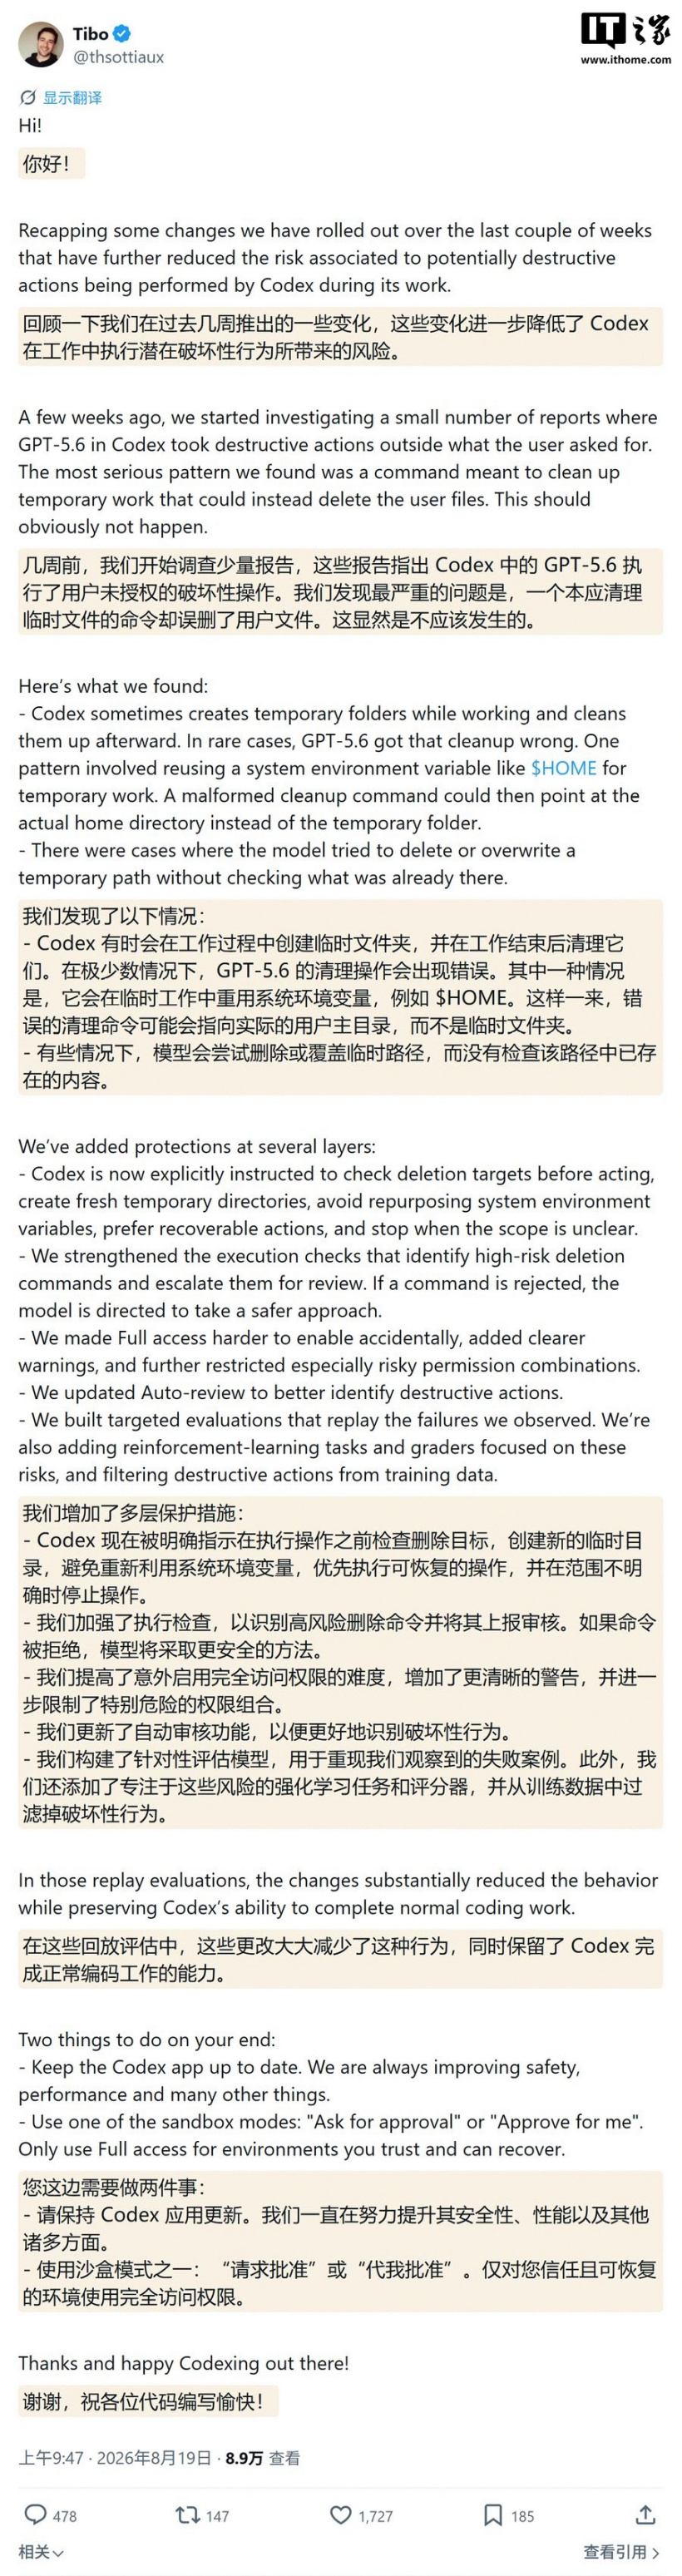
OpenAI کی Codex ٹیم کے سربراہ تھیبو · سوٹیو (Thibault Sottiaux) نے آج X پلیٹ فارم پر ایک طویل پوسٹ شائع کی، جس میں Codex کے اندر GPT-5.6 سیریز کے ماڈلز استعمال کرنے کے بعد چند صارفین کی فائلیں غلطی سے حذف ہونے کے مسئلے کا جواب دیا گیا۔
سوٹیو نے بتایا کہ چند ہفتے قبل سے Codex کے چند صارفین کی جانب سے مسلسل رائے موصول ہو رہی ہے کہ Codex میں GPT-5.6 سیریز کے ماڈلز استعمال کرنے کے بعد ایسے تباہ کن اقدامات کیے گئے جن کی صارفین نے اجازت نہیں دی تھی۔ OpenAI نے دریافت کیا کہ عارضی فائلوں کو صاف کرنے کے لیے بنایا گیا کمانڈ صارفین کی فائلیں حذف کر رہا تھا۔
ایک صورت حال میں Codex عارضی کام کے دوران $HOME جیسے سسٹم ماحول کے متغیرات کو دوبارہ استعمال کرتا تھا۔ اس طرح صفائی کا غلط کمانڈ حقیقی صارف ہوم ڈائریکٹری کی جانب اشارہ کر سکتا تھا۔ بعض صورتوں میں ماڈل عارضی راستے میں موجود مواد کی جانچ کیے بغیر اسے حذف یا اوور رائٹ کرنے کی کوشش کرتا تھا۔ متعلقہ اسکرین شاٹ ذیل میں ہے:
سوٹیو نے جواب دیتے ہوئے بتایا کہ متعدد حفاظتی اقدامات شامل کیے گئے ہیں:
Codex کو اب واضح طور پر ہدایت دی گئی ہے کہ کارروائی سے پہلے حذف کیے جانے والے ہدف کی جانچ کرے، نئی عارضی ڈائریکٹری بنائے، سسٹم ماحول کے متغیرات کو دوبارہ استعمال کرنے سے گریز کرے، قابلِ بازیافت کارروائیوں کو ترجیح دے، اور دائرہ کار واضح نہ ہونے پر کارروائی روک دے۔
OpenAI نے عمل درآمد کی جانچ مضبوط کی، زیادہ خطرناک حذف کرنے والے کمانڈز کی شناخت بہتر بنائی اور انہیں جائزے کے لیے رپورٹ کرنے کا نظام بنایا۔ اگر کمانڈ مسترد ہو جائے تو ماڈل زیادہ محفوظ طریقہ اختیار کرے گا۔
OpenAI نے مکمل رسائی کے غیر ارادی طور پر فعال ہونے کو مشکل بنا دیا، مزید واضح انتباہات شامل کیے اور خاص طور پر خطرناک اجازتوں کے امتزاج پر مزید پابندیاں عائد کیں۔
OpenAI نے خودکار جائزے کے نظام کو اپ ڈیٹ کیا تاکہ تباہ کن رویے کی بہتر شناخت کی جا سکے۔
OpenAI نے مشاہدہ کیے گئے ناکامی کے واقعات کو دوبارہ پیش کرنے کے لیے مخصوص جائزہ ماڈلز تیار کیے۔ اس کے علاوہ، ان خطرات پر مرکوز تقویتی سیکھنے کے کام اور اسکوررز بھی شامل کیے گئے، اور تربیتی ڈیٹا سے تباہ کن رویے کو فلٹر کر دیا گیا۔