

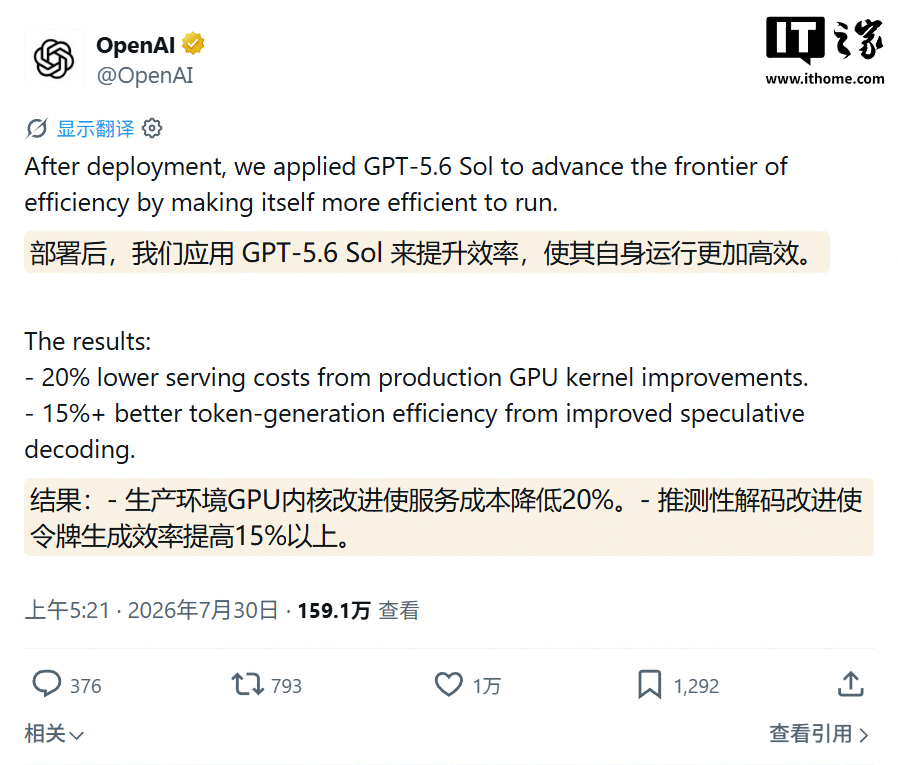
OpenAI نے گزشتہ روز (29 جولائی) ایک بلاگ پوسٹ جاری کرتے ہوئے اعلان کیا کہ GPT-5.6 Sol ماڈل کے ذریعے GPT-5.6 سیریز کے ماڈلز کے اپنے AI استدلالی عمل کو بہتر بنایا گیا ہے، جس سے اینڈ ٹو اینڈ سروس کی لاگت میں زیادہ سے زیادہ 20٪ کمی ہوئی۔
OpenAI نے 9 جولائی کو اپنا طاقتور ترین AI ماڈل GPT-5.6 سیریز جاری کیا۔ بعد ازاں فن تعمیر کو بہتر بنانے کے عمل میں، اس کی سرکاری ٹیم نے GPT-5.6 Sol ماڈل کو اپنی آپریشنل کارکردگی بہتر بنانے، کمپیوٹنگ لاگت کم کرنے اور GPU کے استعمال کی کارکردگی بڑھانے کے لیے استعمال کیا۔
OpenAI کے مطابق، نظام درخواستوں کو خطے، دستیاب گنجائش اور ایکسیلیریٹر کی قسم کے لحاظ سے تقسیم کرتا ہے؛ کلسٹر کے اندر کام تقسیم کرتے وقت لوڈ، سیاق و سباق کی لمبائی اور کیش کی دستیابی جیسے عوامل کو بھی مدنظر رکھا جاتا ہے۔ GPT‑5.6 Sol نے Codex کے ذریعے پروڈکشن ٹریفک کا تجزیہ کیا، لوڈ میں عدم توازن کے ذرائع کی شناخت کی، روٹنگ کی حکمت عملیوں کی جانچ کی اور ہیورسٹک قواعد کو ایڈجسٹ کیا۔
ماڈل کے فارورڈ پروپیگیشن مرحلے میں، GPT‑5.6 Sol نے ایسے کاموں کی شناخت کی جنہیں پہلے سے شمار، ختم یا متوازی طور پر انجام دیا جا سکتا تھا، اور Codex کے ذریعے پروڈکشن ماحول میں موجود GPU کرنلز کو خودکار طور پر دوبارہ لکھ کر بہتر بنایا۔ متعلقہ اسکرین شاٹس درج ذیل ہیں:
ٹیم نے GPT-5.6 Sol ماڈل کو Triton اور Gluon دونوں پروگرامنگ زبانیں سکھائیں، تاکہ ماڈل کی مدد سے استدلالی انجن کے کرنلز کو بہتر بنایا جا سکے اور پروڈکشن ماحول میں GPU کرنلز کے باعث اینڈ ٹو اینڈ سروس کی لاگت میں زیادہ سے زیادہ 20٪ کمی لائی جا سکے۔
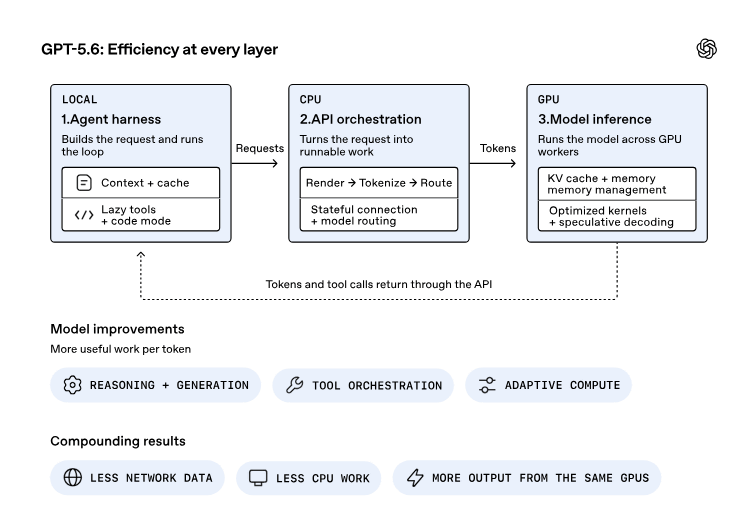
OpenAI نے GPT‑5.6 Sol کے تیار کردہ کرنلز کی درستگی کی تصدیق کے لیے اوپن سورس ٹول FpSan (فلوٹنگ پوائنٹ کلینر) بھی استعمال کیا۔
OpenAI نے GPT-5.6 Sol کو قیاسی ڈی کوڈنگ (speculative decoding) کو بہتر بنانے کے لیے بھی استعمال کیا۔ یہ استدلالی رفتار بڑھانے والی ٹیکنالوجی ایک چھوٹے ڈرافٹ ماڈل کے ذریعے اگلے token کی پیش گوئی کرتی ہے، پھر مرکزی ماڈل پیش گوئی کے نتیجے کی تصدیق یا اصلاح کرتا ہے۔ OpenAI نے 29 جولائی 2026 کی عوامی پوسٹ میں کہا کہ بہتری کے بعد token تیار کرنے کی کارکردگی میں 15٪ سے زیادہ اضافہ ہوا۔