
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-13
01QwenGyre کیا ہے
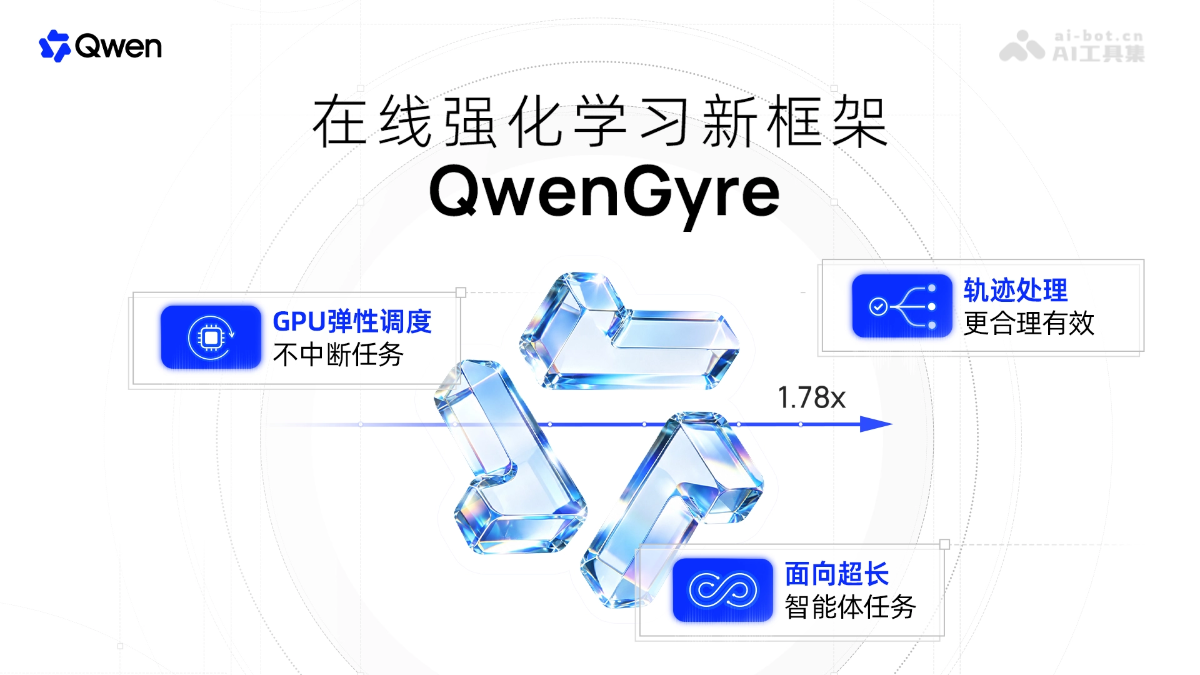
QwenGyre علی بابا کے Qwen کی جانب سے پیش کیا گیا طویل دورانیے والے ایجنٹس کے لیے آن لائن Reinforcement Learning فریم ورک ہے، جو ایک بار میں تقریباً 700,000 ٹوکن اور کئی گھنٹے جاری رہنے والے کاموں کے لیے بنایا گیا ہے۔ QwenGyre لچک دار شیڈولنگ کے ذریعے کام میں خلل ڈالے بغیر فارغ GPU کو sampling اور training کے درمیان منتقل کرتا ہے، جبکہ trajectory processing حقیقی context محفوظ رکھتی ہے، جزوی نتائج کا جائزہ لیتی ہے اور لاگت کم کرنے کے لیے مشترکہ prefixes کو deduplicate کرتی ہے۔ Qwen3.8-2.4T پر 48 steps میں NL2RepoBench کی کامیابی کی شرح 52.48% سے بڑھا کر 58.54% کی گئی، جو Async کے مقابلے میں end-to-end رفتار میں 1.78× اضافہ ہے۔
02QwenGyre کے اہم افعال
طویل دورانیے والے ایجنٹس کی آن لائن Reinforcement Learning: ایسے کاموں پر براہِ راست RL training جو ایک execution میں کئی گھنٹے جاری رہیں اور مجموعی طور پر تقریباً 1 million tokens پر مشتمل ہوں۔
لچک دار GPU شیڈولنگ: کام میں خلل ڈالے بغیر فارغ GPU کو sampling اور training کے درمیان متحرک طور پر منتقل کرنا۔
درخواستوں کی re-routing اور KV cache migration: GPU کے کردار تبدیل ہونے پر ایجنٹ کا کام جاری رہتا ہے، workspace اور tool state محفوظ رہتے ہیں، جبکہ RDMA کے ذریعے KV cache منتقل کر کے دوبارہ computation کم کی جاتی ہے۔
Streaming training اور نئے nodes کی دورانِ عمل شمولیت: بنیادی cell مستند parameters محفوظ رکھتا ہے، جبکہ satellite cell کسی بھی وقت snapshot حاصل کر کے جاری batch میں شامل ہو سکتا ہے اور progress کے مطابق micro-batches لے سکتا ہے۔
Trajectory tree اور حقیقی context کا تحفظ: ہر call کے درست input اور output کو Token-in Token-out کے ذریعے ریکارڈ کیا جاتا ہے، پھر مشترکہ prefixes کے مطابق trajectory tree میں منظم کیا جاتا ہے، تاکہ ہر output اسی context سے مطابقت رکھے جس میں وہ generate ہوا تھا۔
جزوی اسکورنگ (Partial Scoring): وقت ختم ہونے سے نامکمل رہ جانے والے کاموں سے قابلِ جانچ نتائج حاصل ہوں تو انہیں بھی task rules کے مطابق score کر کے training میں استعمال کیا جاتا ہے۔
Trajectory budget اور loss balancing: ہر execution میں زیادہ سے زیادہ Jmax trajectories محفوظ رکھی جاتی ہیں، مشترکہ prefix کے لیے loss صرف ایک بار شمار کیا جاتا ہے، تاکہ زیادہ branches والے کاموں کا وزن حد سے زیادہ نہ ہو۔
03QwenGyre کا تکنیکی اصول
لچک دار شیڈولر (Elastic Scheduler): GPU کو متعدد یکساں computing units میں تقسیم کیا جاتا ہے۔ ہر cell، SGLang کے ذریعے sampling service فراہم کر سکتا ہے یا Megatron کے ذریعے مکمل training replica چلا سکتا ہے۔ شیڈولر زیرِ تکمیل کاموں کی مقدار یعنی ”watermark“ کو track کرتا ہے۔ جب تک باقی sampling capacity جاری کاموں کو سہارا دینے کے لیے کافی ہو اور training data کی فراہمی مناسب ہو، cells کو باری باری training میں شامل کیا جاتا ہے۔ منتقلی کے وقت proxy model requests کو نئے inference engine کی طرف redirect کرتا ہے اور نامکمل requests کو retry کرتا ہے؛ backend processes اور communication groups کو دوبارہ بنانے کی ضرورت نہیں پڑتی۔ بنیادی cell مستند weights اور optimizer state رکھتا ہے، جبکہ satellite cells RDMA کے ذریعے parameter snapshot حاصل کر کے موجودہ batch کے gradient accumulation میں شامل ہو جاتے ہیں۔ آخر میں بنیادی cell یکجا طور پر update کرتا ہے، جس سے data تیار ہوتے ہی training بتدریج پھیلتی ہے اور sampling و training میں زیادہ overlap رہتا ہے۔
Trajectory Processor: QwenGyre proxy کے ذریعے ہر model call کے درست input/output token IDs اور behavior policy log probabilities ریکارڈ کرتا ہے، مشترکہ prefixes کو reuse کرتا ہے اور branching points پر branches بناتا ہے، یوں trajectory tree تشکیل پاتا ہے اور ہر output اپنے اصل generation context سے مطابقت رکھتا ہے۔ Training admission کے مرحلے میں role priority کے مطابق ہر execution کے لیے Jmax سے زیادہ نہیں trajectories منتخب کی جاتیں۔ صرف policy model کے generate کردہ tokens loss میں شامل ہوتے ہیں اور مشترکہ target صرف ایک بار شمار کیا جاتا ہے۔ پہلے execution کے اندر منتخب tokens کا average لیا جاتا ہے، پھر executions کا average، تاکہ execution weight اس کی branches کی تعداد سے آزاد رہے۔ Partial Scoring کے ذریعے وقت سے تجاوز کرنے والے کاموں کے مکمل شدہ حصوں کا جائزہ لے کر score کیا جاتا ہے، جس سے طویل دورانیے والے executions میں موجود کم یاب اور مہنگے مؤثر signals سے زیادہ سے زیادہ فائدہ اٹھایا جا سکتا ہے۔
04QwenGyre کا استعمال کیسے کریں
فی الحال QwenGyre کو ایک تحقیقی مقالے کی صورت میں جاری کیا گیا ہے؛ علی بابا نے ابھی تک code یا installation package عوامی نہیں کیا۔
05QwenGyre کے بنیادی فوائد
Flagship model کے لیے طویل دورانیے والی آن لائن RL کی پہلی تکمیل: Qwen3.8-2.4T پر تقریباً 700,000 tokens کے واحد execution والے کاموں کی آن لائن Reinforcement Learning مکمل کی گئی، اور 48 steps میں NL2RepoBench کی کامیابی کی شرح 52.48% سے بڑھ کر 58.54% ہو گئی۔
Training efficiency میں نمایاں اضافہ: یکساں GPU budget کے تحت end-to-end رفتار میں Async کے مقابلے میں زیادہ سے زیادہ 1.78× اور Colocate کے مقابلے میں 1.85× اضافہ ہوا؛ 48 steps کی training کا وقت 134.55 گھنٹوں سے کم ہو کر 75.42 گھنٹے رہ گیا۔
کام میں صفر خلل والی لچک دار شیڈولنگ: sampling اور training کے درمیان GPU کے متحرک طور پر منتقل ہونے کے دوران agent execution، workspace اور tool state مکمل طور پر محفوظ رہتے ہیں۔ منتقلی میں صرف چند سیکنڈ لگتے ہیں، جو کئی گھنٹوں کے execution کے مقابلے میں قابلِ نظرانداز ہیں۔
GPU utilization کو زیادہ سے زیادہ کرنا: cell سطح پر باریک وسائل کی تقسیم Colocate mode میں طویل انتظار اور idle رہنے اور Async mode کی جامد تقسیم کی رکاوٹوں کو ختم کرتی ہے، جبکہ training کو sampling کے ذریعے مکمل طور پر چھپایا جا سکتا ہے۔
حقیقی context کی وفادار training: TITO mechanism یقینی بناتا ہے کہ ہر output اسی اصل context سے مطابقت رکھے جس میں وہ generate ہوا تھا، یوں history compression یا sub-agent context concatenation سے پیدا ہونے والے ”جعلی context“ کے training signals سے بچا جاتا ہے۔
06QwenGyre کا پروجیکٹ لنک
arXiv تکنیکی مقالہ:https://arxiv.org/pdf/2609.33848
07QwenGyre کے استعمال کے منظرنامے
قدرتی زبان سے مکمل code repository کی تخلیق: قدرتی زبان کی specification کے مطابق صفر سے multi-package software repository بنانا، جس میں ایک execution تقریباً 700,000 tokens اور کئی گھنٹے جاری رہتا ہے۔
موجودہ repository میں طویل دورانیے والی software engineering: موجودہ codebase میں feature development، bug fixing اور متعدد files میں تبدیلی جیسے پیچیدہ کام مکمل کرنا۔
متعدد دور کی terminal automation: agent کا command-line environment میں مسلسل سینکڑوں tool calls انجام دے کر system configuration اور operations کے کام مکمل کرنا۔
بڑے codebase کی refactoring اور migration: repositories کے درمیان technology stack upgrade اور مکمل refactoring جیسے engineering tasks، جن کے لیے کئی گھنٹوں تک مسلسل planning اور execution درکار ہو۔
متعدد agents کے اشتراکی کام: ایسے hierarchical execution scenarios جن میں مرکزی agent sub-agents کو کام سونپتا ہے؛ trajectory processing branching structure سے فائدہ اٹھا کر subtask training کی لاگت کو کنٹرول کر سکتی ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0