
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-10
01TalkLikeYou کیا ہے؟
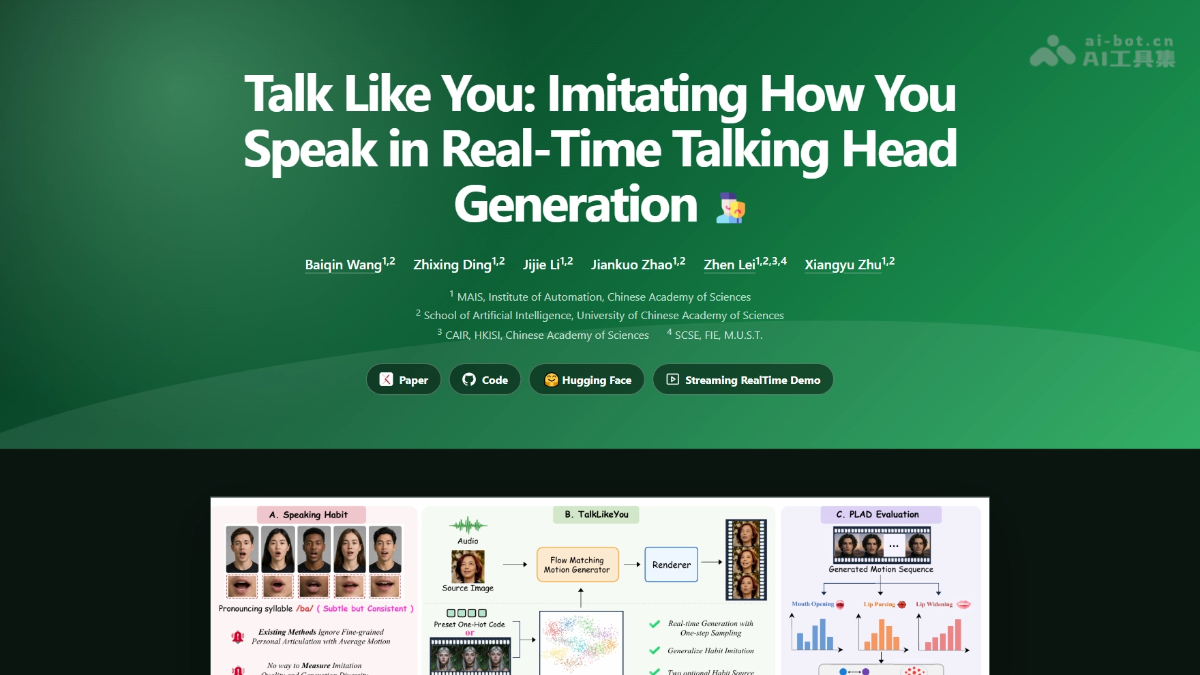
TalkLikeYou چائنیز اکیڈمی آف سائنسز کے انسٹی ٹیوٹ آف آٹومیشن کا اوپن سورس ریئل ٹائم ڈیجیٹل ہیومن فریم ورک ہے۔ یہ ایک تصویر اور ایک آڈیو کلپ لے کر تصویر میں موجود شخص کو بولنے کے قابل بناتا ہے، جبکہ ہونٹوں کی حرکات کسی مخصوص حقیقی شخص کے بولنے کے انداز کی نقل کر سکتی ہیں۔ TalkLikeYou موشن اسپیس ماڈلنگ اور ون-اسٹیپ سیمپلنگ کے ذریعے ریئل ٹائم جنریشن انجام دیتا ہے، پیش سیٹ نمبر یا حوالہ جاتی ویڈیو کے ذریعے بولنے کے انداز کو حسب ضرورت بنانے کی سہولت دیتا ہے، نقل کی مماثلت کو مقدار میں ناپنے کے لیے خصوصی پیمانہ پیش کرتا ہے، اور اس کا تمام کوڈ و وزن اوپن سورس ہے۔
02TalkLikeYou کے اہم فیچرز
بولتی ہوئی تصویر: ایک پورٹریٹ تصویر اور ایک آڈیو کلپ اپ لوڈ کریں، اور بولتے ہوئے کردار کی ویڈیو تیار کریں۔
بولنے کے انداز کی نقل: کسی مخصوص حقیقی شخص کے ہونٹوں کی حرکات اور بولنے کے انداز کی نقل کریں؛ اس کے لیے پیش سیٹ نمبر یا 4 سیکنڈ کی حوالہ جاتی ویڈیو استعمال کی جا سکتی ہے۔
ریئل ٹائم جنریشن: ون-اسٹیپ سیمپلنگ ٹیکنالوجی کے ذریعے جنریشن کی رفتار 32.43 FPS تک پہنچتی ہے اور ریئل ٹائم اسٹریمنگ آؤٹ پٹ کو سپورٹ کرتی ہے۔
ویڈیو ڈبنگ: ویڈیو میں موجود شخص کی ہونٹوں کی حرکات تبدیل کریں، جبکہ اصل سر کی حرکات اور ٹائمنگ برقرار رہے؛ یہ کثیر لسانی ڈبنگ کے لیے موزوں ہے۔
گفتگو کرنے والا ڈیجیٹل انسان: بڑے ماڈل اور اسپیچ ریکگنیشن و سنتھیسس سے منسلک کر کے ریئل ٹائم گفتگو کرنے والا ڈیجیٹل اوتار بنایا جا سکتا ہے۔
اسٹائلائزڈ ڈرائیونگ: اسکیچ، آئل پینٹنگ، اینیمے اور 3D کرداروں جیسے غیر حقیقی انسانی انداز کے پورٹریٹس کو بھی متحرک کرنے کی سہولت ہے۔
03TalkLikeYou کا تکنیکی اصول
WeChat پر فالو کریں اور “开源” کا جواب بھیج کر AI اوپن سورس پروجیکٹ گروپ میں شامل ہوں
موشن اسپیس ماڈلنگ: پکسل اسپیس میں براہِ راست تصویر بنانے کے بجائے TalkLikeYou پہلے تصویر کو موشن پیرامیٹرز میں تبدیل کرتا ہے، پھر اس ہلکے ڈیجیٹل نمائندگی میں بولنے کی حرکات سیکھ کر تیار کرتا ہے، اور رینڈرر کے ذریعے انہیں دوبارہ ویڈیو میں تبدیل کرتا ہے۔ اس طرح رفتار اور شناخت کا استحکام دونوں برقرار رہتے ہیں۔
ون-اسٹیپ Flow Matching سیمپلنگ: Flow Matching کے ذریعے شور سے ہدف تک سیدھا راستہ سیکھا جاتا ہے، جبکہ ری پیرامیٹرائزیشن کے ساتھ صاف موشن سیکوئنس کی براہِ راست پیش گوئی کی جاتی ہے۔ ون-اسٹیپ سیمپلنگ تقریباً 50 مراحل کے برابر لپ سنک معیار حاصل کر سکتی ہے اور 32.43 FPS کی ریئل ٹائم رفتار فراہم کرتی ہے۔
متحدہ ہیبٹ اسپیس: ایک قابلِ انٹرپولیشن کم جہتی ہیبٹ ویکٹر اسپیس بنائی جاتی ہے، جس میں ڈیٹاسیٹ کے حقیقی افراد کی ہونٹوں کی حرکات کے اعدادوشمار کو one-hot انکوڈنگ میں سکیڑا جاتا ہے۔ حوالہ جاتی ویڈیو کو ہیبٹ ایکسٹریکٹر کے ذریعے اسی اسپیس میں انکوڈ کیا جاتا ہے، اس لیے دونوں طریقوں کے درمیان آزادانہ تبدیلی یا انٹرپولیشن ممکن ہے۔
دو مرحلوں کی تربیتی حکمتِ عملی: پہلے 380 افراد پر مشتمل HDTF پر one-hot انکوڈنگ کے ذریعے یہ سکھایا جاتا ہے کہ ”ہیبت کیا ہے“، پھر عمومی صلاحیت کے لیے بڑے CelebV-HQ پر حوالہ جاتی ویڈیوز کے ذریعے تربیت دی جاتی ہے۔ بھولنے سے بچانے کے لیے one-hot ڈیٹا کو وقفے وقفے سے دوبارہ شامل کیا جاتا ہے، جس سے ہیبٹ مماثلت 0.33 سے بڑھ کر 0.64 ہو جاتی ہے۔
PLAD تشخیصی پیمانہ: ہونٹوں کی حرکات کو منہ کھولنے کی وسعت، ہونٹوں کے سکڑنے اور ہونٹوں کے پھیلنے کے تین صوتی محوروں پر پروجیکٹ کیا جاتا ہے، پھر تقسیم کے ہسٹوگرام کے ذریعے حوالہ شخص سے مماثلت کا موازنہ کیا جاتا ہے۔ یوں پہلی بار ”بولنے کا انداز کتنا ملتا ہے“ کے لیے مقداری معیار فراہم کیا گیا ہے۔
04TalkLikeYou کا استعمال کیسے کریں؟
ماحول کی تیاری: Linux سسٹم استعمال کریں، Python 3.10 + CUDA 12.1 + FFmpeg انسٹال کریں، اور یقینی بنائیں کہ NVIDIA GPU کی ویڈیو میموری کم از کم 12GB ہو۔
کوڈ ڈاؤن لوڈ کریں: GitHub سے TalkLikeYou کی مرکزی ریپوزٹری کلون کریں۔
انحصارات انسٹال کریں: conda env create -f environment.yaml چلا کر ماحول بنائیں اور اسے فعال کریں، یا CUDA ورژن والا PyTorch خود انسٹال کر کے pip install -r requirements.txt چلائیں۔
وزن ڈاؤن لوڈ کریں: Hugging Face کمانڈ hf download doubi-killer/TalkLikeYou کے ذریعے ماڈل وزن ریپوزٹری کے روٹ ڈائریکٹری میں ڈاؤن لوڈ کریں۔
مواد تیار کریں: ایک پورٹریٹ تصویر (یا ویڈیو) اور ایک آڈیو کلپ تیار کریں؛ ان پٹ ویڈیو 25 FPS کی ہونی چاہیے۔
انفرنس چلائیں: python -m talklikeyou --source تصویر --audio آڈیو --person-id 192 --sampling-steps 1 چلا کر ویڈیو تیار کریں؛ --person-id تبدیل کرنے سے بولنے کا انداز بھی تبدیل ہو جائے گا۔
اپنا انداز بنائیں: --person-id کی جگہ --habit-reference استعمال کریں اور کم از کم 100 فریم کی حوالہ جاتی ویڈیو کی طرف اشارہ کریں، تاکہ اس ویڈیو میں موجود شخص کے بولنے کے انداز کی نقل کی جا سکے۔
ویڈیو ڈبنگ: --source کو ویڈیو فائل کی طرف اشارہ کریں اور --pose-mode source شامل کریں؛ اس سے صرف ہونٹوں کی حرکات تبدیل ہوں گی اور اصل سر کی حرکات برقرار رہیں گی۔
05TalkLikeYou کے بنیادی فوائد
بولنے کے انداز کی خصوصی نقل: صنعت کا پہلا اوپن سورس فریم ورک جو ذاتی ہونٹوں کے بولنے کے انداز کو بنیادی عنصر کے طور پر ماڈل کرتا ہے۔ انداز کو نمبر یا ویڈیو کے ذریعے متعین کیا جا سکتا ہے، جس سے ”سب کے لیے ایک جیسا“ اوسط ہونٹوں کا انداز ختم ہوتا ہے۔
تیز ریئل ٹائم رفتار: ون-اسٹیپ Flow Matching سیمپلنگ سے 32.43 FPS حاصل ہوتے ہیں، جو امیج ڈفیوژن طریقے Sonic سے تقریباً سو گنا تیز ہے، جبکہ ایک RTX 3090 پر ویڈیو میموری کا استعمال 4GB سے کم رہتا ہے۔
بہتر معیار اور ہم آہنگی: FID 7.71 دوسرے نمبر والے نتیجے کے ایک تہائی سے بھی کم ہے، جبکہ Sync-C 8.73 سب سے زیادہ ہے؛ یوں ہونٹوں کی ہم آہنگی اور تصویر کا معیار دونوں برقرار رہتے ہیں۔
ہیبت مماثلت میں برتری: PLAD پر ہیبٹ مماثلت 0.62 ہے، جو MimicTalk (0.48) اور PC-Talk (0.39) جیسے دیگر ماڈلز سے نمایاں طور پر زیادہ ہے۔
دو لچکدار طریقہ ہائے تخصیص: سرکاری پیش سیٹ نمبروں کے ذریعے بغیر اضافی لاگت کے انداز تبدیل کریں، یا کسی بھی حوالہ جاتی ویڈیو سے فوراً انداز سیکھیں؛ نئے انداز بنانے کے لیے انٹرپولیشن بھی ممکن ہے۔
06TalkLikeYou کا پروجیکٹ لنک
پروجیکٹ ویب سائٹ: https://bq-wang0511.github.io/TalkLikeYou/
GitHub ریپوزٹری: https://github.com/BQ-Wang0511/TalkLikeYou
HuggingFace ماڈل ریپوزٹری: https://huggingface.co/doubi-killer/TalkLikeYou
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2610.06658
07TalkLikeYou کے استعمال کے منظرنامے
ورچوئل اسٹریمر / لائیو کامرس: ذاتی بولنے کے انداز والا ورچوئل اسٹریمر کم لاگت میں تیار کریں؛ 4GB ویڈیو میموری پر مقامی ریئل ٹائم اجرا ممکن ہے اور حقیقی شخص کے سامنے آنے کی ضرورت نہیں۔
کثیر لسانی ویڈیو ڈبنگ: ویڈیو میں موجود شخص کی ہونٹوں کی حرکات تبدیل کریں اور اصل سر کی حرکات و ٹائمنگ برقرار رکھیں، تاکہ ترجمہ شدہ فلموں یا بیرونِ ملک مواد میں ہونٹوں کی حرکات ہدف زبان سے قدرتی طور پر مطابقت رکھیں۔
ڈیجیٹل اوتار / ورچوئل کسٹمر سروس: بڑے ماڈل اور اسپیچ سنتھیسس کو ملا کر ریئل ٹائم گفتگو کرنے والا اوتار بنائیں، جو آن لائن کسٹمر سروس، اسمارٹ گائیڈ اور دیگر ”آمنے سامنے“ تعامل والے منظرناموں میں استعمال ہو سکے۔
ذاتی تعلیم / تربیت: اساتذہ یا ٹرینرز کے لیے مخصوص ڈیجیٹل کردار بنائیں، ان کے منفرد بولنے کے انداز کی نقل کریں، اور اسے کورس ریکارڈنگ یا فاصلاتی تعلیم میں استعمال کریں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0