
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-09
01Mellum2.1 کیا ہے
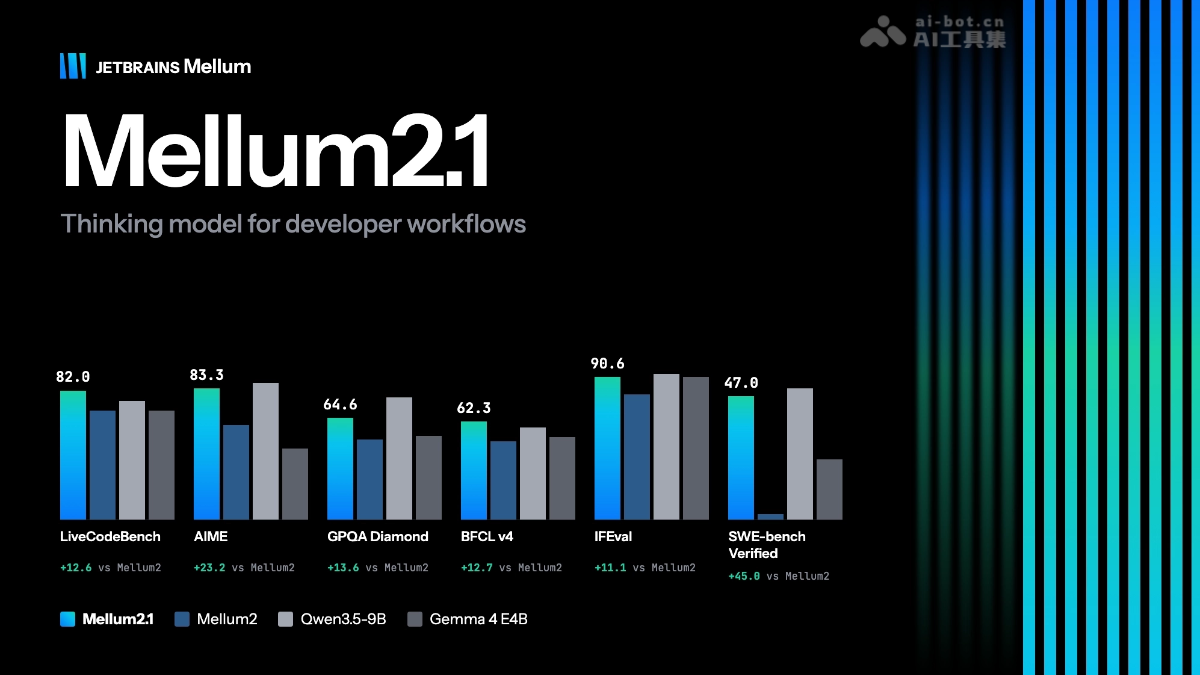
Mellum2.1، JetBrains کا پیش کردہ اوپن سورس AI پروگرامنگ ماڈل ہے، جو 12B مکسڈ ایکسپرٹ آرکیٹیکچر استعمال کرتا ہے۔ Mellum2.1 میں Reinforcement Learning تربیت کے آخری مرحلے سے بڑھ کر تربیت کا بنیادی حصہ بن گئی ہے۔ لاکھوں سینڈ باکس رنز کے امتزاج سے ماڈل کوڈ بیس کو دریافت، فائلوں میں ترمیم اور اپنی تبدیلیوں کی جانچ کر سکتا ہے، جس سے ایجنٹ کی پروگرامنگ صلاحیت میں نمایاں اضافہ ہوتا ہے۔ Mellum2.1 کا زیادہ بوجھ کے دوران تھروپٹ Qwen3.5-9B کے تقریباً دو گنا کے قریب ہے، یہ نجی تعیناتی کو سپورٹ کرتا ہے اور Hugging Face پر دستیاب ہے۔
02Mellum2.1 کے اہم فیچرز
ایجنٹ پروگرامنگ: کوڈ بیس کو دریافت، فائلوں میں ترمیم اور اپنی تبدیلیوں کی جانچ کر سکتا ہے، ناکام ٹیسٹس کی بنیادی وجہ تلاش کر سکتا ہے، اور اصلاحی حل تیار کرکے ان کی تصدیق کر سکتا ہے۔
کوڈ کی تکمیل اور تخلیق: Mellum2 کی سمت کو برقرار رکھتے ہوئے، کوڈنگ ورک فلو کے لیے تیز رفتار کوڈ جنریشن اور سوال و جواب کی صلاحیت فراہم کرتا ہے۔
ٹول کالنگ: کام مکمل کرنے کے لیے بیرونی ٹولز کو طلب کر سکتا ہے، جو AI ایجنٹ سسٹمز بنانے کے لیے موزوں ہے۔
عمومی استدلال: روزمرہ کے سوالات سنبھال سکتا ہے اور ریاضی و منطقی مسائل کو مرحلہ وار حل کرسکتا ہے۔
نجی تعیناتی: مقامی یا اپنی بنیادی سہولت پر چلایا جا سکتا ہے، جبکہ کوڈ اور ڈیٹا مکمل طور پر ادارے کے اندر محفوظ رہتے ہیں۔
03Mellum2.1 کے تکنیکی اصول
WeChat پر فالو کریں اور “开源” کا جواب بھیج کر AI اوپن سورس پروجیکٹ گروپ میں شامل ہوں
مکسڈ ایکسپرٹ (MoE) آرکیٹیکچر: Mellum2.1، 12B پیرامیٹرز والا مکسڈ ایکسپرٹ آرکیٹیکچر استعمال کرتا ہے، جس میں ہر بار استدلال کے دوران صرف 2.5B پیرامیٹرز فعال ہوتے ہیں۔ ماڈل متعدد ”ماہر“ ذیلی نیٹ ورکس پر مشتمل ہے۔ روٹنگ میکانزم کے ذریعے ان پٹ کو صرف چند ماہرین تک بھیجا جاتا ہے، جس سے ماڈل کی گنجائش برقرار رکھتے ہوئے حسابی بوجھ نمایاں طور پر کم ہوتا ہے اور کم لاگت پر زیادہ تھروپٹ والا استدلال ممکن ہوتا ہے۔
بڑے پیمانے کی Reinforcement Learning (RL): اس ورژن کی بنیادی بہتری تربیتی عمل میں ہے: RL کو پری ٹریننگ کے بعد کے مختصر اختتامی مرحلے سے بڑھا کر تربیت کا مرکزی حصہ بنا دیا گیا ہے۔ ٹیم نے ریاضی، مسابلاتی پروگرامنگ، سائنس، ٹول کے استعمال اور سافٹ ویئر انجینئرنگ جیسے کام شامل کیے۔ اپنی بنائی ہوئی بنیادی سہولت نے تربیت کے دوران لاکھوں سینڈ باکسز شروع کیے، جو ہزاروں حقیقی ماحول پر محیط تھے، تاکہ ماڈل حقیقی کوڈنگ منظرناموں کے ساتھ تعامل کے دوران آزمائش، غلطی اور انعامی سگنلز کے ذریعے ایجنٹ کے لیے ضروری دریافت، ترمیم اور تصدیق کی صلاحیتیں سیکھ سکے۔
ڈیٹا کی سخت چھان بین: تربیت میں استعمال ہونے والے تمام اوپن ڈیٹا سیٹس کو ذخیرے میں شامل کرنے سے پہلے فلٹر کیا گیا۔ ایسے کام نکال دیے گئے جن میں ٹیسٹ کی خامیاں، ناقابلِ تصدیق جوابات یا ناموزوں دشواری موجود تھی، تاکہ RL کے تربیتی سگنلز قابلِ اعتماد رہیں اور ماڈل غلط فیڈبیک سے سیکھنے سے بچے۔
ملٹی ٹوکن پیش گوئی (MTP): MTP ماڈل کو ایک ہی فارورڈ پاس میں متعدد آئندہ Tokens کی پیش گوئی کرنے دیتا ہے۔ واحد درخواست کے منظرنامے میں رفتار تقریباً 1.6 گنا بڑھ جاتی ہے۔ MoE کے کم فعال پیرامیٹرز والے ڈیزائن کے ساتھ مل کر Mellum2.1 کا زیادہ بوجھ کے دوران تھروپٹ Qwen3.5-9B کے تقریباً دو گنا کے قریب پہنچ جاتا ہے۔
04Mellum2.1 کا استعمال کیسے کریں
ماڈل کا صفحہ کھولیں: Hugging Face پر JetBrains کی سرکاری تنظیم کا صفحہ کھولیں اور Mellum2.1 ماڈل ریپوزٹری تلاش کریں۔
ماڈل کے وزن ڈاؤن لوڈ کریں: ماڈل کارڈ کے صفحے پر ڈاؤن لوڈ پر کلک کریں یا لائسنس کی شرائط کے مطابق ماڈل فائلیں حاصل کریں (اگر کوئی شرط ہو تو پہلے استعمال کے معاہدے سے اتفاق کریں)۔
تعیناتی کا فریم ورک منتخب کریں: تعیناتی کے لیے Transformers یا vLLM استعمال کریں؛ پہلا سادہ تصدیق کے لیے اور دوسرا پروڈکشن سطح کی زیادہ ہم وقتی سروس کے لیے موزوں ہے۔
استدلال کا ماحول تشکیل دیں: GPU ماحول تیار کریں (سرکاری بینچ مارک ایک H200 پر مبنی ہے)، ماڈل لوڈ کریں اور 131K کانٹیکسٹ پیرامیٹر سیٹ کریں۔
تیز رفتاری کے اختیارات فعال کریں: واحد درخواست کی رفتار تقریباً 1.6 گنا بڑھانے کے لیے سرکاری ہدایات کے مطابق ملٹی ٹوکن پیش گوئی (MTP) تشکیل دیں۔
استدلال کی کال بھیجیں: API کے ذریعے کوڈ جنریشن، ریپوزٹری سطح کی ترمیم یا ایجنٹ کے کام کے پرامپٹس بھیجیں اور ماڈل کا آؤٹ پٹ حاصل کریں۔
05Mellum2.1 کے بنیادی فوائد
نمایاں ایجنٹ پروگرامنگ صلاحیت: حقیقی ماحول میں بڑے پیمانے کی RL تربیت کے ذریعے یہ خودکار طور پر کوڈ بیس دریافت، فائلوں میں ترمیم اور تبدیلیوں کی تصدیق کر سکتا ہے، ٹیسٹ کی ناکامی کی بنیادی وجہ تلاش کر سکتا ہے اور اصلاحی حل تیار کر سکتا ہے۔
استدلال کی رفتار میں نمایاں: زیادہ بوجھ کے دوران تھروپٹ Qwen3.5-9B کے تقریباً دو گنا کے قریب ہے، جو اسی سطح کے ماڈلز میں تیز ترین ہے۔
واحد درخواست کا فوری جواب: ملٹی ٹوکن پیش گوئی (MTP) ٹیکنالوجی واحد درخواست کی رفتار تقریباً 1.6 گنا بڑھاتی ہے۔
موثر آرکیٹیکچر: 12B MoE ڈیزائن میں صرف 2.5B پیرامیٹرز فعال ہوتے ہیں، جس سے کم کمپیوٹنگ لاگت پر اعلیٰ کارکردگی حاصل ہوتی ہے۔
اعلیٰ معیار کا تربیتی ڈیٹا: تمام تربیتی ڈیٹا کی سخت چھان بین کی جاتی ہے اور ناقص کام نکال دیے جاتے ہیں، تاکہ سیکھنے کے سگنلز قابلِ اعتماد رہیں۔
جامع صلاحیتیں: پروگرامنگ، مسابلاتی پروگرامنگ، ریاضی، ٹول کالنگ اور عمومی معلومات سمیت مختلف شعبوں میں مجموعی بہتری۔
نجی تعیناتی کے لیے موزوں: مقامی یا اپنی بنیادی سہولت پر چلایا جا سکتا ہے، کوڈ اور ڈیٹا پر مکمل خودمختار کنٹرول برقرار رہتا ہے، اور یہ اداروں کے حساس منظرناموں کے لیے موزوں ہے۔
06Mellum2.1 کا پروجیکٹ ایڈریس
پروجیکٹ کی ویب سائٹ: https://blog.jetbrains.com/ai/2026/10/mellum2-1-gets-to-work-a-fast-open-model-for-coding-agents/
HuggingFace ماڈل لائبریری: https://huggingface.co/JetBrains/Mellum2.1-12B-A2.5B-Thinking
07Mellum2.1 کے استعمال کے منظرنامے
ایجنٹ پروگرامنگ: کوڈ بیس کو خودکار طور پر دریافت، فائلوں میں ترمیم اور تبدیلیوں کی تصدیق، ٹیسٹ کی ناکامی تلاش کرنے سے لے کر اصلاح تک مکمل عمل انجام دینا۔
اداروں کے لیے نجی معاون: ادارے کے سرورز پر مقامی تعیناتی، تاکہ کوڈ اور ڈیٹا اندرونی نیٹ ورک سے باہر نہ جائیں۔
IDE کے ساتھ گہرا انضمام: JetBrains کے IDEs یا فریقِ ثالث کے ٹولز میں انضمام کے ذریعے کوڈ کی تکمیل اور ذہین سوال و جواب فراہم کرنا۔
ذیلی ایجنٹ کی فراہمی: کم تاخیر اور زیادہ تھروپٹ کی خصوصیات کے ذریعے کثیر ایجنٹ سسٹمز میں ذیلی کام انجام دینا یا درخواستوں کی روٹنگ کرنا۔
ریاضی و منطقی استدلال: ریاضی کے مسائل، الگورتھم مقابلوں اور روزمرہ کے سوالات کو سنبھالنا، جبکہ عمومی معاون کی صلاحیت بھی برقرار رکھنا۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0