
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-09
01Naive-N0.5-Flash کیا ہے؟
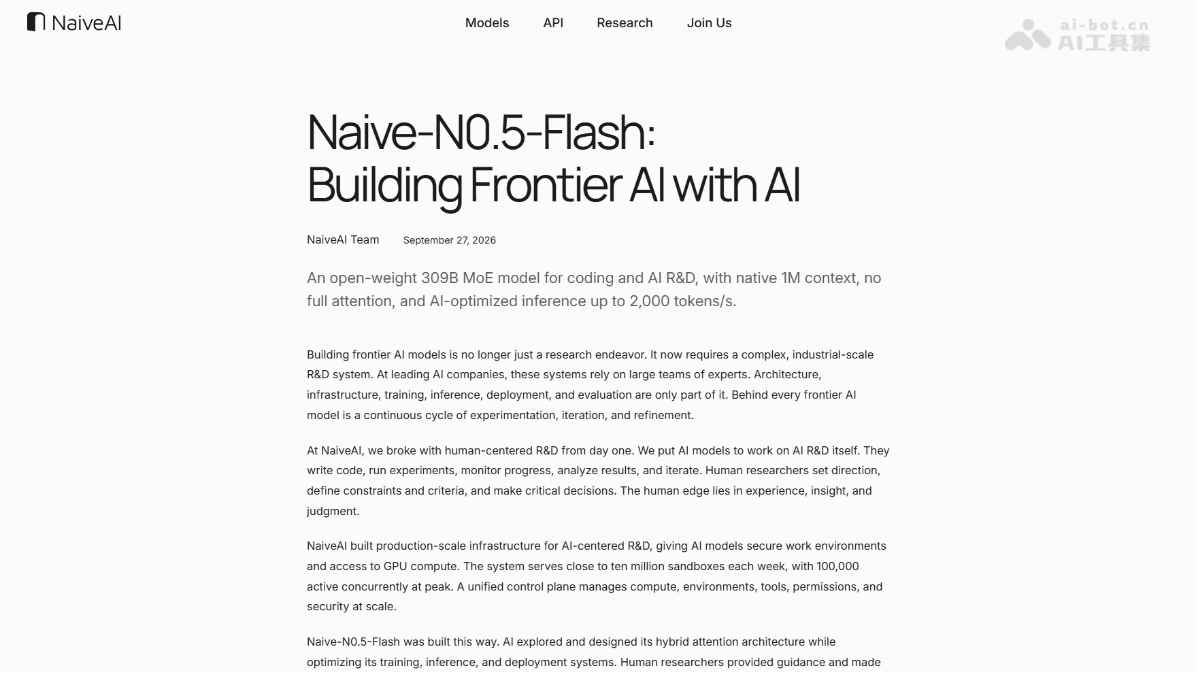
Naive-N0.5-Flash، NaiveAI کی جانب سے اوپن سورس کیا جانے والا پہلا MoE بڑا ماڈل ہے، جس کا مقصد پروگرامنگ اور AI تحقیق و ترقی کے منظرنامے ہیں۔ Naive-N0.5-Flash کو Xiaomi کے MiMo-V2.5 بنیادی ماڈل کی بنیاد پر تیار کیا گیا ہے، یہ 309B MoE معماری رکھتا ہے، SWA+DSA مخلوط sparse attention استعمال کرتا ہے، مقامی طور پر 1M context کو سپورٹ کرتا ہے اور اس میں کوئی full-attention layer نہیں۔ ماڈل کی تحقیق و ترقی میں AI نے گہری شرکت کی ہے، جبکہ اس کے معاون inference system NaiveRT کی single-stream decoding کی زیادہ سے زیادہ رفتار 2122 tokens/s تک پہنچتی ہے۔
02Naive-N0.5-Flash کے اہم افعال
طویل context پروگرامنگ: مقامی طور پر 1M token context کو سپورٹ کرتا ہے، جس سے انتہائی طویل code repositories اور طویل مدتی software engineering tasks کو سنبھالا جا سکتا ہے۔
AI تحقیق و ترقی میں معاونت: تحقیقی مقالے پڑھ سکتا ہے، طریقوں کو دوبارہ نافذ کر سکتا ہے، تجربات چلا سکتا ہے، نتائج کا تجزیہ کر سکتا ہے اور ماڈل تحقیق و ترقی کے پورے عمل میں براہ راست حصہ لے سکتا ہے۔
Inference acceleration: معاون NaiveRT inference system کے ذریعے standard mode میں 50 tokens/s اور تیز رفتار mode میں single-stream decoding کی زیادہ سے زیادہ رفتار 2,122 tokens/s تک پہنچتی ہے۔
خودمختار تحقیق: ہدف، computing budget اور evaluation protocol دیے جانے کے بعد end-to-end خودمختار طور پر تحقیق آگے بڑھا سکتا ہے۔
03Naive-N0.5-Flash کے تکنیکی اصول
WeChat پر فالو کریں اور “اوپن سورس” کا جواب دے کر AI اوپن سورس منصوبوں کے گروپ میں شامل ہوں
SWA–DSA مخلوط sparse attention: ماڈل MiMo-V2.5 بنیادی ماڈل پر مبنی ہے۔ اس میں زیادہ خرچ والی global attention layers کو DeepSeek sparse attention سے تبدیل کیا گیا ہے، اور اسے sliding-window attention کے ساتھ 5:1 کے تناسب سے باری باری stack کیا گیا ہے۔ پورے network میں کوئی full-attention layer نہیں۔ SWA، 128 token کی مقامی window کو handle کرتا ہے، جبکہ DSA کا ہلکا پھلکا indexer پوری سابقہ history کو score کر کے main computation کے لیے top-2048 tokens منتخب کرتا ہے۔
ہلکے indexer کا ڈیزائن: DSA میں موجود MLA کو GQA میں تبدیل کیا گیا، اور indexer query heads کی تعداد 64 سے کم کر کے 16 کر دی گئی، جس سے index selection path کا وقت 44% کم ہوا، جبکہ 1M context والے Agent tasks میں کارکردگی برقرار رہی۔
تین مرحلوں پر مشتمل training process: پہلے 50B tokens پر backbone کو freeze کر کے KL divergence loss کے ذریعے indexer اور full-attention distribution کو align کیا جاتا ہے؛ پھر sparse attention پر منتقل ہو کر 3T tokens کی continued pre-training کی جاتی ہے، تاکہ نئے information selection mechanism کے مطابق ڈھالا جا سکے اور programming و تحقیق و ترقی کی صلاحیتیں مضبوط ہوں؛ آخر میں 200B tokens پر supervised fine-tuning کی جاتی ہے اور learning rate کم کیا جاتا ہے۔ پورے عمل میں 1M context برقرار رکھا جاتا ہے، جبکہ AI خودکار طور پر top-k retrieval analysis اور numerical stability fixes مکمل کرتا ہے۔
مخلوط sequence parallelism اور memory optimization: SWA کو صرف local window درکار ہونے اور DSA کو پوری history درکار ہونے کے فرق کے لیے بالترتیب Halo sequence parallelism استعمال کیا جاتا ہے؛ memory کے حوالے سے activation offloading کو operator level تک باریک کیا گیا ہے، اور top-k indices کو واضح طور پر محفوظ رکھا جاتا ہے تاکہ دوبارہ computation سے selection تبدیل نہ ہو۔ 512 GPUs پر تقریباً 4 دن میں 1T tokens کی training کی جا سکتی ہے۔
NaiveRT inference optimization: بڑے پیمانے پر operator fusion، PDL کے ذریعے upstream اور downstream kernels کی overlapping execution، اور speculative decoding loop کو مکمل طور پر GPU پر چلانے سے single-round decoding latency 12.3ms سے کم ہو کر 3.4ms رہ جاتی ہے؛ یہ random seed کے مطابق bit-by-bit deterministic sampling بھی سپورٹ کرتا ہے، جس سے RL training میں sampling اور training logprob کے درمیان مطابقت یقینی بنتی ہے۔ تمام optimizations کے لیے end-to-end حقیقی model path کو معیار بنایا گیا ہے۔
04Naive-N0.5-Flash کا استعمال کیسے کریں
Hardware کی تصدیق کریں: FP8 کو سپورٹ کرنے والا NVIDIA GPU درکار ہے۔ ماڈل weights تقریباً 315GB ہیں، اس لیے اضافی GPU memory مختص کریں۔
Weights حاصل کریں: Hugging Face سے NaiveAI/Naive-N0.5-Flash-FP8 repository حاصل کریں۔
Dependencies انسٹال کریں: pip install "transformers[torch,kernels]>=5.17.0" چلائیں۔
ماڈل load کریں: AutoTokenizer اور AutoModelForCausalLM کو trust_remote_code=True اور device_map="auto" کے ساتھ load کریں۔
Input تیار کریں: apply_chat_template کے ذریعے conversation messages منتقل کر کے input tensors تیار کریں۔
نتائج تیار کریں: جواب بنانے کے لیے model.generate() کال کریں، پھر output decode کرنے کے لیے tokenizer.decode() استعمال کریں۔
Parameters مقرر کریں: عمومی استعمال کے لیے temperature=1.0 اور top_p=0.95 تجویز کیے جاتے ہیں۔
اعلیٰ کارکردگی والی inference کو دوبارہ چلائیں: 2,122 tokens/s کی رفتار درکار ہو تو NaiveRT کا اوپن سورس code، Docker Compose environment اور متعلقہ benchmark scripts حاصل کر کے خود deploy کریں۔
05Naive-N0.5-Flash کے بنیادی فوائد
انتہائی طویل context: مقامی طور پر 1M token context کو سپورٹ کرتا ہے، اور پورے network میں کوئی full-attention layer نہیں، اس لیے طویل sequence کی decoding کا خرچ روایتی معماریوں سے کہیں کم ہے۔
نمایاں inference speed: معاون NaiveRT system کی single-stream decoding کی زیادہ سے زیادہ رفتار 2,122 tokens/s ہے، جبکہ speculative decoding latency، SGLang کے مقابلے میں 72.4% کم ہے۔
نمایاں تحقیق و ترقی کی صلاحیت: PaperBench 63.2، MLE-bench-30 73.7%، NanoGPT SpeedRun 73.8s؛ متعدد AI تحقیق و ترقی کے benchmarks میں ہم پلہ ماڈلز سے بہتر کارکردگی۔
AI-native تحقیق و ترقی: ماڈل کی معماری کے ڈیزائن اور system optimization میں AI نے حصہ لیا ہے، جو انسانوں کے ہدف مقرر کرنے اور AI کے iteration انجام دینے والے “AI تحقیق کرتا ہے” paradigm کا عملی نفاذ ہے۔
خودمختار تحقیق کی صلاحیت: ہدف اور budget دیے جانے کے بعد end-to-end خودمختار طور پر تحقیق مکمل کر سکتا ہے، 400 گھنٹوں کی training میں AutoWM world model تیار کر کے WorldArena میں سرفہرست مقام حاصل کیا۔
06Naive-N0.5-Flash منصوبے کا پتہ
منصوبے کی سرکاری ویب سائٹ: https://naive.ai/en/research/
GitHub repository: https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
HuggingFace model repository: https://huggingface.co/NaiveAI/Naive-N0.5-Flash
07Naive-N0.5-Flash کے اطلاقی منظرنامے
AI تحقیق و ترقی کا معاون: محققین کو تحقیقی مقالے پڑھنے، طریقے دوبارہ نافذ کرنے، تجربات چلانے اور نتائج کا تجزیہ کرنے میں مدد دیتا ہے، مثلاً PaperBench اور MLE-bench جیسے تحقیق و ترقی کے tasks۔
طویل مدتی software engineering: مقامی 1M context کے ذریعے بڑی code repositories کو handle کرتا ہے، اور cross-file understanding، bug fixing اور repository-level code generation مکمل کرتا ہے۔
طویل context والے Agent tasks: terminal operations اور متعدد tool calls جیسے طویل interactive scenarios میں task history کو مکمل برقرار رکھتا ہے۔
RL training infrastructure: NaiveRT کی تیز single-stream decoding اور bit-by-bit deterministic sampling کے ساتھ طویل مدتی reinforcement learning rollout کو تیز کرتا ہے اور پیچھے رہ جانے والے samples کو کم کرتا ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0