
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-15
01DMAD کیا ہے
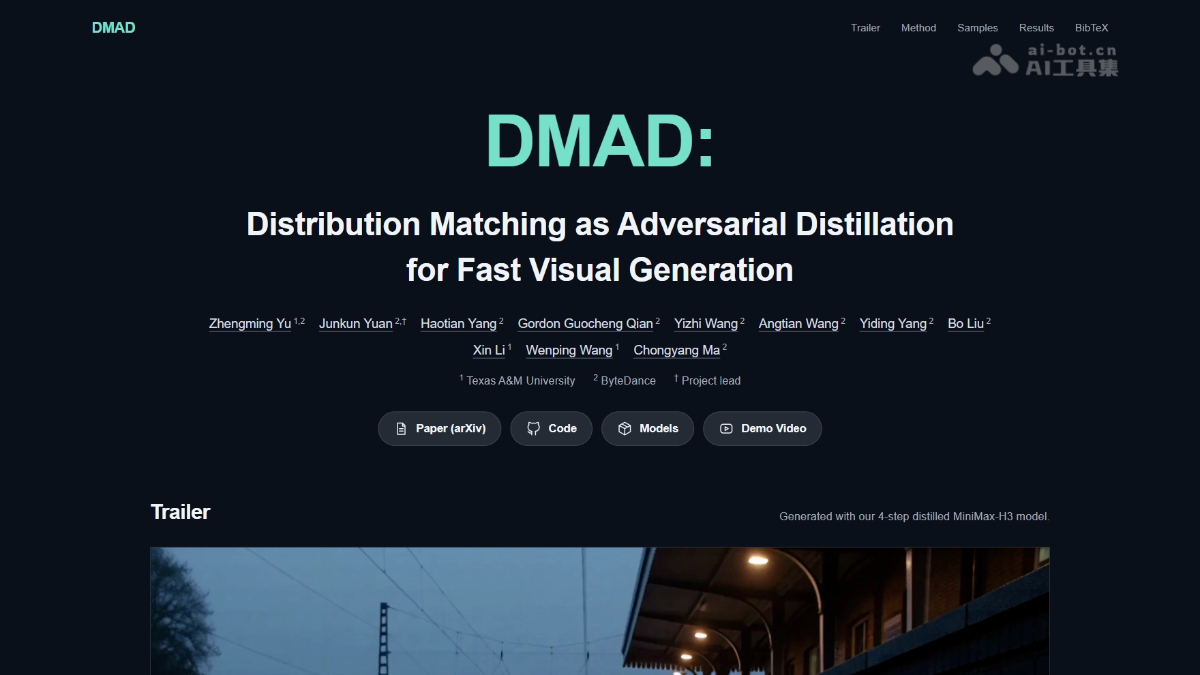
DMAD (Distribution Matching as Adversarial Distillation) بائٹ ڈانس اور ٹیکساس اے اینڈ ایم یونیورسٹی کی جانب سے مشترکہ طور پر جاری کردہ کم مراحل والی ڈسٹلیشن فریم ورک ہے، جو ڈفیوژن ماڈلز کی جنریشن کو تیز کرنے کے لیے استعمال ہوتا ہے۔ DMAD بائنری درجہ بند امتیاز کنندہ کو تربیت دیتا ہے تاکہ ہدف تقسیم اور طالب علم تقسیم کے فرق کو براہِ راست سیکھ سکے، معاون ڈفیوژن ماڈل کی ضرورت ختم ہو جائے، اور 50 مراحل والے استاد ماڈل کو 4 مراحل والے طالب علم ماڈل میں ڈسٹل کیا جا سکے۔ اب ImageNet، SDXL، Wan2.1 اور MiniMax-H3-33B کو سپورٹ کرتا ہے؛ 8GB ویڈیو میموری کے ساتھ تقریباً 5 سیکنڈ کی 1344×768 آواز والی ویڈیو تیار کی جا سکتی ہے۔
02DMAD کے اہم افعال
کم مراحل والی تصویری جنریشن: ImageNet-64 کے EDM ماڈل کو 1 مرحلے کے سیمپلنگ تک ڈسٹل کرتا ہے، FID کم از کم 1.04 تک پہنچتا ہے، جبکہ SDXL صرف 4 مراحل میں متن سے تصویر بنا سکتا ہے۔
کم مراحل والی متن سے ویڈیو جنریشن: Wan2.1-T2V-14B کو 4 مراحل والے طالب علم ماڈل میں ڈسٹل کرتا ہے، جس کا VBench اسکور 85.15 ہے۔
مشترکہ آڈیو ویڈیو جنریشن: MiniMax-H3-33B کے 50 مراحل والے استاد ماڈل کو 4 مراحل میں ڈسٹل کرتا ہے، اور 1344×768 ویڈیو کے ساتھ 32kHz مقامی سٹیریو آڈیو آؤٹ پٹ فراہم کرتا ہے۔
صارفین کے درجے کے ہارڈویئر کی معاونت: 8GB ویڈیو میموری کے لیے ComfyUI ورک فلو اور کم ویڈیو میموری والا کمانڈ لائن inference فراہم کرتا ہے؛ 8GB گرافکس کارڈ تقریباً 5 سیکنڈ، جبکہ 12GB کارڈ تقریباً 15 سیکنڈ کی آواز والی ویڈیو بنا سکتا ہے۔
تربیت اور inference مکمل طور پر اوپن سورس: ڈسٹلیشن طریقہ، تربیتی کوڈ، inference اسکرپٹس اور متعدد ماڈلز کے LoRA وزن جاری کیے گئے ہیں، جو کمانڈ لائن اور ComfyUI دونوں طریقوں کو سپورٹ کرتے ہیں۔
03DMAD کے تکنیکی اصول
WeChat پر فالو کریں اور “开源” کا جواب دے کر AI اوپن سورس پروجیکٹس کے گروپ میں شامل ہوں
تقسیم کی مماثلت بطور adversarial distillation: DMAD بائنری درجہ بند امتیاز کنندہ کو تربیت دیتا ہے تاکہ ہدف نمونوں اور طالب علم نمونوں میں فرق کر سکے۔ بہترین امتیاز کنندہ کا logit دونوں تقسیموں کے log density ratio کے برابر ہوتا ہے؛ اس کے input کے لحاظ سے gradient لینے سے score کا فرق حاصل ہوتا ہے، جو طالب علم کے لیے اصلاح کی سمت براہِ راست فراہم کرتا ہے اور معاون score fitting ماڈل کی ضرورت ختم کر دیتا ہے۔
مشترکہ backbone، دوہرا head امتیاز کنندہ: امتیاز کنندہ ایک مشترکہ feature backbone اور دو classification heads استعمال کرتا ہے۔ استاد head استاد نمونوں اور طالب علم نمونوں میں فرق کرتا ہے، جبکہ حقیقی ڈیٹا head حقیقی نمونوں اور طالب علم نمونوں میں فرق کرتا ہے؛ دونوں کو binary cross-entropy سے تربیت دی جاتی ہے۔ طالب علم کو دونوں logits کے weighted linear loss سے اپ ڈیٹ کیا جاتا ہے؛ اپ ڈیٹ کے دوران امتیاز کنندہ کے parameters منجمد رہتے ہیں، لیکن gradient backpropagation جاری رہتی ہے۔
شور کی حدود کے مطابق متحرک weighting: استاد نمونوں اور حقیقی ڈیٹا کی تقسیم کا فرق شور کی سطح کے ساتھ بدلتا ہے۔ DMAD حقیقی ڈیٹا head کے ذریعے دونوں اقسام کے نمونوں پر اوسط logit فرق کو تجرباتی signal کے طور پر استعمال کرتا ہے اور 0.99 decay والی exponential moving average سے ہر noise interval کو track کرتا ہے۔ کم فرق والے intervals کو زیادہ teacher weight ملتا ہے، جسے normalize کرنے کے بعد طالب علم کے loss میں شامل کیا جاتا ہے۔
آف لائن استاد نمونوں سے تربیت میں تیزی: استاد صرف پہلے سے تیار اور cache کیے گئے نمونے فراہم کرتا ہے، اس لیے تربیت کے دوران استاد کو آن لائن کال کرنے کی ضرورت نہیں ہوتی۔ 4 H200 GPUs اور MiniMax-H3 rank-128 LoRA configuration میں، ہر student update اور متعلقہ discriminator update کا وقت 818.1 سیکنڈ سے کم ہو کر 233.3 سیکنڈ رہ جاتا ہے، جس سے تقریباً 3.51 گنا تربیتی رفتار حاصل ہوتی ہے۔
04DMAD کا استعمال کیسے کریں
repository clone کریں: git clone https://github.com/Yzmblog/DMAD.git چلائیں اور project directory میں داخل ہوں۔
ماحول بنائیں: conda کے ذریعے Python 3.12 environment بنائیں اور اسے activate کریں۔
dependencies انسٹال کریں: official fixed versions کے مطابق PyTorch 2.11.0 (cu126)، torchvision اور torchaudio انسٹال کریں، پھر pip install -r requirements.txt اور pip install -U modelscope-hub چلائیں۔
ہارڈویئر تیار کریں: یقینی بنائیں کہ CUDA سپورٹ کرنے والا NVIDIA graphics card موجود ہے، اور تقریباً 64GB system memory اور 170GB disk space مختص کریں۔
بنیادی ماڈل ڈاؤن لوڈ کریں: modelscope download MiniMax/MiniMax-H3 کے ذریعے MiniMax-H3 بنیادی ماڈل ڈاؤن لوڈ کریں۔
ڈسٹلیشن weights ڈاؤن لوڈ کریں: ModelScope سے DMAD کا 4-step LoRA ڈاؤن لوڈ کریں۔
کمانڈ لائن inference: inference.py چلائیں اور model path، LoRA، prompt file، --steps 4، --height 768 --width 1344 مقرر کریں؛ ویڈیو میموری کے مطابق --low-vram 8 یا --low-vram 12 منتخب کریں۔
آؤٹ پٹ دیکھیں: output directory میں 0000.mp4، prompt txt اور settings.json شامل ہوں گے؛ کامیاب execution کے بعد اپنی prompt file استعمال کی جا سکتی ہے۔
05DMAD کے بنیادی فوائد
inference میں نمایاں تیزی: 50 مراحل والے استاد ماڈل کو 4 مراحل والے طالب علم ماڈل میں ڈسٹل کرتا ہے، جس سے denoising iterations میں 92% سے زیادہ کمی آتی ہے، جبکہ جنریشن کا معیار استاد ماڈل کے قریب رہتا ہے۔
زیادہ مؤثر تربیت: امتیاز کنندہ تقسیم کے فرق کو براہِ راست سیکھتا ہے، معاون ڈفیوژن ماڈل کی ضرورت ختم ہو جاتی ہے، اور 4 H200 GPUs پر training updates تقریباً 3.51 گنا تیز ہو جاتے ہیں۔
بہتر جنریشن معیار: ImageNet-64 پر one-step generation کا FID 1.04 ہے، جو DMD2، SiDA اور دیگر طریقوں سے بہتر ہے؛ انسانی جائزے میں DMD2 کے مقابل مجموعی ترجیحی شرح 79.1% اور rCM کے مقابل 84.6% رہی۔
تمام multimodal منظرناموں کی معاونت: ایک ہی فریم ورک تصویر، متن سے ویڈیو اور مشترکہ آڈیو ویڈیو جنریشن کو یکجا طور پر سپورٹ کرتا ہے۔
06DMAD کا پروجیکٹ پتہ
پروجیکٹ کی official website: https://yzmblog.github.io/projects/DMAD/
GitHub repository: https://github.com/Yzmblog/DMAD
HuggingFace model repository: https://huggingface.co/ZhengmingYu/DMAD
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2610.02188
07DMAD کے استعمال کے منظرنامے
مختصر ویڈیو مواد کی تخلیق: 4 مراحل میں مقامی آڈیو کے ساتھ 5–15 سیکنڈ کی ویڈیو تیار کریں۔ تخلیق کار 8GB کے صارفین کے درجے کے graphics card پر سوشل میڈیا مواد تیزی سے بنا سکتے ہیں، جس سے تیاری کی لاگت نمایاں طور پر کم ہوتی ہے۔
اشتہاری اور marketing مواد کی جنریشن: برانڈز prompts کی بنیاد پر مصنوعات کی نمائش اور منظرناموں پر مبنی ویڈیوز بڑی تعداد میں تیار کر سکتے ہیں۔ اعلیٰ معیار کے آڈیو آؤٹ پٹ کے ساتھ اشتہاری مواد کے تصور سے تیار شدہ پروڈکٹ تک کا وقت کم ہو جاتا ہے۔
فلمی preview اور concept design (Previs): directors اور art teams کم مراحل والی distillation کے ذریعے shot previews، ماحول کے references اور storyboard drafts تیزی سے تیار کر سکتے ہیں، جس سے ابتدائی تخلیقی iteration تیز ہوتی ہے۔
گیم اور animation assets کی تیاری: character animations، scene concept images اور dynamic background assets تیار کیے جا سکتے ہیں، جو indie game studios اور چھوٹی animation teams کو assets کی پیداواری لاگت کم کرنے میں مدد دیتے ہیں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0