
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-09-17
01Spark-Audio-1.0-Preview کیا ہے؟
Spark-Audio-1.0-Preview科大讯飞 کی جانب سے پیش کیا گیا مکمل طور پر چینی ٹیکنالوجی پر مبنی بنیادی صوتی بڑا ماڈل ہے، جو 0.65B آڈیو انکوڈر اور 30B-A3B MoE لینگویج ماڈل آرکیٹیکچر استعمال کرتا ہے اور 1300万 گھنٹوں کے آڈیو اور بڑی مقدار میں متنی ڈیٹا کے ذریعے مکمل طور پر چینی کمپیوٹنگ وسائل پر تربیت یافتہ ہے۔ یہ ماڈل آواز میں موجود معنی، جذبات اور منظرنامے کو براہِ راست سمجھ سکتا ہے، 99 زبانوں اور 202 بولیوں کی شناخت کے ساتھ صوتی تحریر، ترجمہ، مقرر کی شناخت، جذباتی تجزیہ، آڈیو سوال و جواب سمیت متعدد کاموں کی معاونت کرتا ہے۔ بلند شور، کم آواز اور دیگر پیچیدہ حالات میں اس کی کارکردگی نمایاں ہے، اور اسے کسٹمر سروس، گاڑیوں، طب سمیت متعدد شعبوں میں وسیع پیمانے پر استعمال کیا جا سکتا ہے۔
02Spark-Audio-1.0-Preview کے اہم افعال
صوتی تحریر: آواز کو براہِ راست متن میں تبدیل کرتا ہے اور 99 زبانوں اور 202 بولیوں کی شناخت کی معاونت کرتا ہے۔
کثیر لسانی ترجمہ: آواز سے آواز یا متن میں بین اللسانی ترجمہ کرتا ہے اور لہجے، اتار چڑھاؤ سمیت صوتی آہنگ کی معلومات برقرار رکھتا ہے۔
کثیر البولیتی شناخت: 202 بولیوں کا احاطہ کرتا ہے، جن میں کینٹونیز اور وینژو لہجہ بھی شامل ہیں۔
ماحولیاتی آواز کی شناخت: انسانی آواز اور پس منظر کی ماحولیاتی آوازوں کو بیک وقت سمجھتا ہے اور آواز کے وقوع پذیر ہونے والے منظرنامے کو پہچانتا ہے۔
مقرر کی شناخت: خودکار طور پر فرق کرتا ہے کہ کون بول رہا ہے، جسے اجلاس کی تحریر اور خلاصہ تیار کرنے جیسے کاموں میں استعمال کیا جا سکتا ہے۔
جذباتی تجزیہ: آواز میں موجود لہجے اور جذبات کو محسوس کرتا ہے، جس سے تعامل زیادہ انسانی محسوس ہوتا ہے۔
آڈیو سوال و جواب: پیچیدہ آڈیو مواد کو سمجھ کر سوالات کے جوابات دیتا ہے، اور ”صاف سننے“ سے ”سمجھ کر سننے“ تک پیش رفت کرتا ہے۔
03Spark-Audio-1.0-Preview کے تکنیکی اصول
اینڈ ٹو اینڈ صوتی فہم کا آرکیٹیکچر: روایتی ”پہلے متن میں تبدیل کریں، پھر بڑے ماڈل کو دیں“ والے سلسلہ وار طریقے کے برعکس، یہ ماڈل 0.65B آڈیو انکوڈر کو 30B-A3B بڑے لینگویج ماڈل کے ساتھ استعمال کرتا ہے۔ متن اور آواز کی دوہری طرزیں براہِ راست ایک ہی ماڈل میں داخل کی جاتی ہیں، جو انسانی آواز، ماحولیاتی آواز، موسیقی اور ان کے معنی، جذبات اور منظرناموں کو ایک ہی مرحلے میں سمجھ لیتا ہے، یوں سلسلہ وار عمل میں معلومات کے ضائع ہونے اور غلطیوں کے جمع ہونے سے بچا جاتا ہے۔
آڈیو انکوڈر کی پیشگی تربیت: آڈیو انکوڈر کی پیشگی تربیت کے ذریعے اس کی نمائندگی کی صلاحیت بتدریج بڑھائی جاتی ہے، پھر پیشگی تربیت اور بعد از تربیت کے ذریعے ماڈل کی بنیادی صلاحیت، پیچیدہ منظرناموں میں عمومی کارکردگی اور کثیر کاموں کے نتائج بہتر کیے جاتے ہیں۔ نتیجتاً بلند شور، کم آواز اور دیگر حقیقی پیچیدہ حالات میں بہترین کارکردگی حاصل ہوتی ہے۔
مکمل طور پر چینی کمپیوٹنگ وسائل پر تربیت: یہ ماڈل مکمل طور پر چینی کمپیوٹنگ وسائل کے کلسٹر پر 1300万 گھنٹوں کے آڈیو اور بڑی مقدار میں متنی ڈیٹا سے تربیت یافتہ ہے۔ یہ صنعت کا پہلا صوتی بنیادی بڑا ماڈل ہے جسے مکمل طور پر چینی کمپیوٹنگ وسائل پر تربیت دی گئی، اور اس نے ثابت کیا کہ چینی کمپیوٹنگ وسائل سے صنعتی سطح کے अग्रणी صوتی ماڈل تربیت دیے جا سکتے ہیں۔
فائن ٹیوننگ کے قابل بنیادی نظام: 科大讯飞 کے Spark بڑے ماڈل کے 1+N نظام کی طرح، Spark-Audio کو صوتی بنیادی ماڈل کے طور پر مزید فائن ٹیون کیا جا سکتا ہے، جس سے صوتی شناخت، صوتی ہم وقتی ترجمہ اور صوتی تعامل جیسے مخصوص ماڈل یا نظام تیار کیے جا سکتے ہیں، اور مختلف صوتی کاروباری منظرناموں میں نفاذ آسان ہوتا ہے۔
04Spark-Audio-1.0-Preview استعمال کرنے کا طریقہ
سرکاری تجرباتی صفحہ کھولیں: ماڈل کے تجرباتی پتے https://iflytekresearch.iflytek.com/experience/spark-audio پر جائیں۔
ماڈل کی صلاحیتوں کا آن لائن تجربہ کریں: صفحے پر متن یا آواز درج کریں اور صوتی تحریر، ترجمہ، بولی کی شناخت، آڈیو سوال و جواب سمیت دیگر افعال آزمائیں۔
05Spark-Audio-1.0-Preview کے بنیادی فوائد
مکمل طور پر چینی کمپیوٹنگ وسائل پر تربیت: صنعت کا پہلا صوتی بنیادی بڑا ماڈل جسے مکمل طور پر چینی کمپیوٹنگ وسائل کے کلسٹر پر تربیت دی گئی، اور جس نے ثابت کیا کہ چینی کمپیوٹنگ وسائل سے صنعتی سطح کے领先 ماڈل تربیت دیے جا سکتے ہیں۔
آواز کو براہِ راست اینڈ ٹو اینڈ سمجھنا: ”پہلے متن میں تبدیل کریں، پھر سمجھیں“ والے سلسلہ وار طریقے سے آزاد، لہجے، جذبات اور ماحولیاتی آواز جیسی اہم معلومات ضائع نہیں کرتا، اور عمل کے ٹوٹنے یا تاخیر اور رکاوٹ کو ختم کرتا ہے۔
زبانوں اور بولیوں کا وسیع احاطہ: 99 زبانوں اور 202 بولیوں کی شناخت کی معاونت کرتا ہے، اور یکساں حجم کے ماڈلوں کے مقابلے میں کثیر لسانی اور کثیر البولیتی شناخت میں بہتر کارکردگی دکھاتا ہے۔
پیچیدہ منظرناموں میں نمایاں کارکردگی: بلند شور، کم آواز اور دیگر حقیقی اطلاقی کاموں میں واضح برتری رکھتا ہے، جبکہ شور برداشت کرنے کی صلاحیت بھی نمایاں ہے۔
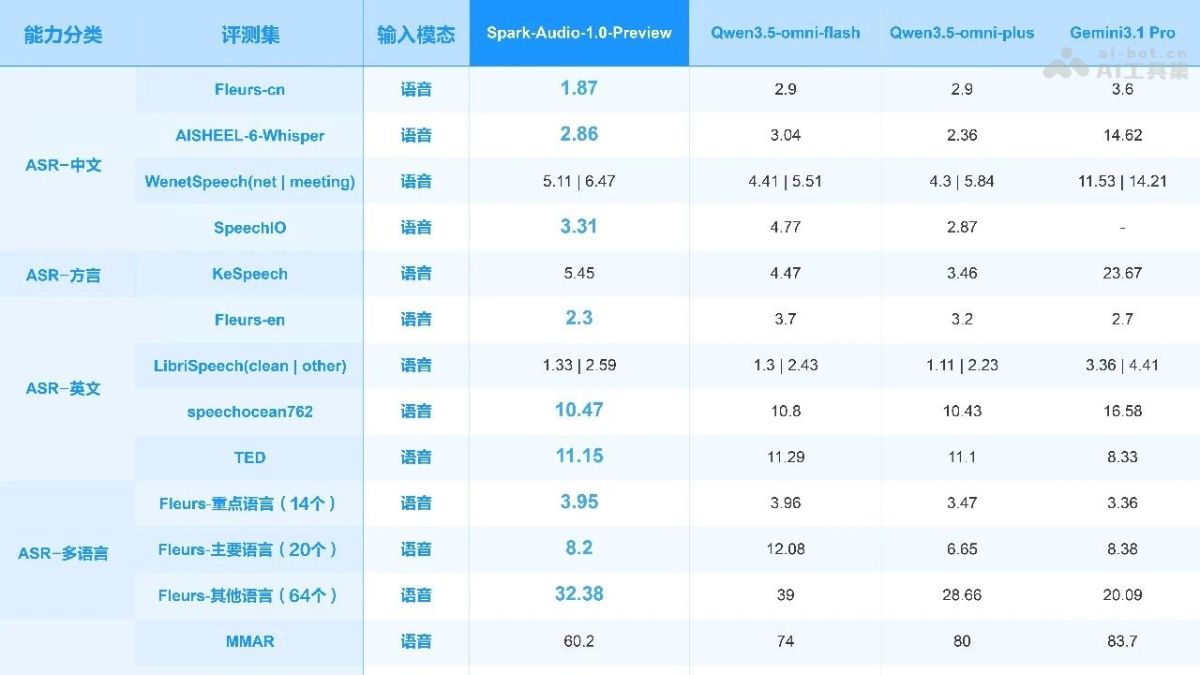
بڑے ماڈلوں کے مقابلے میں بھی مضبوط: اس کا نتیجہ اس سے ایک درجہ بڑے Qwen3.5-omni-plus کے قریب ہے، Fleurs چینی ٹیسٹ سیٹ پر SOTA حاصل کرتا ہے، اور متعدد جائزوں میں Gemini-3.1 Pro سے زیادہ اسکور حاصل کرتا ہے۔
متنی صلاحیت میں کمی نہیں: عمومی معلومات، ریاضی اور کوڈ جیسے متنی کاموں میں واضح ذہانت کی کمی ظاہر نہیں کرتا، اور صوتی بنیادی ماڈلوں کی عام مشکل پر قابو پاتا ہے۔
موثر آرکیٹیکچر: 0.65B آڈیو انکوڈر + 30B-A3B MoE آرکیٹیکچر استعمال کرتا ہے، اور چھوٹے حجم میں بڑے بند ماڈلوں کے قریب کارکردگی حاصل کرتا ہے۔
06Spark-Audio-1.0-Preview کے اطلاقی منظرنامے
ذہین کسٹمر سروس: صارف کے جذبات اور اظہار کے انداز کو پہچانتا ہے، گفتگو کو زیادہ مربوط اور انسانی بناتا ہے، اور سروس کے تجربے کو بہتر کرتا ہے۔
گاڑی کا کیبن: گاڑی کے شور والے ماحول میں ڈرائیور کی ہدایات کو درست طور پر پہچانتا ہے، بولیوں کے ذریعے تعامل کی معاونت کرتا ہے، اور گاڑی کے اندر زیادہ فطری صوتی تعامل کا تجربہ فراہم کرتا ہے۔
حقیقی وقت کا ترجمہ اور بین اللسانی اجلاس: صوتی ہم وقتی ترجمہ اور کثیر لسانی ترجمہ انجام دیتا ہے، جبکہ لہجے اور اتار چڑھاؤ جیسی صوتی آہنگ کی معلومات برقرار رکھتا ہے، جس سے زیادہ فطری بین اللسانی رابطہ ممکن ہوتا ہے۔
اجلاس کی تحریر اور خلاصہ سازی: مقررین میں خودکار فرق کرتا ہے، اہم فیصلہ جاتی نکات اخذ کرتا ہے اور منظم خلاصہ تیار کرتا ہے، جس سے عملے کا بار بار整理 کرنے کا کام کم ہوتا ہے۔
طبی الیکٹرانک ریکارڈ اور مواد کا جائزہ: آواز کے ذریعے طبی ریکارڈ مرتب کرنے اور مواد کا جائزہ لینے میں مدد دیتا ہے، جس سے طب جیسے تخصصی شعبوں میں دستی اندراج کا بوجھ کم اور کارکردگی بہتر ہوتی ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0