
- ماہانہ وزٹس
- 0
- قیمتیں
- مفت اور ادائیگی
- فہرست میں شامل
- 2026-08-13
- اپ ڈیٹ شدہ
- 2026-08-13
01dots.tts کیا ہے؟
dots.tts، ژیاؤہونگشو کی dots ٹیم اور شنگھائی جیاو تونگ یونیورسٹی کی X-LANCE لیبارٹری کے اشتراک سے اوپن سورس کیا گیا 2 ارب پیرامیٹرز پر مشتمل مکمل مسلسل خودکار صوتی ترکیب کا بنیادی ماڈل ہے۔ یہ ماڈل براہِ راست مسلسل مخفی فضایٔ میں 48kHz آڈیو کو حصوں میں تیار کرتا ہے اور Seed-TTS-Eval جیسے معیارات پر آواز کی مماثلت اور مواد کی درستگی میں SOTA نتائج حاصل کرتا ہے۔ یہ زیرو شاٹ کلوننگ، اسٹریمنگ آؤٹ پٹ اور کم تاخیر والی ڈوئل پلیکس گفتگو کو سپورٹ کرتا ہے۔ پروجیکٹ نے مکمل سورس کوڈ اور وزن جاری کیے ہیں، جبکہ dots.tts.edit کے ذریعے دقیق صوتی تدوین کی صلاحیت بھی فراہم کی گئی ہے۔
02dots.tts کے اہم افعال
زیرو شاٹ آواز کلوننگ: صرف 3–10 سیکنڈ کی حوالہ آڈیو سے اسی آواز میں کسی بھی نئے متن کی تلاوت کی جا سکتی ہے، اور بین اللسانی کلوننگ بھی معاونت یافتہ ہے۔ Seed-TTS-Eval معیار پر مواد کی درستگی اور بولنے والے کی مماثلت میں SOTA کارکردگی حاصل ہوتی ہے۔
متن سے آواز کی ترکیب: بے ترتیب آواز کے نمونے سے لے کر مخصوص بولنے والے کی اعلیٰ معیار کی آواز تک، 2B پیرامیٹرز والے مسلسل خودکار ماڈل کی بنیاد پر براہِ راست 48 kHz آڈیو تیار کی جاتی ہے۔
اسٹریمنگ جنریشن اور کم تاخیر والا تعامل: قدرتی طور پر اسٹریمنگ آؤٹ پٹ کو سپورٹ کرتا ہے۔ متن کا ابتدائی حصہ داخل کرتے ہی آڈیو حصوں میں تیار ہونا شروع ہو جاتی ہے؛ 1T1A ڈوئل اسٹریم موڈ میں اوپر والا LLM ہر ٹیکسٹ Token تیار کرتے ہی صوتی جانب فوری ردِعمل دیتی ہے۔ آڈیو کے پہلے پیکٹ کی تاخیر کم از کم 54.4 ملی سیکنڈ تک پہنچ سکتی ہے، جس سے یہ حقیقی وقت کے صوتی Agent اور ڈوئل پلیکس گفتگو کے لیے موزوں ہے۔
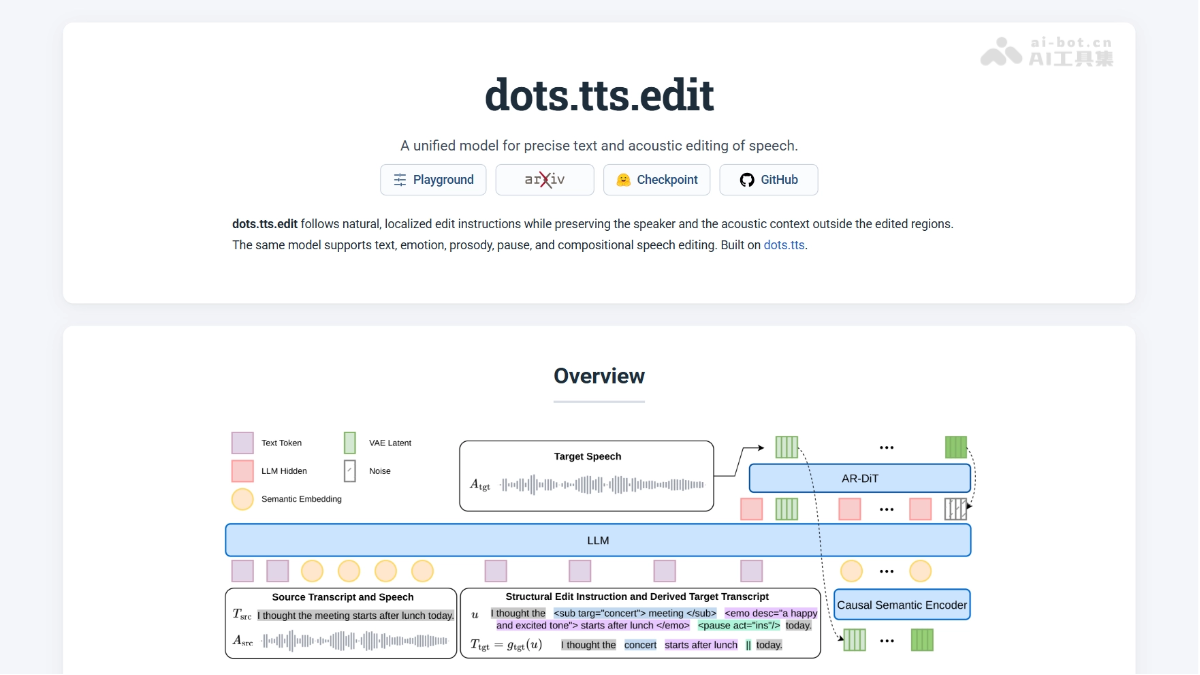
دقیق صوتی تدوین: موجودہ ریکارڈنگ میں متن کی تبدیلی، جذبات کی تنظیم، زیر و بم اور رفتار میں ترمیم، وقفوں کا اضافہ یا حذف ممکن ہے۔ متعدد کارروائیوں کو ایک ہی ہدایت میں یکجا کیا جا سکتا ہے، جبکہ غیر ترمیم شدہ حصے جوں کے توں رہتے ہیں۔
کثیر لسانی معاونت: 24 زبانوں کا احاطہ، MiniMax کثیر لسانی جائزے میں اوسط بولنے والے کی مماثلت 83.9، اور 19 زبانوں میں انفرادی طور پر پہلی پوزیشن۔
استدلال کی متعدد رفتاریں: Base، SOAR، MeanFlow (4 مراحل)، دو مرحلہ sCM اور ایک مرحلہ DMD سمیت متعدد چیک پوائنٹس دستیاب ہیں، جن کے ذریعے صارف آواز کے معیار اور استدلال کی رفتار کے درمیان اپنی ضرورت کے مطابق انتخاب کر سکتا ہے۔
03dots.tts کے تکنیکی اصول
وی چیٹ پر فالو کریں اور “开源” کا جواب بھیج کر AI اوپن سورس پروجیکٹس کے تبادلۂ خیال گروپ میں شامل ہوں
مکمل مسلسل خودکار معماری: dots.tts روایتی طریقوں میں صوتی سگنل کو مجرد Token میں تبدیل کرنے کے عمل کو ترک کرتا ہے۔ پوری جنریشن چین مسلسل مخفی فضایٔ میں چلتی ہے: ماڈل خودکار طریقے سے صوتی حصوں کی پیش گوئی کرتا ہے اور BigVGAN طرز کے ڈیکوڈر کے ذریعے انہیں 48 kHz موجی شکل میں بحال کرتا ہے۔ اس طرح مجرد مقدار بندی سے پیدا ہونے والی معلوماتی رکاوٹ اور آواز کی باریک تفصیلات کے نقصان سے بنیادی طور پر بچا جاتا ہے۔
معنوی مسلسل نمائندگی: ماڈل HoliTok کے ڈیزائن پر مبنی AudioVAE استعمال کرتا ہے، جو اصل موجی شکل کو 25 FPS کے مسلسل مخفی متغیرات میں سکیڑتا ہے۔ انکوڈر معنوی تربیت کے ذریعے بحالی کی وفاداری اور مخفی فضایٔ کی ساخت کے درمیان توازن قائم کرتا ہے، جس سے بحال شدہ بولنے والے کی مماثلت 0.969 تک پہنچتی ہے اور بعد کی خودکار جنریشن کے لیے آواز اور صوتی تفصیلات کی بھرپور گنجائش محفوظ رہتی ہے۔
غلطی پر قابو پانے کا نظام: مسلسل خودکار جنریشن میں پچھلے مراحل کی معمولی غلطیاں آگے جمع اور پھیل سکتی ہیں۔ اس مسئلے کے لیے dots.tts ایک علّی معنوی انکوڈر متعارف کراتا ہے، جو تیار شدہ VAE patch کو حقیقی وقت میں مختصر معنوی تاریخ میں سکیڑ کر بڑے لسانی ماڈل کو واپس فراہم کرتا ہے۔ زیادہ تغیر والی مقامی صوتی تبدیلیوں کو الگ کر کے صرف طویل مدتی معنوی خلاصہ برقرار رکھا جاتا ہے، جس سے طویل سلسلوں میں غلطیوں کا پھیلاؤ، سیٹی جیسی آواز اور آواز کا بہکاؤ مؤثر طور پر کم ہوتا ہے۔
جنریشن کا عمل: جنریشن کے مرکز میں بڑا لسانی ماڈل ہے، جسے Qwen2.5-1.5B سے ابتدائی بنایا گیا ہے۔ یہ براہِ راست BPE ٹیکسٹ Token استعمال کر کے ہر مرحلے کی مخفی حالت خارج کرتا ہے۔ اس کے بعد خودکار flow-matching ہیڈ (18 تہوں والا DiT)، LLM کی مخفی حالت اور خودکار ابتدائی سلسلے کی شرائط کے تحت، اگلے صوتی patch کی ڈینوائزنگ جنریشن کرتا ہے۔ ساتھ ہی منجمد CAM++ اسپیکر انکوڈر سے حاصل کردہ عالمی x-vector آواز کے تسلسل کی ضمانت دیتا ہے۔
بعد از تربیت رفتار میں اضافہ: ٹیم نے SOAR خود تصحیحی ہم آہنگی کے ذریعے ماڈل کو تربیت کے دوران حقیقی استدلال میں پیدا ہونے والی انحرافی حالتوں کی نقل اور خود اصلاح سکھائی، جس سے انعامی ماڈل کے بغیر استحکام بہتر ہوتا ہے۔ MeanFlow ڈسٹلیشن کے ذریعے استاد کے متعدد مراحل والے راستے کو اوسط رفتار میں سکیڑ کر 4 مراحل کی اعلیٰ معیار کی جنریشن حاصل کی گئی؛ سادہ بنائے گئے consistency model (sCM) کے ذریعے اسے 2 مراحل تک محدود کیا گیا؛ جبکہ انعام سے آگاہ distribution matching distillation (DMD) اور دو زمانی پیمانوں کی اپ ڈیٹ حکمتِ عملی سے قدرتی اور واضح اعلیٰ معیار کا ایک مرحلہ ماڈل حاصل کیا گیا۔
04dots.tts کا استعمال کیسے کریں
تنصیب: pip install dots.tts چلانے سے تنصیب مکمل ہو جاتی ہے، یا GitHub سے سورس کوڈ کلون کر کے pip install -e . کے ذریعے مقامی ڈویلپمنٹ تنصیب کی جا سکتی ہے۔ زیادہ ہم وقتی استعمال کے لیے CUDA Graph ایکسیلیریشن اور مسلسل بیچ پراسیسنگ حاصل کرنے کی غرض سے SGLang Omni اضافی طور پر تعینات کیا جا سکتا ہے۔
کمانڈ لائن ترکیب: dots.tts انٹری پوائنٹ استعمال کرتے ہوئے --model-name-or-path، --text، ہدف --prompt-audio اور --prompt-text متعین کریں تاکہ زیرو شاٹ آواز کلوننگ کی جا سکے۔ --prompt-text چھوڑنے پر یہ x-vector کلوننگ میں تبدیل ہو جاتی ہے، جبکہ --prompt-audio چھوڑنے پر بے ترتیب آواز کا نمونہ تیار کیا جاتا ہے۔
کمانڈ لائن تدوین: dots.tts.edit انٹری پوائنٹ استعمال کریں اور --source-audio اور XML طرز کی --instruction فراہم کریں، جس کے ذریعے موجودہ ریکارڈنگ میں متن کی تبدیلی، جذبات یا آہنگ میں ترمیم جیسی دقیق تدوین کی جا سکتی ہے۔
Python API کا بنیادی استعمال: DotsTtsRuntime.from_pretrained() کے ذریعے ماڈل لوڈ کرنے کے بعد generate() کال کریں۔ متن اور اختیاری حوالہ آڈیو فراہم کر کے ترکیب شدہ آڈیو ٹینسر حاصل کیا جا سکتا ہے اور فائل میں محفوظ کیا جا سکتا ہے۔
Python API اسٹریمنگ آؤٹ پٹ: generate_stream() کال کرنے سے آڈیو ٹینسر حصوں میں حاصل کیے جا سکتے ہیں، جنہیں حقیقی وقت میں پلیئر یا WebSocket پر بھیج کر جنریشن کے ساتھ ساتھ پلے بیک کی کم تاخیر والی سہولت فراہم کی جا سکتی ہے۔
Python API ڈوئل اسٹریم گفتگو: DotsTtsRuntimeDoubleStreaming کے ذریعے سیشن شروع کرنے کے بعد متن کو Token بہ Token بھیجیں۔ صوتی جانب فوراً جنریشن شروع ہو جاتی ہے اور آڈیو کے پہلے پیکٹ کی تاخیر 54.4 ملی سیکنڈ تک کم ہو سکتی ہے، جو حقیقی وقت کے صوتی Agent کے لیے موزوں ہے۔
فائن ٹیوننگ: accelerate launch scripts/train_dots_tts.py چلائیں اور اپنے ڈیٹا کے راستے کی ترتیب کریں، پھر عوامی چیک پوائنٹس کی بنیاد پر آواز یا شعبہ جاتی موافقت کی فائن ٹیوننگ کی جا سکتی ہے۔
ڈسٹلیشن کے ذریعے رفتار میں اضافہ: scripts/train_dots_tts_meanflow.py کے ذریعے SOAR چیک پوائنٹ کو استاد بنا کر MeanFlow ڈسٹلیشن کریں۔ اس سے 4، 2 یا 1 مرحلے والے اعلیٰ معیار کے طالب علم ماڈل حاصل کیے جا سکتے ہیں تاکہ مختلف تاخیر اور ہم وقتی ضرورتوں کے مطابق استعمال کیا جا سکے۔
ویب انٹرفیس: python apps/gradio/app.py چلا کر بصری صوتی ترکیب کا انٹرفیس شروع کریں، یا apps/edit_playground/app.py چلا کر Edit Playground شروع کریں۔ براؤزر میں آڈیو اپ لوڈ کریں، تدوینی حصوں کی نشان دہی کریں اور نتائج کا حقیقی وقت میں پیش نظارہ دیکھیں۔
05dots.tts کے بنیادی فوائد
مسلسل مخفی فضایٔ کی ماڈلنگ: مجرد صوتی Token کو ترک کر کے مسلسل مخفی فضایٔ میں براہِ راست خودکار جنریشن کی جاتی ہے، جس سے اسپیکٹرل ساخت، سانس دار آواز اور دیگر بھرپور صوتی تفصیلات محفوظ رہتی ہیں۔ بحال شدہ بولنے والے کی مماثلت 0.969 تک پہنچتی ہے۔
SOTA ترکیبی معیار: Seed-TTS-Eval معیار پر مواد کی درستگی اور آواز کی مماثلت، دونوں میں SOTA نتائج؛ 24 زبانوں کے MiniMax جائزے میں اوسط SIM 83.9، اور مجموعی کارکردگی میں مرکزی دھارے کے حل سے بہتر۔
مقامی اسٹریمنگ اور کم تاخیر: 1T1A ڈوئل اسٹریم موڈ میں آڈیو کے پہلے پیکٹ کی تاخیر 54.4 ملی سیکنڈ تک کم ہے۔ SGLang Omni کے ساتھ ایک H100 کارڈ پر 16 راستوں کی ہم وقتی throughput 4.76 req/s تک پہنچتی ہے، جو حقیقی وقت کے صوتی Agent کی ضرورت پوری کرتی ہے۔
متحدہ تدوینی صلاحیت: dots.tts.edit اسی بنیادی ماڈل پر مبنی ہے اور XML ساختی ہدایات کے ذریعے متن، جذبات، آہنگ اور وقفوں کی دقیق تدوین کو سپورٹ کرتا ہے۔ doteBench جائزے میں یہ مجموعی طور پر دیگر اوپن سورس نظاموں سے آگے ہے۔
06dots.tts کا پروجیکٹ ایڈریس
GitHub ریپوزٹری:https://github.com/studio-dots-ai/dots.tts
arXiv تکنیکی مقالہ:https://arxiv.org/pdf/2608.02673
07dots.tts کے اطلاقی منظرنامے
حقیقی وقت کا صوتی Agent: 1T1A ڈوئل اسٹریم موڈ میں پہلے پیکٹ کی تاخیر 54.4 ملی سیکنڈ تک کم ہے، جو LLM سے چلنے والی حقیقی وقت کی ڈوئل پلیکس گفتگو اور صوتی معاونین کے لیے موزوں ہے۔
زیرو شاٹ آواز کلوننگ: چند سیکنڈ کی حوالہ آڈیو سے کسی بھی آواز کی نقل کی جا سکتی ہے، بین اللسانی کلوننگ معاونت یافتہ ہے، اور یہ آڈیو بکس، ڈبنگ اور ذاتی نوعیت کے مواد کی تخلیق کے لیے موزوں ہے۔
کثیر لسانی مواد کی تخلیق: 24 زبانوں کا احاطہ اور بولنے والے کی اعلیٰ مماثلت برقرار رکھتے ہوئے، عالمی مصنوعات کے کثیر لسانی صوتی اعلانات اور مقامی نوعیت کی خدمات کے لیے موزوں ہے۔
دقیق صوتی تدوین: dots.tts.edit کے ذریعے موجودہ ریکارڈنگ میں متن کی تبدیلی، جذبات کی تنظیم، آہنگ میں ترمیم اور وقفوں کی ایڈجسٹمنٹ کی جا سکتی ہے، جو پوڈکاسٹ کی بعد از تیاری اور آڈیو مواد کی باریک اصلاح کے لیے موزوں ہے۔
لائیو اسٹریمنگ اور حقیقی وقت کے اعلانات: LLM کے اسٹریمنگ آؤٹ پٹ کے ساتھ جنریشن کے دوران ہی پلے بیک ممکن ہے، جو خبروں کے اعلانات، لائیو کامرس اور حقیقی وقت کی معلوماتی نشریات کے لیے موزوں ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0