
- ماہانہ وزٹس
- 0
- قیمتیں
- مفت اور ادائیگی
- فہرست میں شامل
- 2026-08-07
- اپ ڈیٹ شدہ
- 2026-08-07
01SALMONN-2 کیا ہے
SALMONN-2 سنگھوا یونیورسٹی، شنگھائی مصنوعی ذہانت لیبارٹری اور کیمبرج یونیورسٹی کی جانب سے مشترکہ طور پر جاری کیا گیا عمومی آڈیو بڑا زبان ماڈل ہے۔ یہ بائٹ ڈانس کے SPEAR متحدہ خود زیرِ نگرانی آڈیو انکوڈر اور کثیر سطحی خصوصیات کے امتزاج والے اڈاپٹر پر مبنی ہے، Qwen3 کو متن کے بنیادی ماڈل کے طور پر استعمال کرتا ہے، اور تقریباً 1.8万 گھنٹے کے زیرِ نگرانی ڈیٹا کے ذریعے MMAU-Pro، MMAR اور MMSU کے تین بڑے جامع معیارات پر ہم حجم اوپن سورس ماڈلز میں بہترین کارکردگی حاصل کرتا ہے۔ یہ پہلی بار عمومی ALLM میں آواز کے واقعات کی شناخت، آڈیو جعل سازی کی شناخت، تقریری معیار کی جانچ اور کثیر الوسائطی سیاقی تقریر کی شناخت جیسی جدید صلاحیتوں کو منظم طور پر نافذ کرتا ہے۔
02SALMONN-2 کی اہم خصوصیات
عمومی آڈیو تفہیم: تقریر کی شناخت، آڈیو کی وضاحت، موسیقی کی تفہیم، جذبات کی شناخت اور مقرر کی تصدیق جیسے بین المجال کاموں کو سپورٹ کرتا ہے۔
آواز کے واقعات کی شناخت (SED): ماحول میں موجود آواز کے واقعات، مثلاً کتے کے بھونکنے اور قدموں کی آواز، کے آغاز اور اختتام کے اوقات کی نشاندہی کر کے انہیں آؤٹ پٹ کر سکتا ہے۔
آڈیو ڈیپ فیک کی شناخت: تقریر کے اصلی یا جعلی ہونے کا تعین کرتا ہے اور ممکنہ طور پر مصنوعی یا ترمیم شدہ مقامی حصوں کے زمانی وقفوں کی نشاندہی کرتا ہے۔
تقریری معیار کی جانچ (SQA): شور، تحریف، وضاحت جیسی نچلی سطح کی صوتی خصوصیات کو محسوس کر کے معیار کا اسکور اور وضاحت فراہم کرتا ہے۔
کثیر الوسائطی سیاقی تقریر کی شناخت (MICL): تحریری ہجے اور حوالہ جاتی تلفظ کی آڈیو کو یکجا کر کے نایاب الفاظ اور کم معروف ناموں کی شناخت کی درستگی بہتر بناتا ہے۔
03SALMONN-2 کا تکنیکی اصول
وی چیٹ پر فالو کریں اور “开源” کا جواب بھیج کر AI اوپن سورس منصوبوں کے گروپ میں شامل ہوں
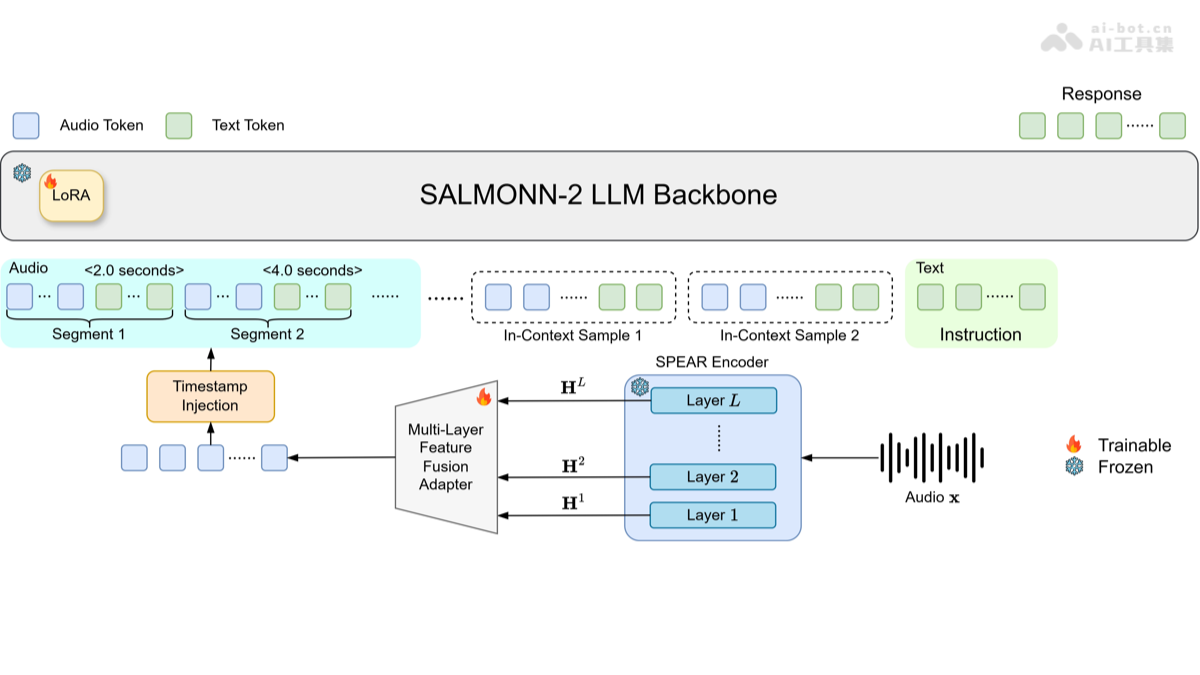
متحدہ خود زیرِ نگرانی آڈیو انکوڈر: SALMONN-2 واحد آڈیو فرنٹ اینڈ کے طور پر SPEAR استعمال کرتا ہے۔ یہ انکوڈر بڑے پیمانے پر غیر لیبل شدہ آڈیو ڈیٹا پر خود زیرِ نگرانی سیکھنے کے ذریعے تربیت پاتا ہے اور بیک وقت معنوی معلومات، تلفظ، آواز کا رنگ، مقرر اور صوتی ماحول سے متعلق معلومات حاصل کر سکتا ہے۔ یوں یہ روایتی Whisper+BEATs دوہرے انکوڈر کے طریقے کی جگہ لیتا ہے اور ساخت کو آسان بنانے کے ساتھ زیادہ متوازن بین المجال صلاحیت برقرار رکھتا ہے۔
کثیر سطحی خصوصیات کا امتزاج (MLF) اڈاپٹر: SPEAR کی مختلف سطحوں پر انکوڈ شدہ معلومات کی نوعیت مختلف ہوتی ہے: ابتدائی سطحیں صوتی اور تلفظی تفصیلات محفوظ رکھتی ہیں، درمیانی سطحیں آواز کے رنگ اور مقرر سے متعلق معلومات رکھتی ہیں، جبکہ گہری سطحیں معنوی تصورات جمع کرتی ہیں۔ MLF اڈاپٹر پہلے ہر سطح کی مخفی حالتوں کو نارملائز کر کے جوڑتا ہے، پھر قابلِ سیکھنے والے ڈاؤن پروجیکشن اور فریم گروپ کمپریشن کے ذریعے انہیں کم کرتا ہے، اور آخر میں یکجا شدہ سطحی نمائندگی کو زبان ماڈل کی ایمبیڈنگ اسپیس میں منتقل کرتا ہے، تاکہ ماڈل کام کی ضرورت کے مطابق صوتی اشاروں کی مختلف سطحوں کو لچک سے استعمال کر سکے۔
ٹائم اسٹیمپ داخل کرنے کا طریقہ: ماڈل ٹائم اسٹیمپ کو قدرتی زبان کے متن کی شکل، مثلاً <2.0 seconds>، میں براہِ راست آڈیو سلسلے میں داخل کرتا ہے اور آڈیو ایمبیڈنگ کے ساتھ باری باری زبان ماڈل کو فراہم کرتا ہے۔ اس طرح ماڈل اضافی مخصوص ٹائم اسٹیمپ ایمبیڈنگ پرت کے بغیر متحدہ تخلیقی فریم ورک میں زمانی محلِ وقوع کے کام مکمل کر سکتا ہے۔
کثیر الوسائطی سیاقی سیکھنے (MICL) کی تربیت: سیاقی تقریر کی شناخت کے کاموں میں ماڈل نہ صرف متنی ترجیحی الفاظ کی فہرست وصول کرتا ہے بلکہ ان الفاظ کے حوالہ جاتی تلفظ کی آڈیو بھی کثیر الوسائطی سیاق کے طور پر بیک وقت حاصل کرتا ہے۔ تربیت کے دوران مداخلتی الفاظ اور ہدف الفاظ کو تصادفی طور پر خارج کرنے کی حکمتِ عملی متعارف کرائی جاتی ہے تاکہ حد سے زیادہ تعصب روکا جا سکے اور ماڈل صوتی شواہد کی تائید کی صورت میں سیاقی اشاروں کو مناسب طور پر استعمال کرنا سیکھے۔
04SALMONN-2 کا استعمال کیسے کریں
مخزن تک رسائی حاصل کر کے کوڈ کلون کریں: GitHub مخزن https://github.com/bytedance/SALMONN/tree/salmonn2 پر جائیں اور git clone کے ذریعے کوڈ مقامی مشین پر ڈاؤن لوڈ کریں۔
رن ٹائم ماحول بنائیں: conda create -n salmonn2 python=3.10 چلا کر ورچوئل ماحول بنائیں اور فعال کریں، پھر pip، setuptools اور wheel کو اپ گریڈ کریں۔
انحصارات اور منصوبہ انسٹال کریں: مخزن کی بنیادی ڈائریکٹری میں pip install -r requirements.txt اور pip install -e . --no-deps چلائیں تاکہ SALMONN-2 اور اس کے رن ٹائم انحصارات انسٹال ہو جائیں۔
پہلے سے تربیت یافتہ وزن ڈاؤن لوڈ کریں: ماڈل چیک پوائنٹ ڈاؤن لوڈ کرنے کے لیے HuggingFace CLI استعمال کریں: hf download marcoyang/SALMONN-2-8B --repo-type model --local-dir /path/to/salmonn-2-hf۔
ماڈل لوڈ کر کے inference کریں: AutoProcessor اور AutoModelForCausalLM کے ذریعے مقامی وزن لوڈ کریں، آڈیو فائل اور ہدایتی متن فراہم کریں، پھر model.generate() کو کال کر کے آڈیو تفہیم کا نتیجہ حاصل کریں۔
05SALMONN-2 کے بنیادی فوائد
ڈیٹا کا مؤثر استعمال: تقریباً 1.8万 گھنٹے کے زیرِ نگرانی ڈیٹا سے تربیت، جو ہم حجم کے حریف ماڈلز کے عام طور پر استعمال ہونے والے لاکھوں گھنٹوں کے مقابلے میں بہت کم ہے، اس طرح لیبلنگ کی لاگت نمایاں طور پر کم ہوتی ہے۔
زیادہ متوازن متحدہ فرنٹ اینڈ: واحد SPEAR خود زیرِ نگرانی انکوڈر دوہرے انکوڈر کی جگہ لے کر تقریر، ماحول کی آواز، موسیقی اور پیرا لسانی کاموں کے درمیان زیادہ متوازن کارکردگی فراہم کرتا ہے۔
سطحی معلومات کا مکمل استعمال: MLF اڈاپٹر انکوڈر کی تمام سطحوں کی خصوصیات کو یکجا کرتا ہے، جس سے صرف آخری سطح استعمال کرنے کے باعث صوتی اور آواز کے رنگ جیسی اہم تفصیلات کے ضائع ہونے سے بچا جا سکتا ہے۔
وسیع آڈیو تجزیاتی صلاحیتیں: عمومی ALLM میں پہلی بار SED، جعل سازی کی شناخت اور SQA جیسے ماضی میں نظر انداز کیے گئے صوتی تجزیاتی کاموں کو منظم طور پر سپورٹ کرتا ہے۔
قابلِ توسیع پیمانہ: متن کے بنیادی ماڈل کو 8B سے 30B-A3B تک بڑھانے کے بعد تینوں جامع معیارات کے اسکور مسلسل بہتر ہوئے، جس سے ثابت ہوتا ہے کہ یہ ساخت scale-up کی اچھی صلاحیت رکھتی ہے۔
06SALMONN-2 کا منصوبہ جاتی پتہ
GitHub مخزن: https://github.com/bytedance/SALMONN/tree/salmonn2
HuggingFace ماڈل مخزن: https://huggingface.co/marcoyang/SALMONN-2-8B
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2607.17079
07SALMONN-2 کے استعمال کے منظرنامے
ذہین میٹنگ معاون: میٹنگ کے مواد کو حقیقی وقت میں نقل کرتا ہے اور شرکا کے تلفظ کی مثالوں کے ساتھ غیر ملکی ناموں اور خصوصی اصطلاحات کی درست شناخت کرتا ہے۔
آڈیو مواد کی جانچ: لائیو نشریات یا پوڈ کاسٹ میں غیر معمولی آواز کے واقعات کو خودکار طور پر شناخت کرتا ہے اور فراڈ سے بچاؤ کے لیے ڈیپ فیک تقریر کی نشاندہی کرتا ہے۔
تقریری معیار کی نگرانی: کسٹمر سروس کالز اور ریکارڈنگ اسٹوڈیو کے مواد کے معیار کا خودکار اسکور تیار کرتا ہے اور شور و تحریف والے حصوں کی نشاندہی کرتا ہے۔
ملٹی میڈیا آرکائیو کی تلاش: تاریخی آڈیو اور ریڈیو پروگراموں کے لیے ٹائم اسٹیمپ سمیت واقعات کی وضاحتیں تیار کرتا ہے، جس سے مواد پر مبنی درست تلاش ممکن ہوتی ہے۔
سماعت سے محروم افراد کے معاون آلات: ماحول میں ہونے والے آواز کے واقعات، مثلاً دروازے کی گھنٹی اور الارم، کو متن اور ٹائم اسٹیمپ کی صورت میں سماعت سے محروم صارفین کو حقیقی وقت میں مطلع کرتا ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0