
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-11
01PixelUMM کیا ہے؟
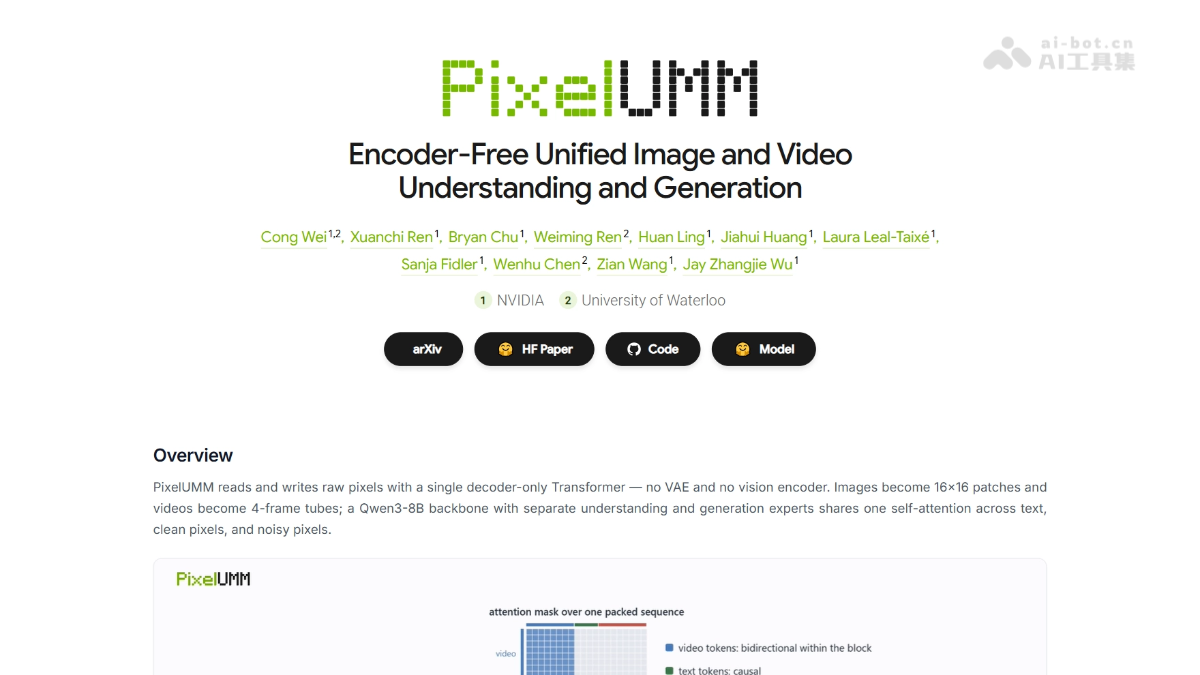
PixelUMM، NVIDIA اور یونیورسٹی آف واٹرلو کی جانب سے مشترکہ طور پر تیار کیا گیا ایک بغیر انکوڈر کا متحدہ ملٹی موڈل ماڈل ہے۔ اس کی بنیادی جدت VAE اور بصری انکوڈر کو مکمل طور پر ہٹا دینا ہے۔ یہ واحد Decoder-only Transformer استعمال کرتے ہوئے تصاویر اور ویڈیوز کو براہِ راست خام پکسل اسپیس میں پڑھتا اور لکھتا ہے، جبکہ سمجھنے اور تخلیق کرنے کے لیے ایک ہی ڈیکوڈر اور self-attention کا اشتراک کرتا ہے۔ تصاویر کو 16×16 پیچز اور ویڈیوز کو 4 فریم والے ٹیوبلٹس میں تقسیم کیا جاتا ہے، اور اس کا کوڈ اوپن سورس کر دیا گیا ہے۔
02PixelUMM کے اہم افعال
متن سے ویڈیو (T2V): زیادہ سے زیادہ 832×464، 96 فریم اور 24fps کے ساتھ 4 سیکنڈ کی ویڈیوز بنانے کی سہولت، جس کا معیار معروف ویڈیو ڈفیوژن ماڈلز کے ہم پلہ ہے۔
متن سے تصویر (T2I): اسی ماڈل میں براہِ راست تصاویر بنائیں؛ الگ تصویری شاخ یا ڈیکوڈر کی ضرورت نہیں۔
تصویری فہم: VQA، OCR، چارٹس، دستاویزات سمیت تصویری فہم کے 21 کام انجام دے سکتا ہے، اور 8B درجے کے VLM کی اوسط کارکردگی حاصل کرتا ہے۔
ویڈیو فہم: MVBench، Video-MME جیسے ویڈیو سوال و جواب کے بینچ مارکس کو سپورٹ کرتا ہے، اور dense اور sparse دونوں ان پٹ موڈ فراہم کرتا ہے۔
تصویر سے ویڈیو (I2V): صاف ابتدائی فریم کی تصویر کو فہم کے ماہر ماڈیول میں شرط کے طور پر شامل کر کے بعد کی ویڈیو بنائیں؛ شرطی فریم کو VAE کے ذریعے انکوڈ کرنے کی ضرورت نہیں۔
ویڈیو ایڈیٹنگ: ان پٹ ویڈیو کو بصری شرط کے طور پر استعمال کرتے ہوئے، کثیر الوسائطی سیاقی شرائط کے طریقۂ کار کے ذریعے ایڈیٹنگ کے کام انجام دیتا ہے۔
03PixelUMM کے تکنیکی اصول
بغیر انکوڈر کا معماری ڈھانچہ: PixelUMM نے روایتی یکساں ماڈلز میں موجود VAE اور وژول انکوڈر کو مکمل طور پر ہٹا دیا ہے۔ تصاویر کو براہِ راست 16×16 patch اور ویڈیوز کو 4 فریم کے tubelet کی شکل میں خام RGB پکسلز کے طور پر تقسیم کر کے ان پٹ دیا جاتا ہے، جبکہ آؤٹ پٹ بھی لکیری ہیڈ کے ذریعے براہِ راست پکسلز کی پیش گوئی کرتا ہے۔ پورے عمل میں latent اسپیس کی انکوڈنگ اور ڈیکوڈنگ کا کوئی نقصان نہیں ہوتا، جس سے حقیقی end-to-end پکسل پڑھنے اور لکھنے کی صلاحیت حاصل ہوتی ہے۔
MoT مشترکہ توجہ کا ڈھانچہ: ماڈل Qwen3-8B کو بنیادی ڈھانچے کے طور پر استعمال کرتے ہوئے Mixture-of-Transformers بناتا ہے: فہم کے ماہر اور جنریشن کے ماہر اپنے اپنے آزاد FFN رکھتے ہیں، جبکہ ایک ہی self-attention شیئر کرتے ہیں۔ اس طرح متن، صاف پکسلز اور شور زدہ پکسلز ایک ہی attention اسپیس میں باہمی تعامل کر سکتے ہیں، اور ایک ہی ماڈل میں فہم اور جنریشن کو یکجا کیا جاتا ہے۔
پکسل اسپیس میں diffusion ٹریننگ: جنریشن کے کاموں کے لیے پکسل اسپیس میں براہِ راست flow-matching طرز کی ٹریننگ کی جاتی ہے۔ ablation تجربات سے ظاہر ہوتا ہے کہ پکسل اسپیس اور VAE اسپیس کے gradient norms تقریباً یکساں ہیں، لیکن پکسل اسپیس کی ٹریننگ زیادہ مستحکم ہے۔ compression ratio کے تجربات نے بھی ثابت کیا کہ 16×16 patch اور 4 فریم کا tubelet سیکھنے کی دشواری اور کارکردگی کے درمیان بہترین توازن فراہم کرتے ہیں۔
ملٹی موڈل condition injection کا طریقۂ کار: حوالہ جاتی متنی condition، حوالہ جاتی تصویر اور ان پٹ ویڈیو جیسی ”صاف conditions“ کو یکساں طور پر فہم کے ماہر کے ذریعے پروسیس کیا جاتا ہے، جبکہ جنریشن کے لیے مطلوب noise tokens جنریشن کے ماہر کو دیے جاتے ہیں۔ دونوں مشترکہ attention میں ضم ہو جاتے ہیں۔ اس سے SenseNova-U1 کی encoder-free condition تکنیک کو text-to-video اور video editing تک وسعت ملتی ہے۔ ablation سے ظاہر ہوا کہ یہ ڈیزائن فہم کی صلاحیت کو نقصان نہیں پہنچاتا، جبکہ ویڈیو کے چار benchmarks میں 0.89–3.49 پوائنٹس کا اضافہ کرتا ہے۔
لکیری آؤٹ پٹ ہیڈ اور convolutional ہیڈ کا ablation: پہلے سے طے شدہ طور پر ہلکا پھلکا لکیری آؤٹ پٹ ہیڈ استعمال کیا جاتا ہے، جو 16 پکسل کے grid artifacts پیدا کر سکتا ہے۔ تجربات میں Wan طرز کے upsampling convolutional ہیڈ اور PixelShuffle ہیڈ کا موازنہ کیا گیا، جس سے ثابت ہوا کہ convolutional ہیڈ artifacts کو ختم کر سکتا ہے۔ ان میں وقت کو ترجیح دینے والا PixelShuffle ٹریننگ لاس اور artifacts کو دبانے کے درمیان بہترین سمجھوتا فراہم کرتا ہے، تاہم ہیڈ تبدیل کرنے کے لیے دوبارہ ٹریننگ ضروری ہے۔
04PixelUMM استعمال کرنے کا طریقہ
ریپوزٹری کلون کریں: git clone https://github.com/nv-tlabs/PixelUMM، اور ENVIRONMENT.md کے مطابق CUDA ماحول ترتیب دیں۔
وزن ڈاؤن لوڈ کریں: Hugging Face سے nvidia/PixelUMM کا ڈیفالٹ checkpoint S8-F22-R05 ڈاؤن لوڈ کریں، اور CHECKPOINT.md کے مطابق Qwen3-8B کی configuration اور tokenizer فائلیں ڈاؤن لوڈ کریں۔
راستے مقرر کریں: PIXELUMM_CKPT، PIXELUMM_QWEN_DIR، اور PIXELUMM_OUTPUT تینوں environment variables کو مقامی مطلق راستوں کی طرف متعین کریں۔
checkpoint کی جانچ کریں: پہلے check_checkpoint.py چلائیں تاکہ وزن کی تکمیل اور tensors کی مطابقت کی جانچ ہو سکے۔
حفاظتی جائزے کی اجازت حاصل کریں: Hugging Face پر nvidia/Cosmos-1.0-Guardrail تک رسائی کی اجازت کے لیے درخواست دیں اور لاگ اِن کریں۔
inference چلائیں: --task t2i / t2v / image-vlm / video-vlm میں سے متعلقہ آپشن inference.py کے ساتھ متعین کریں، اور prompt، ریزولوشن، فریموں کی تعداد جیسے parameters استعمال کرکے تصاویر، ویڈیوز یا فہم کے نتائج تیار کریں۔
بیچ جنریشن (اختیاری): YAML prompt فائل کے ساتھ inference_batch.py استعمال کرکے tasks کو بیچ میں چلائیں۔
کھلونا تربیت (اختیاری): TRAIN.md کے مطابق toy dataset ڈاؤن لوڈ کریں، اور F22 checkpoint کی بنیاد پر چار tasks کی training کی مثال train_toy.py سے چلائیں۔
05PixelUMM کے بنیادی فوائد
مکمل طور پر انکوڈر سے پاک فنِ تعمیر: VAE اور وژوئل انکوڈر کو ہٹا کر براہِ راست خام پکسل اسپیس میں پڑھنا اور لکھنا، یوں latent اسپیس کی انکوڈنگ و ڈیکوڈنگ سے ہونے والے معلوماتی نقصان اور مصنوعی نقائص کے ذرائع ختم ہو جاتے ہیں۔
فہم اور تخلیق کا اتحاد: ایک واحد decoder-only Transformer بیک وقت متن سے تصویر، متن سے ویڈیو، تصویر کی تفہیم اور ویڈیو کی تفہیم کے چاروں کام انجام دیتا ہے؛ فہم اور تخلیق کے ماہرین ایک ہی self-attention شیئر کرتے ہیں۔
سادہ فنِ تعمیر، براہِ راست inference: آؤٹ پٹ کو ہلکے پھلکے linear head کے ذریعے براہِ راست پکسلز پر ریگریس کیا جاتا ہے، کسی اضافی decoder کی ضرورت نہیں، اس لیے تخلیق کا سلسلہ مختصر ہو جاتا ہے۔
شرائط کی لچکدار اور مؤثر شمولیت: حوالہ جاتی تصاویر اور ان پٹ ویڈیوز جیسی صاف شرائط کو صرف فہم کے ماہر کے ذریعے استعمال کر کے تصویر سے ویڈیو اور ویڈیو ایڈیٹنگ ممکن ہوتی ہے؛ ablation سے ثابت ہوتا ہے کہ یہ ڈیزائن فہم کی صلاحیت کو متاثر نہیں کرتا۔
تربیتی اصول واضح اور قابلِ توسیع: 8B ماڈل مساوی loss تک پہنچنے کے لیے 1.7B ماڈل کے مطلوبہ تربیتی مراحل کے تقریباً ایک تہائی کا محتاج ہے، جس سے اسکیلنگ کا فائدہ واضح ہوتا ہے۔
06PixelUMM کے پروجیکٹ لنکس
پروجیکٹ کی ویب سائٹ: https://nv-tlabs.github.io/PixelUMM/
GitHub ریپوزٹری: https://github.com/nv-tlabs/PixelUMM
HuggingFace ماڈل ریپوزٹری: https://huggingface.co/nvidia/PixelUMM
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2609.38597
07PixelUMM کے اطلاقی منظرنامے
مختصر ویڈیو مواد کی تخلیق: صرف ایک جملے کا متن درج کریں اور 4 سیکنڈ، 24fps ویڈیو براہِ راست تیار کریں، جو سوشل میڈیا کے لیے فوری مواد بنانے میں موزوں ہے۔
تصویر سے ویڈیو اور ویڈیو ایڈیٹنگ: پہلے فریم یا اصل ویڈیو کو بنیاد بنا کر مواد تیار یا تبدیل کریں، جسے ای کامرس مصنوعات کی متحرک نمائش اور فلم و ٹی وی کے ابتدائی پیش منظر کے لیے استعمال کیا جا سکتا ہے۔
طویل ویڈیوز کی تفہیم اور سوال و جواب: فراہم کردہ ویڈیو کی وضاحت، خلاصہ اور زمانی استدلال انجام دیں، جو مواد کی جانچ، مواد کی تلاش اور اجلاس کی روداد کے لیے موزوں ہے۔
دستاویزات اور چارٹس کا تجزیہ: OCRBench میں 78.0 اور DocVQA میں 90.4 کے نتائج رسیدوں کی شناخت، رپورٹس سے متعلق سوال و جواب اور دیگر کاروباری دستاویزات کی ذہین پروسیسنگ کے منظرناموں کو سہارا دے سکتے ہیں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0