
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-30
01Nemotron 3.5 Transcribe کیا ہے
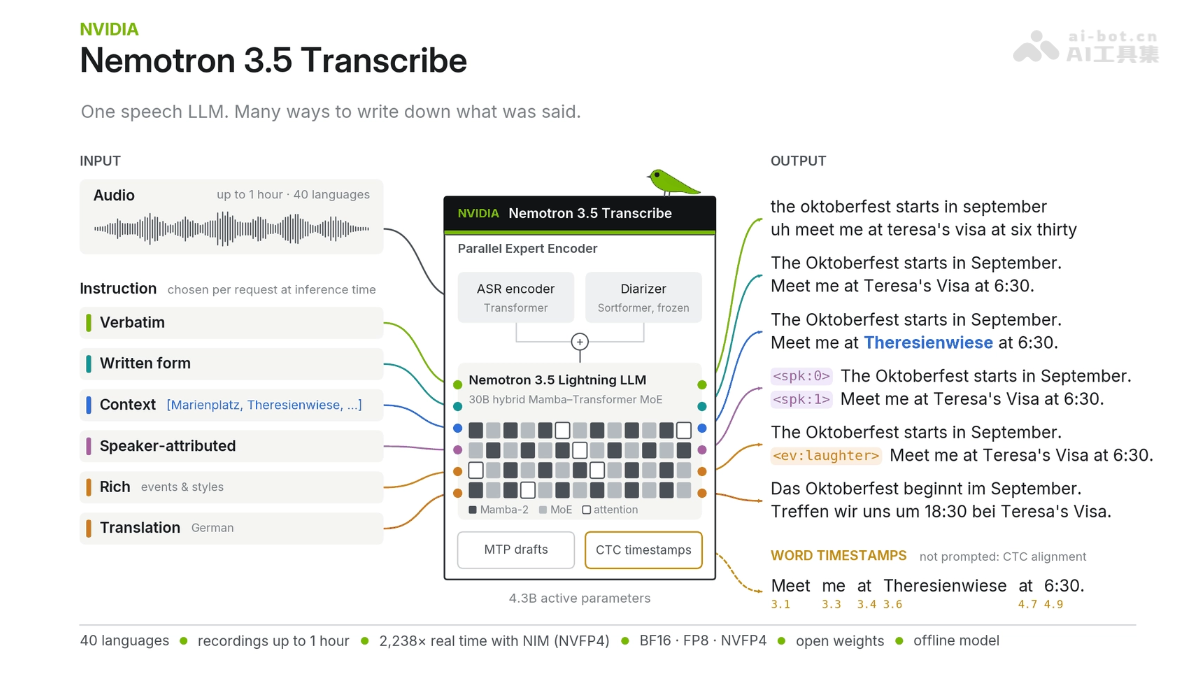
Nemotron 3.5 Transcribe NVIDIA کا تیار کردہ اوپن سورس اسپیچ ماڈل ہے، جو اسپیچ انکوڈر اور MoE architecture استعمال کرتا ہے، تقریباً 4.3 بلین فعال parameters رکھتا ہے، 40 زبانوں کو سپورٹ کرتا ہے، اور زیادہ سے زیادہ 1 گھنٹے کی ایسی ریکارڈنگ پر کارروائی کر سکتا ہے جس میں 8 افراد تک گفتگو کر رہے ہوں۔ یہ لفظ بہ لفظ نقل، مقررین کی شناخت اور ترجمے سمیت متعدد خصوصیات فراہم کرتا ہے۔ Nemotron 3.5 Transcribe قدرتی زبان کی ہدایات کے ذریعے آؤٹ پٹ فارمیٹ کو حسب ضرورت بنانے، fine-tuning کے ذریعے مخصوص شعبوں کے مطابق ڈھالنے اور تجارتی استعمال کی مفت اجازت دیتا ہے۔
02Nemotron 3.5 Transcribe کی اہم خصوصیات
کثیر لسانی نقل: 40 زبانوں کو سپورٹ کرتا ہے، ریکارڈنگ کو متن میں تبدیل کرتا ہے اور گفتگو میں استعمال ہونے والی زبانوں کی شناخت کر سکتا ہے۔
مقررین کی شناخت: زیادہ سے زیادہ 8 مقررین میں فرق کر سکتا ہے اور ہر جملے کو متعلقہ مقرر سے منسوب کرتا ہے، جو اجلاسوں اور متعدد افراد کے انٹرویوز کے لیے موزوں ہے۔
طویل آڈیو پر کارروائی: ایک بار میں تقریباً 1 گھنٹے تک کی ریکارڈنگ پر کارروائی کر سکتا ہے۔
ہدایتی نقل: قدرتی زبان میں آؤٹ پٹ فارمیٹ بتائیں، جیسے لفظ بہ لفظ نقل، تحریری تدوین، تکیا کلام کی صفائی اور اصطلاحات کا مخصوص املا، بغیر دوبارہ training کے۔
اسپیچ ترجمہ: 31 زبانوں اور انگریزی کے درمیان ترجمہ کر سکتا ہے۔
لفظی ٹائم اسٹیمپ: ہر لفظ کی آڈیو میں متعلقہ پوزیشن واپس کرتا ہے، جس سے دوبارہ سننا اور تلاش آسان ہو جاتی ہے۔
شعبہ جاتی fine-tuning: NeMo Speech toolkit کی بنیاد پر ایک GPU پر کم ڈیٹا کے ساتھ مخصوص پیشہ ورانہ منظرناموں کے لیے تیزی سے ڈھالا جا سکتا ہے۔
03Nemotron 3.5 Transcribe کا تکنیکی اصول
WeChat پر فالو کریں اور “开源” کا جواب دے کر AI اوپن سورس پروجیکٹس کے گروپ میں شامل ہوں۔
Speech-Augmented Language Model (SALM): ماڈل تین حصوں پر مشتمل ہے۔ Transformer اسپیچ انکوڈر آڈیو خصوصیات اخذ کرتا ہے، ایک frozen Nemotron 3 speaker diarization ماڈل مقررین کی سرگرمی سے متعلق معلومات فراہم کرتا ہے، اور دونوں مل کر Nemotron 3.5 Lightning 30B-A3B کے ہائبرڈ Mamba-Transformer MoE بڑے زبان ماڈل سے جڑتے ہیں۔ کل parameters تقریباً 34 بلین ہیں، لیکن ہر inference میں صرف تقریباً 4.3 بلین parameters فعال ہوتے ہیں، جس سے صلاحیت اور کارکردگی میں توازن قائم رہتا ہے۔
متوازی expert encoder: frozen diarization ماڈل سے حاصل ہونے والے مقررین کی سرگرمی کے signals کو ASR encoder کی representations میں شامل کیا جاتا ہے۔ اس طرح ماڈل ایک واحد LLM architecture کے تحت کسی تبدیلی کے بغیر مقررین کے لیبل والی نقل تیار کر سکتا ہے، اور اسے serialized output کے ذریعے train کیا جاتا ہے۔
متوازن supervised mixture: training data کو samples کی تعداد کے بجائے جواب کے tokens کی تعداد کے لحاظ سے sample کیا جاتا ہے۔ ہر ASR sample کے ساتھ متعدد task instructions استعمال کی جا سکتی ہیں، اس لیے نئی صلاحیتیں 1% سے بھی کم sampling rate کے ساتھ شامل کی جا سکتی ہیں۔ مکمل training دو مراحل پر مشتمل ہے: supervised fine-tuning اور مختصر reinforcement learning، جس کا دوسرا مرحلہ براہ راست نقل کی درستگی کو بہتر بناتا ہے۔
MTP speculative decoding: training کے دوران model کو multi-token prediction (MTP) objective کے ساتھ مشترکہ طور پر optimize کیا جاتا ہے، اس لیے اس کی اپنی MTP layer براہ راست vLLM speculative decoding کے draft model کے طور پر کام کر سکتی ہے۔ اس کے علاوہ متبادل کے طور پر ایک الگ DFlash2 draft model بھی فراہم کیا گیا ہے۔ دونوں کے امتزاج سے ایک RTX PRO 6000 Blackwell GPU پر فی سیکنڈ 2238 سیکنڈ آڈیو کی throughput حاصل کی جا سکتی ہے۔
CTC timestamp adapter: decoding کے بعد ایک ہلکا CTC adapter generated text کو آڈیو کے ساتھ align کرتا ہے، جس سے طویل آڈیو اور شدید overlapping گفتگو کے لیے مقررین کے لیبل والے لفظی timestamps تیار ہوتے ہیں، جبکہ main model پر اضافی بوجھ نہیں پڑتا۔
04Nemotron 3.5 Transcribe کا استعمال کیسے کریں
ہارڈ ویئر تیار کریں: BF16 ورژن کے لیے تقریباً 80GB VRAM درکار ہے؛ FP8/NVFP4 یا GGUF ورژن کم وسائل کے ساتھ استعمال کیے جا سکتے ہیں۔
ماڈل حاصل کریں: Hugging Face یا 魔搭 پر NVIDIA-Nemotron-3.5-Transcribe-30B-A4B تلاش کریں اور OpenMDW-1.1 لائسنس کے تحت weights ڈاؤن لوڈ کریں۔
ماحول نصب کریں: deployment کے لیے تین میں سے ایک طریقہ منتخب کریں: Nemotron Transcribe NIM (سرکاری container)، vLLM (MTP acceleration کی حمایت کے ساتھ)، یا NeMo-Speech.cpp (GGUF کے ذریعے مقامی execution)۔
آڈیو تیار کریں: زیادہ سے زیادہ 1 گھنٹے کی ریکارڈنگ فائل upload کریں اور استعمال کیے جانے والے framework کے تقاضوں کے مطابق format تبدیل کریں۔
prompt لکھیں: قدرتی زبان میں task بیان کریں، مثلاً ”لفظ بہ لفظ اصل گفتگو برقرار رکھیں اور مقررین کو لیبل کریں“ یا ”تکیا کلام صاف کرکے انگریزی میں ترجمہ کریں“۔
inference چلائیں: آڈیو اور prompt کو API کے ذریعے submit کریں۔ ماڈل نقل شدہ متن واپس کرے گا، اور ضرورت پڑنے پر مقررین کے labels اور لفظی timestamps بھی فراہم کرے گا۔
(اختیاری) فوری تجربہ: deployment نہیں کرنا چاہتے تو Hugging Face پر nvidia/nemotron-transcribe کے Spaces میں آن لائن آزما سکتے ہیں۔
(اختیاری) شعبہ جاتی fine-tuning: NeMo Speech toolkit کے ذریعے labeled data تیار کریں؛ ایک GPU پر تقریباً 0.5–2.3 گھنٹے میں اپنے لہجے، اصطلاحات اور format کے مطابق ماڈل ڈھالا جا سکتا ہے۔
05Nemotron 3.5 Transcribe کے بنیادی فوائد
ہدایتی آؤٹ پٹ: ایک قدرتی زبان کی instruction سے لفظ بہ لفظ نقل، تدوین شدہ متن اور ترجمے جیسی مختلف شکلوں کے درمیان تبدیل کیا جا سکتا ہے، بغیر دوبارہ training یا متعدد models کی configuration کے۔
اعلیٰ نقل کی درستگی: English Open ASR leaderboard پر اوسط WER صرف 4.71% اور multilingual leaderboard پر 4.62% ہے، دونوں میں open-weight models میں سرفہرست ہے۔
مقررین کی شناخت میں برتری: overlapping متعدد افراد کی آوازوں والی labeled transcription میں پہلی بار مخصوص cascading systems سے بہتر کارکردگی دکھاتا ہے، اور 1 گھنٹے اور 8 افراد تک کے scenarios کو سپورٹ کرتا ہے۔
مضبوط context correction: اصطلاحات اور ناموں جیسی entities کی فہرست فراہم کرنے پر named-entity error rate 6 گنا کم ہو سکتا ہے، جس سے professional terms کا اندازہ لگانے کی ضرورت نہیں رہتی۔
مقررین کے labels والے لفظی timestamps: ہلکا CTC alignment نقل کے نتائج کو دوبارہ سننے اور تلاش کرنے کے قابل بناتا ہے، جس سے courses کی replay اور meeting search جیسی applications کو براہ راست support ملتی ہے۔
اعلیٰ inference efficiency: native MTP speculative decoding اور DFlash2 draft model کے ساتھ ایک RTX PRO 6000 فی سیکنڈ 2238 سیکنڈ آڈیو پر کارروائی کر سکتا ہے۔
06Nemotron 3.5 Transcribe کے پروجیکٹ کے روابط
HuggingFace model repository: https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
تکنیکی مقالہ: https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
07Nemotron 3.5 Transcribe کے استعمال کے منظرنامے
اجلاس کی روداد اور فیصلوں کا استخراج: مقررین کو خودکار طور پر الگ کریں، گفتگو کے اصل الفاظ برقرار رکھیں، اور ہدایات کے مطابق اجلاس کے نتائج اور زیر التوا کام اخذ کریں۔
میڈیا انٹرویوز اور خبروں کی تدوین: interviewee کے اصل الفاظ لفظ بہ لفظ برقرار رکھتے ہوئے مقررین کو label کریں، تاکہ quotes درست رہیں، اور ضرورت کے مطابق تکیا کلام صاف کریں۔
کلاس اور training replay: لفظی timestamps کے ساتھ transcript تیار کریں، تاکہ طلبہ keywords تلاش کرکے براہ راست اس وقت پہنچ سکیں جب استاد نے متعلقہ نکتہ سمجھایا تھا۔
طبی اور پیشہ ورانہ شعبوں کے records: terminology list اور domain fine-tuning کے ساتھ ڈاکٹر اور مریض کی گفتگو کو standard format میں medical record کے متن میں تبدیل کریں، جس سے professional vocabulary کی error rate کم ہو۔
کثیر لسانی content localization: 40 زبانوں کی recordings کو براہ راست انگریزی متن میں translate کریں، جسے بین الاقوامی اجلاسوں، انٹرویوز یا video subtitles کے لیے استعمال کیا جا سکتا ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0