

AnyJev کیا کرتا ہے
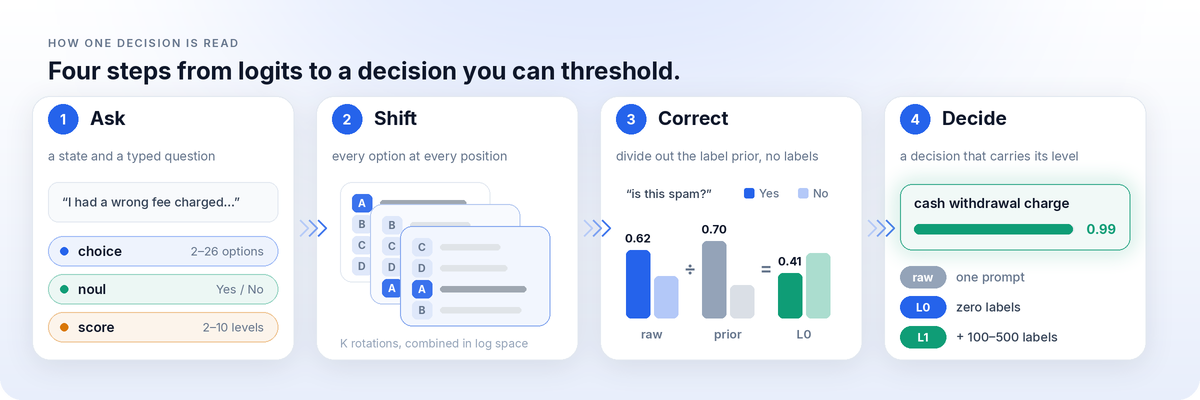
AnyJev ایک اوپن لینگویج ماڈل کو Jev طرز کے فیصلہ سازی ماڈل میں تبدیل کرتا ہے۔ ماڈل سے جواب تیار کروانے اور پھر اس کے متن کو پارس کرنے کے بجائے، AnyJev پری فل سے ماڈل کی اگلے ٹوکن کی تقسیم پڑھتا ہے اور احتمالات کے ساتھ ایک ٹائپ شدہ فیصلہ واپس کرتا ہے۔
یہ ان ورک فلو کے لیے مفید ہے جن میں درخواست کو روٹ کرنا، یہ اندازہ لگانا کہ کوئی کارروائی خطرناک ہے یا نہیں، یا کام کی تکمیل کو اسکور کرنا شامل ہو۔ ہر نتیجے میں استعمال ہونے والی فیصلہ سطح درج ہوتی ہے، جس سے بعد کا کوڈ غیر کیلیبریٹڈ یا زیرو لیبل نتیجے کو فِٹ شدہ ہیڈ سے تیار کردہ نتیجے سے الگ کر سکتا ہے۔
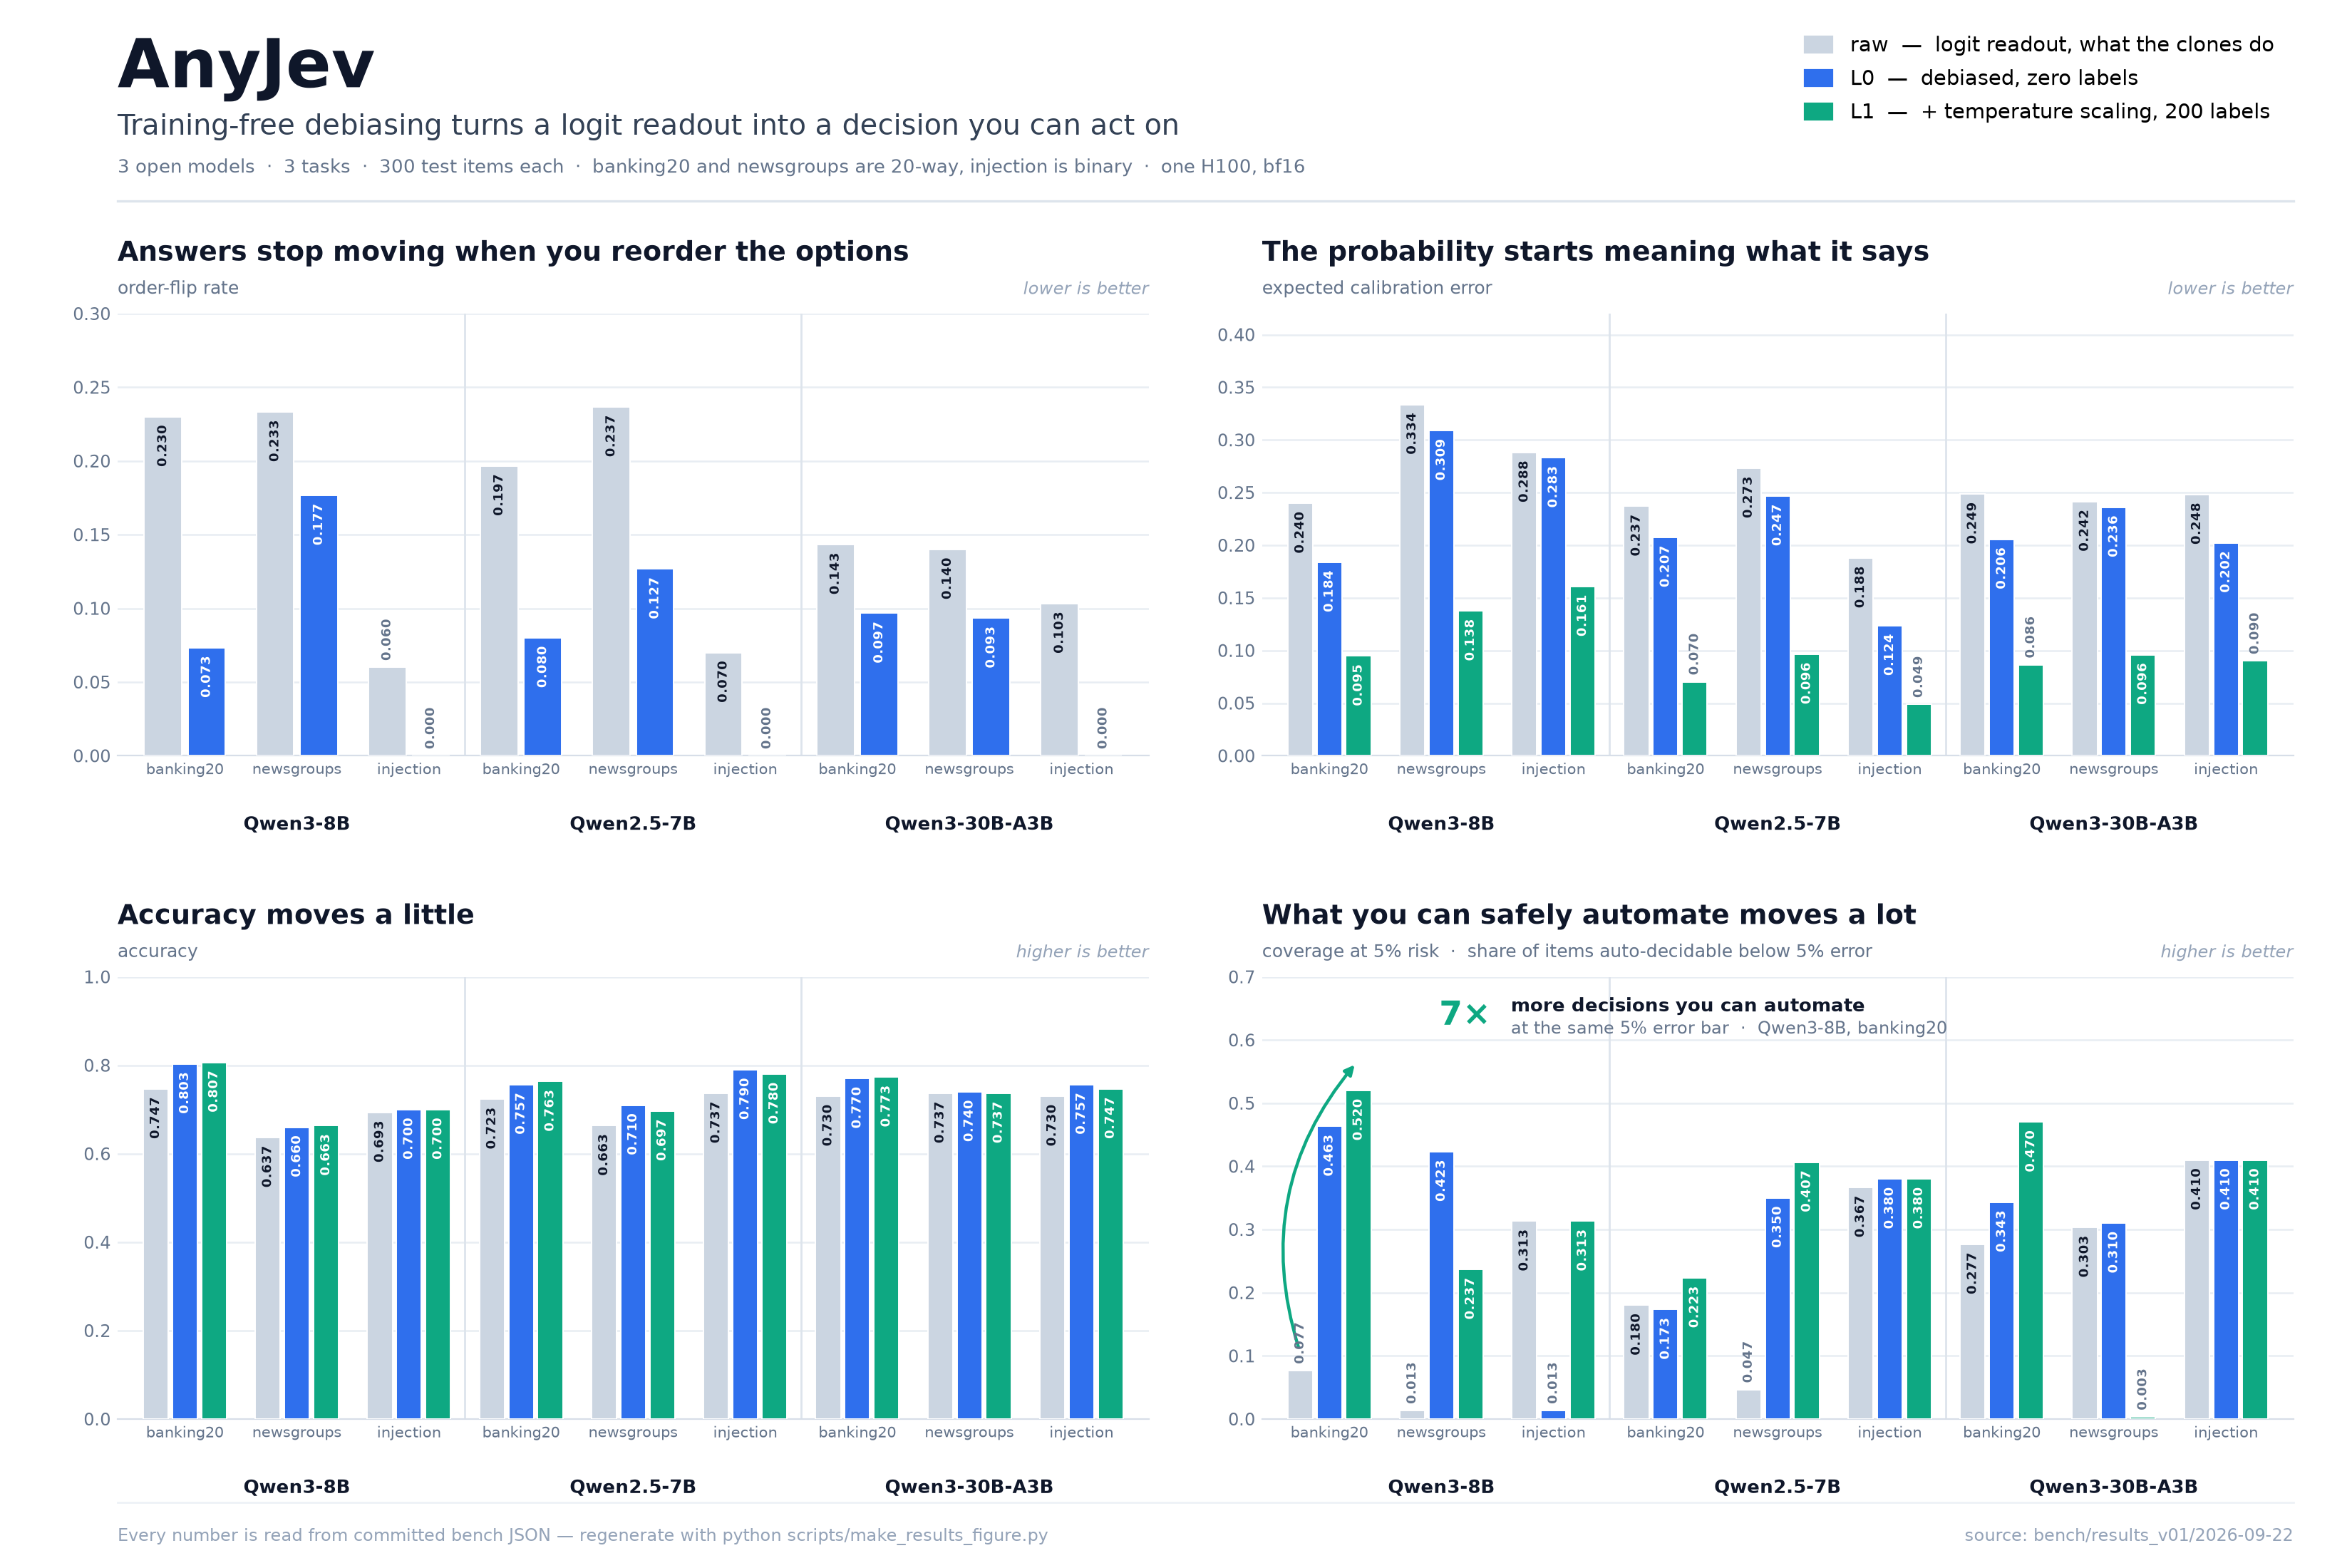
AnyJev خام لاگٹس کے دو عملی مسائل حل کرتا ہے: آپشنز کی ترتیب تبدیل ہونے پر پیش گوئیاں بدل سکتی ہیں، اور خام اعتماد کی قدریں تھریش ہولڈ پر مبنی آٹومیشن کے لیے مناسب طور پر کیلیبریٹڈ نہیں بھی ہو سکتیں۔ README کے Qwen3-8B BANKING77 تجربے میں، L0 نے لیبلز کے بغیر آپشن ترتیب کے بدلنے کی شرح 0.230 سے کم کر کے 0.073 کر دی۔ L1 نے لیبل شدہ مثالوں کے ساتھ متوقع کیلیبریشن خرابی 0.240 سے کم کر کے 0.095 کر دی۔
فیصلہ کی سطحیں
AnyJev مختلف ڈیٹا اور سرونگ تقاضوں کے ساتھ کئی سطحیں فراہم کرتا ہے:
- raw: لیبل ٹوکنز پر محدود softmax لاگو کرتا ہے۔ یہ پوزیشن بائس یا اعتماد کی کیلیبریشن کو درست نہیں کرتا۔
- L0: کسی لیبل کی ضرورت نہیں۔ یہ سائیکلی آپشن گردشوں کا جائزہ لیتا ہے، پوزیشن بائس کا اوسط نکالتا ہے، اور تخمینہ شدہ لیبل prior کو ختم کرتا ہے۔
- L1: L0 پر temperature scaling فِٹ کرنے کے لیے فی سوال تقریباً 100–500 لیبلز استعمال کرتا ہے۔ یہ کیلیبریشن بہتر بناتا ہے، لیکن رینکنگ تبدیل نہیں کرتا۔
- L2: درمیانی hidden state سے shrunk LDA یا ridge ہیڈ حل کرنے کے لیے فی سوال تقریباً 100–300 لیبلز استعمال کرتا ہے۔ اسے مقامی ماڈل درکار ہوتا ہے اور یہ ماڈل اور سوال دونوں کے لیے مخصوص ہوتا ہے۔
کثیر آپشن انتخاب کے لیے L0 کو متعدد prefills درکار ہوتے ہیں کیونکہ یہ گردشوں کا جائزہ لیتا ہے۔ اس کے برعکس L2 ایک prompt استعمال کرتا ہے اور ایک مقررہ intermediate block پر رک جاتا ہے، جس سے رپورٹ کردہ Qwen3 تجربات میں یہ مکمل forward pass سے کم مہنگا بنتا ہے۔
اہم خصوصیات
- ٹائپ شدہ
choice،noul، اورscoreسوالات۔ - متن تیار کرنے یا جواب پارس کرنے کی ضرورت نہیں۔
- آپشن پوزیشن اور لیبل prior کے اثرات کے لیے زیرو لیبل L0 تصحیح۔
- چند سو لیبلز کے ساتھ L1 temperature calibration۔
- گریڈینٹس یا ماڈل fine-tuning کے بغیر سیکنڈز میں فِٹ ہونے والے L2 closed-form ہیڈز۔
level="auto"کے ذریعے L2، L1، یا L0 کا خودکار انتخاب۔observeکے ذریعے بتدریج لیبل جمع کرنا۔- بہت سی states اور ایک سوال کے لیے batch فیصلے۔
- چھوٹے JSON artifacts جنہیں بعد کی سرونگ کے لیے محفوظ اور لوڈ کیا جا سکتا ہے۔
تنصیب اور سیٹ اپ
Hugging Face بیک اینڈ انسٹال کریں
AnyJev کو اس کے Hugging Face انضمام کے ساتھ انسٹال کریں:
pip install "anyjev[hf]"موجودہ ریلیز Transformers پر مبنی anyjev.backends.hf بیک اینڈ کے ذریعے تمام فیصلہ سطحوں کو سر کرتا ہے۔ vLLM اور SGLang سپورٹ روڈمیپ پر ہے اور اس ریلیز میں دستیاب نہیں۔
Decider بنائیں
بنیادی API درآمد کریں اور ایک اوپن ماڈل کے ساتھ HFBackend شروع کریں:
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

decider = Decider(HFBackend("Qwen/Qwen3-8B"))
فراہم کردہ L2 ہیڈز پانچ Qwen3 ماڈلز کا احاطہ کرتے ہیں: 1.7B، 4B، 8B، 30B-A3B، اور 32B۔ L2 ہیڈز اپنے بنیادی ماڈل اور سوال کے لیے مخصوص رہتے ہیں، اس لیے ایک ماڈل یا سوال کے لیے فِٹ کیا گیا ہیڈ خودکار طور پر دوسرے کے لیے دوبارہ استعمال نہیں کیا جا سکتا۔
ٹائپ شدہ سوالات کی وضاحت کریں
ایک سوال آؤٹ پٹ کی قسم، درست جوابات، اور ایک مستحکم نام بیان کرتا ہے۔ آپ ایک ہی application state کے خلاف کئی سوال کی اقسام کا جائزہ لے سکتے ہیں۔
route = Question.choice(
    "Which team should handle this?",
    ["billing", "technical", "sales", "other"],
    name="route",
)

risky = Question.noul(
    "Is this tool call destructive or irreversible?",
    name="risky",
)

done = Question.score(
    "How complete is the task?",
    bins=5,
    name="done",
)
درجہ بند فیصلے کے لیے choice، درست یا غلط فیصلے کے لیے noul، اور حصوں میں تقسیم شدہ عددی اسکور کے لیے score استعمال کریں۔ letter-token readout فی الحال زیادہ سے زیادہ 26 آپشنز کو سپورٹ کرتا ہے۔
بنیادی L0 فیصلہ کریں
L0 ڈیفالٹ ہے اور اسے لیبل شدہ مثالوں کی ضرورت نہیں ہوتی۔ ایسی state بنائیں جس میں سوالات کے لیے درکار معلومات ہوں، پھر decide کال کریں:
state = {
    "conversation": [
        {"role": "user", "content": "I was charged twice."}
    ],
    "tool_call": {
        "name": "refund_payment",
        "arguments": {"payment_id": "pay_123"},
    },
}

result = decider.decide(state, [route, risky, done])

print(result["route"].distribution)
print(result["risky"].p_true)
print(result["done"].value)
print(result.level)
نمونہ route distribution فراہم کردہ ہر آپشن کو ایک احتمال سے منسلک کر سکتی ہے۔ Boolean فیصلوں میں p_true جبکہ score فیصلوں میں value دستیاب ہوتا ہے۔ مجموعی نتیجہ اس وقت L0 رپورٹ کرتا ہے جب کوئی اعلیٰ سطح کا artifact دستیاب نہ ہو۔
احتمالات کی تشریح ان کی سطح کے مطابق کی جانی چاہیے۔ L0 استحکام بہتر بناتا ہے اور تخمینہ شدہ لیبل بائس کو درست کرتا ہے، لیکن غیر یقینی کو مکمل طور پر کیلیبریٹڈ نہیں بناتا۔
L1 کیلیبریشن شامل کریں
اگر آپ کے پاس کسی سوال کے لیے تقریباً 100–500 لیبل شدہ states ہیں، تو L1 temperature فِٹ کرنے کے لیے calibrate کال کریں:
decider.calibrate(risky, states, labels)L1، L0 کے اوپر تیار ہونے والے احتمالات کو کیلیبریٹ کرتا ہے۔ یہ پہلے نمبر پر آنے والے جواب کو تبدیل نہیں کرتا، لیکن اعتماد کے تھریش ہولڈز کو زیادہ معنی خیز بنا سکتا ہے۔
L2 Closed-Form ہیڈ فِٹ کریں
زیادہ درستگی کے لیے، تقریباً 100–300 لیبل شدہ مثالوں کا استعمال کرتے ہوئے سوال کے لیے مخصوص L2 ہیڈ فٹ کریں:
decider.fit_head(route, states, labels)

decider.save_artifacts("qwen3-8b.json")
فٹنگ مثالوں پر ماڈل کا ایک پاس چلاتی ہے اور پھر ہیڈ کو بند شکل میں حل کرتی ہے۔ یہ گریڈیئنٹس استعمال نہیں کرتی اور زبان کے ماڈل کے وزن تبدیل نہیں کرتی۔ پروجیکٹ کے مطابق، ایک ہیڈ عموماً تقریباً 100 KB کا ہوتا ہے اور چھوٹے معاون Qwen3 ماڈلز کے لیے اسے چند سیکنڈز میں حل کیا جا سکتا ہے۔
محفوظ کیے گئے آرٹیفیکٹس کو بعد کے عمل میں لوڈ کریں، پھر خودکار سطح کے انتخاب کی درخواست کریں:
decider.load_artifacts("qwen3-8b.json")

result = decider.decide(state, [route], level="auto")
print(result["route"].level)
level="auto" کے ساتھ AnyJev L2 استعمال کرتا ہے، جب کوئی مطابقت رکھنے والا ہیڈ سوال کو روٹ کر سکتا ہو۔ بصورتِ دیگر، اگر کیلیبریشن دستیاب ہو تو یہ L1 پر، اور پھر L0 پر واپس آ جاتا ہے۔
لیبلز بتدریج جمع کریں
AnyJev جائزہ قطار، مشاہدہ شدہ نتائج، یا کسی اور فیڈبیک ذریعے سے موصول ہونے والے لیبلز قبول کر سکتا ہے:
decider.observe(route, state, correct_label)پروجیکٹ کا خودکار لوپ 30 مشاہدات پر ہیڈ حل کرتا ہے، پھر 60، 120، اور اس کے بعد آنے والے سنگِ میلوں پر اسے دوبارہ حل کرتا ہے۔ اس سے ایسا تعیناتی لائف سائیکل ممکن ہوتا ہے جس میں نیا سوال L0 سے شروع ہو اور کافی فیڈبیک جمع ہونے کے بعد L2 پر منتقل ہو جائے۔
بیچ انفرنس
ایک سوال کو متعدد حالتوں پر لاگو کرتے وقت decide کو بار بار کال کرنے کے بجائے بیچ API استعمال کریں:
results = decider.decide_batch(states, route)ایک ہی ٹائپ شدہ سوال کے خلاف متعدد ان پٹس پر کارروائی کے لیے یہی مطلوبہ انٹرفیس ہے۔
پیکیج شدہ ڈیمو آزمائیں
ریپوزٹری کے چیک آؤٹ سے مصنوعی ڈیمو چلائیں، اس کے لیے ماڈل ڈاؤن لوڈ کرنے کی ضرورت نہیں:
python -m demo.jev_mode --backend fakeتعیناتی لائف سائیکل کی نقالی کرنے کے لیے لائف سائیکل آپشن شامل کریں:
python -m demo.jev_mode --backend fake --lifecycleشپ کیے گئے ہیڈز کے ساتھ حقیقی Qwen3 ڈیمو چلانے کے لیے --backend fake ہٹا دیں۔
اعلیٰ درجے کی تعیناتی کی تجاویز
سوال کی شناخت مستحکم رکھیں
L2 ہر سوال اور ماڈل کے لیے الگ فٹ کیا جاتا ہے۔ نئے آپشن سیٹ کے لیے نئے لیبلز اور نیا ہیڈ درکار ہوتا ہے۔ اسی سوال کو نئے الفاظ میں لکھنے یا انہی آپشنز کی ترتیب تبدیل کرنے سے موجودہ ہیڈ کی طرف روٹنگ ہو سکتی ہے۔
الفاظ میں مطابقت کے لیے بغیر لیبل والا ٹریفک استعمال کریں
نئے الفاظ میں لکھے گئے سوالات کے لیے AnyJev تقریباً 30 بغیر لیبل والی درخواستوں کا استعمال کرتے ہوئے ہیڈ کے فیچر اوسط اور اسکیل کو دوبارہ مرکز کر سکتا ہے۔ یہ موافقت سوال کے الفاظ اور آپشنز کی ترتیب پر لاگو ہوتی ہے؛ یہ خود ایپلیکیشن کی حالتوں میں تبدیلی کا پتا نہیں لگاتی۔
حقیقی ڈیٹا میں تبدیلی کی نگرانی کریں
چونکہ حالتوں کی تقسیم میں تبدیلیاں دوبارہ مرکز کرنے والے طریقۂ کار سے پوشیدہ رہتی ہیں، اس لیے وقفے وقفے سے لیبل کیا گیا جائزہ حصہ محفوظ رکھیں اور کارکردگی کی نمونہ جاتی جانچ کریں۔ الفاظ کی موافقت کو پروڈکشن مانیٹرنگ کا متبادل نہ سمجھیں۔
فیصلے کی سطح کے مطابق کارروائیوں کی اجازت دیں
ہر فیصلے کے ساتھ اس کی سطح شامل ہوتی ہے۔ حساس کارروائی انجام دینے سے پہلے ڈاؤن اسٹریم سسٹمز اسے جانچ سکتے ہیں، اور پروجیکٹ require= کے ذریعے سطحوں کے نفاذ کو بھی سپورٹ کرتا ہے۔ اس سے ایسا ورک فلو رک جاتا ہے جو کیلیبریٹڈ یا L2 فیصلوں کے لیے بنایا گیا ہو، مگر خاموشی سے فال بیک نتیجے پر کارروائی کرے۔
تھریش ہولڈز کا انتخاب صرف توثیق کے بعد کریں
کیلیبریشن کا بنیادی فائدہ یہ ہے کہ زیادہ اعتماد والے معاملات خودکار نظام کو بھیجے جا سکتے ہیں، جبکہ غیر یقینی معاملات کو آگے بڑھایا جا سکتا ہے۔ نمائندہ لیبل شدہ ڈیٹا پر تھریش ہولڈز منتخب کریں اور حاصل ہونے والی غلطی اور کوریج کی پیمائش کریں، بجائے اس کے کہ دکھائی گئی احتمال کو خودکار طور پر قابلِ اعتماد سمجھ لیا جائے۔
اہم حدود
- L2 ہیڈز کسی مختلف سوال یا بنیادی ماڈل میں منتقل نہیں ہوتے۔
- موجودہ پروجیکٹ ریلیز کے ساتھ صرف Qwen3 ہیڈز فراہم کیے جاتے ہیں۔
- L2 کے لیے پوشیدہ حالتوں تک رسائی درکار ہے، جو فی الحال Transformers بیک اینڈ کے ذریعے فراہم کی جاتی ہے۔
- کیلیبریشن کسی ایسے کام کو حل کرنے کے قابل ماڈل نہیں بنا سکتی جس کا جواب دینا وہ بنیادی طور پر نہیں جانتا۔
- جب بیچ کے سابقہ میں ایک لیبل کا غلبہ ہو تو L0 درستگی کم کر سکتا ہے۔
- موجودہ حرفی ریڈ آؤٹ زیادہ سے زیادہ 26 آپشنز کو سپورٹ کرتا ہے۔
- رپورٹ کیا گیا 5% رسک کوریج تخمینہ 300 مثالوں پر مبنی ہے، اس لیے اس میں زیادہ تغیر ہے۔
- رپورٹ شدہ ٹائپ شدہ فیصلوں کی درستگی استاد LLM کے ساتھ مطابقت کی پیمائش کرتی ہے، آزادانہ طور پر قائم کردہ گراؤنڈ ٹروتھ کی نہیں۔
- رپورٹ شدہ فیصلوں کا جائزہ مکمل ایجنٹ لوپ کے اندر نہیں بلکہ الگ تھلگ حالت میں لیا گیا۔
نتیجہ
AnyJev صفر لیبل والے ٹائپ شدہ فیصلوں سے کیلیبریٹڈ احتمالات اور مؤثر پوشیدہ حالت والے ہیڈز تک ایک عملی پیش رفت فراہم کرتا ہے۔ L0 سے آغاز کریں، حقیقی لیبلز جمع کریں، کیلیبریشن ترجیح ہو تو L1 شامل کریں، اور زیادہ درست سوال مخصوص فیصلہ سازی کے راستے کی ضرورت ہو تو L2 فٹ کریں۔ رپورٹ شدہ سطح محفوظ رکھیں، تھریش ہولڈز کی توثیق کریں، اور پروڈکشن ڈیٹا تبدیل ہونے پر لیبل شدہ نمونوں کی نگرانی کریں۔
عمل درآمد کی تفصیلات اور موجودہ منصوبوں کے لیے AnyJev ریپوزٹری، اس کے لیولز کنٹریکٹ، بینچ مارک دستاویزات، اور روڈ میپ دیکھیں۔