

DeepInfer-SM80 کیا ہے؟
DeepInfer-SM80 آپٹمائزڈ Python، Triton، اور TileLang ماڈیولز کا مجموعہ ہے، جو vLLM V1 انجن کے ذریعے NVIDIA Ampere GPUs پر DeepSeek-V4.1 چلانے کے لیے بنایا گیا ہے۔ یہ DeepSeek کے DeepInfer کے بنیادی تصورات کو منتقل کرتا ہے، جو NVIDIA Blackwell کو ہدف بناتا ہے، اور Ampere ہارڈویئر کی صلاحیتوں کے مطابق اہم execution path کو ازسرنو ڈیزائن کرتا ہے۔
Blackwell کی مخصوص خصوصیات، جیسے tcgen05 warp-group instructions، Tensor Memory، hardware UE8M0 scale instructions، اور فی streaming multiprocessor 228 KB shared memory پر انحصار کرنے کے بجائے، یہ پروجیکٹ Ampere کے mma.sync.aligned.m16n8k16 Tensor Cores، SM-aware scheduling، integer-bitshift UE8M0 decoding، اور YOCO shared-KV reuse استعمال کرتا ہے۔
یہ پروجیکٹ A100 اور A800 جیسے data-center SM80 GPUs کے علاوہ RTX 3090، RTX 3090 Ti، RTX A6000، A40، A10، اور A30 سمیت SM86 devices کو بھی سپورٹ کرتا ہے۔ اس کے kernels فی CTA 48 KB سے زیادہ shared memory استعمال نہیں کرتے، جس سے وہ SM86 devices کی کم shared-memory حدود میں بھی چل سکتے ہیں۔
اسے کیوں استعمال کریں؟
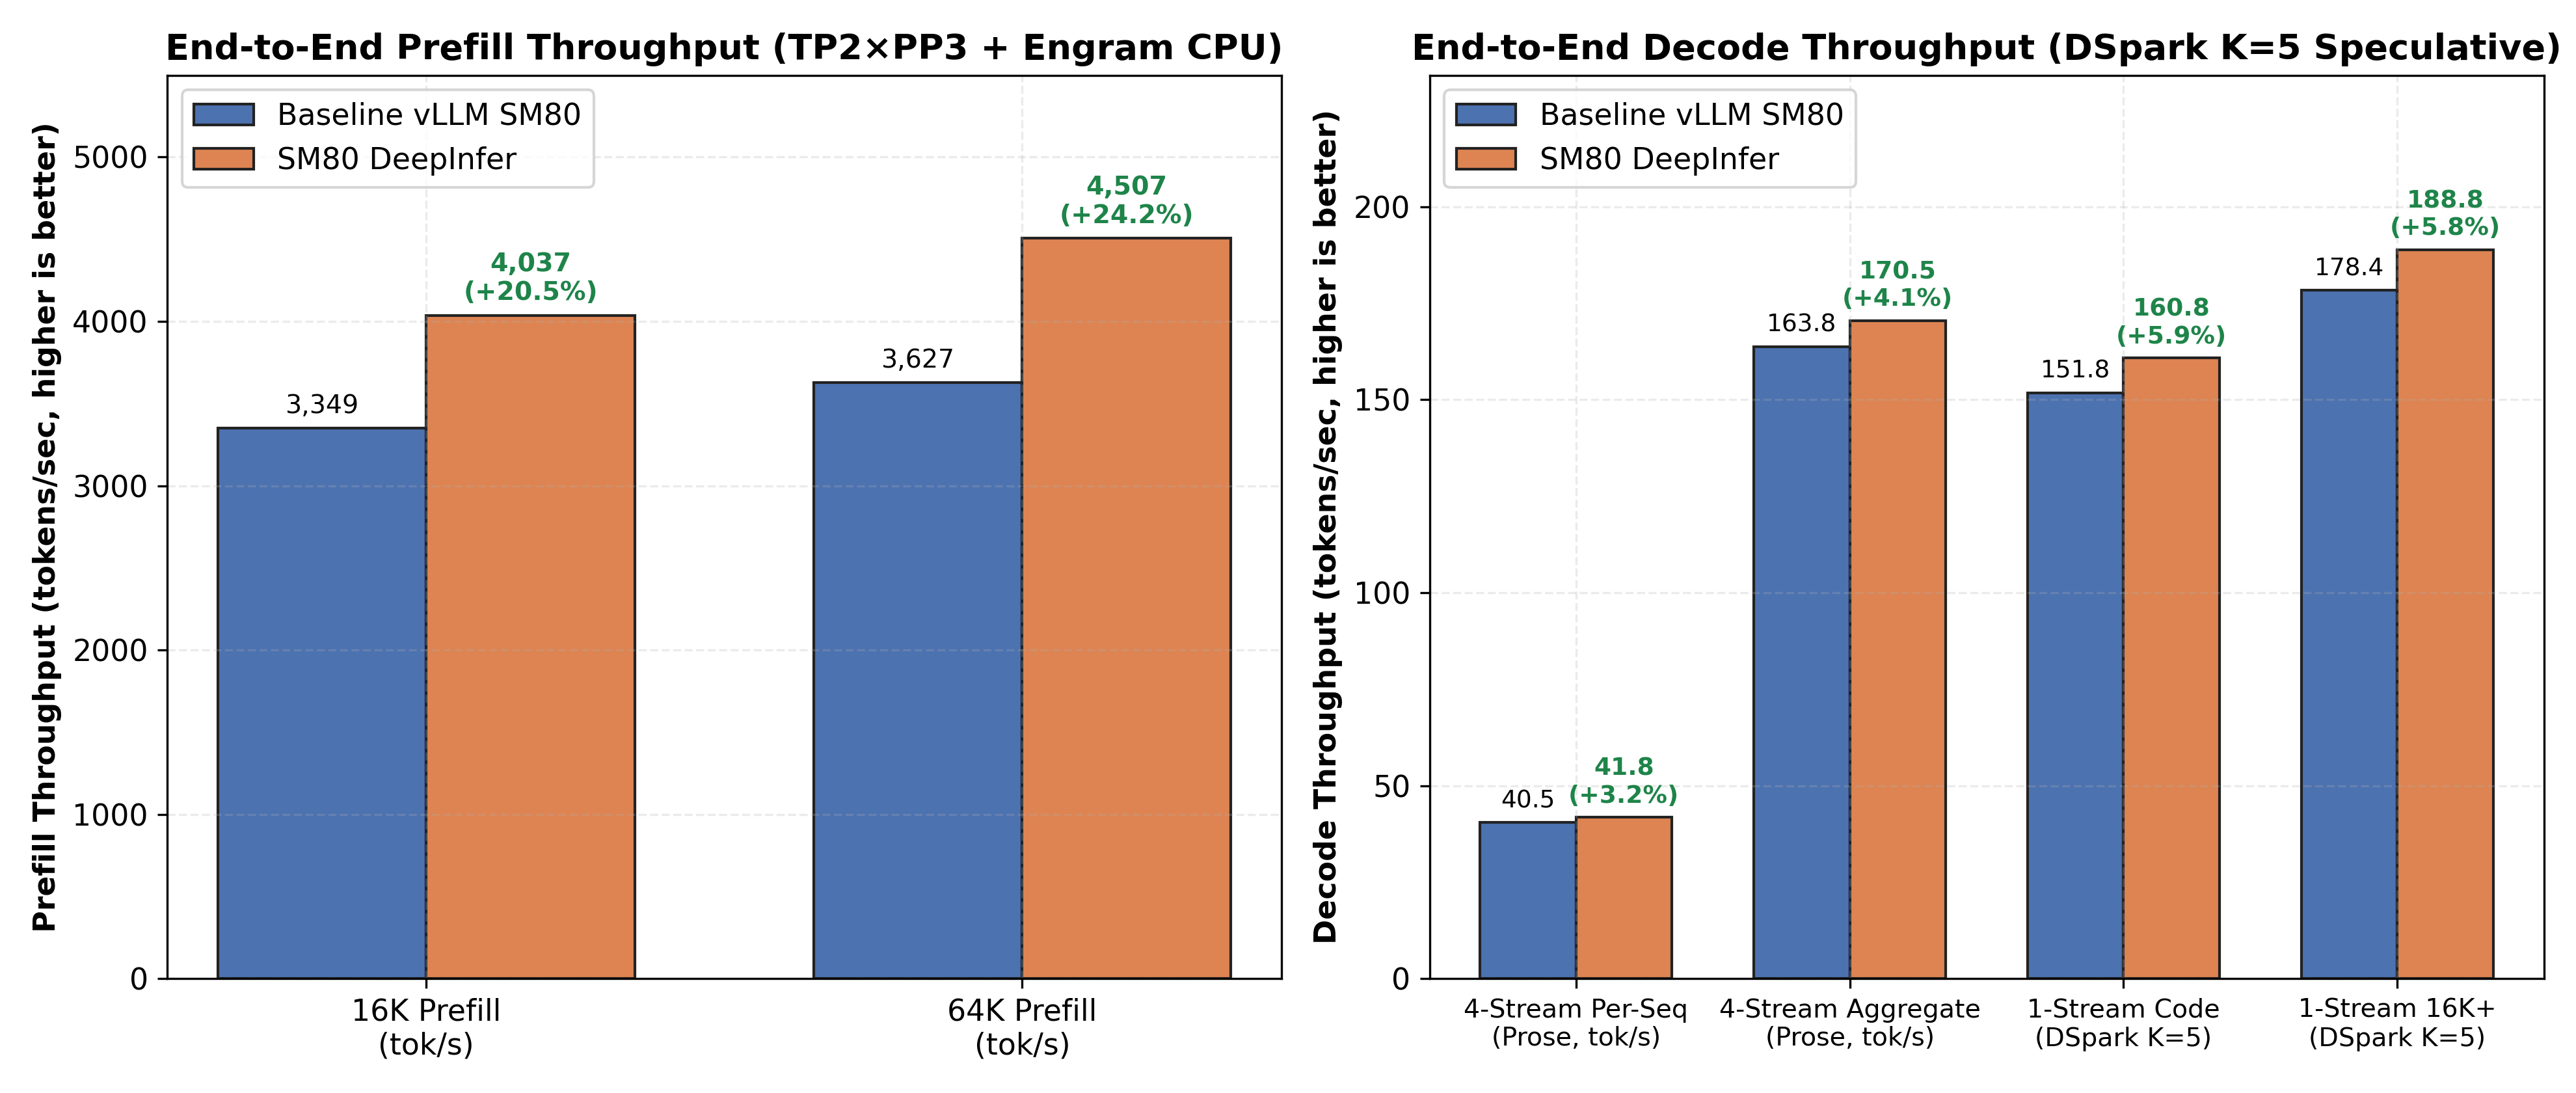
DeepInfer-SM80، DeepSeek-V4.1 prefill، sparse attention، KV-cache access، residual routing، اور long-context inference سے متعلق مہنگے operations پر توجہ دیتا ہے۔ repository کے مطابق، چھ GA100 64 GB GPUs، TP2 × PP3، K=5 کے ساتھ DSpark speculative decoding، اور 1,048,576 tokens کی زیادہ سے زیادہ context length والی production configuration میں نتائج یہ ہیں:
- 16K cold prefill: 4,037.0 tokens فی سیکنڈ، جو پہلے 3,349.4 tokens فی سیکنڈ تھا۔
- 64K cold prefill: 4,506.8 tokens فی سیکنڈ، جو پہلے 3,627.3 tokens فی سیکنڈ تھا۔
- 64K time to first token: 10.7 سیکنڈ، جو پہلے 13.2 سیکنڈ تھا۔
- Four-stream speculative decode: مجموعی طور پر 170.5 tokens فی سیکنڈ، جبکہ پہلے 163.8 tokens فی سیکنڈ تھے۔
- Single-stream Python-code decode: 160.8 tokens فی سیکنڈ، جبکہ پہلے 151.8 tokens فی سیکنڈ تھے۔
- GPU-resident KV capacity: 4,648,480 tokens، baseline کے مقابلے میں VRAM کے اضافی استعمال کے بغیر۔
یہ پیمائشیں repository کے آزمودہ ہارڈویئر اور serving configuration کو بیان کرتی ہیں۔ دیگر Ampere GPUs، model configurations، workloads، یا vLLM environments پر نتائج مختلف ہو سکتے ہیں۔
اہم آپٹمائزیشنز
متحدہ 512-طُولی Sparse MLA
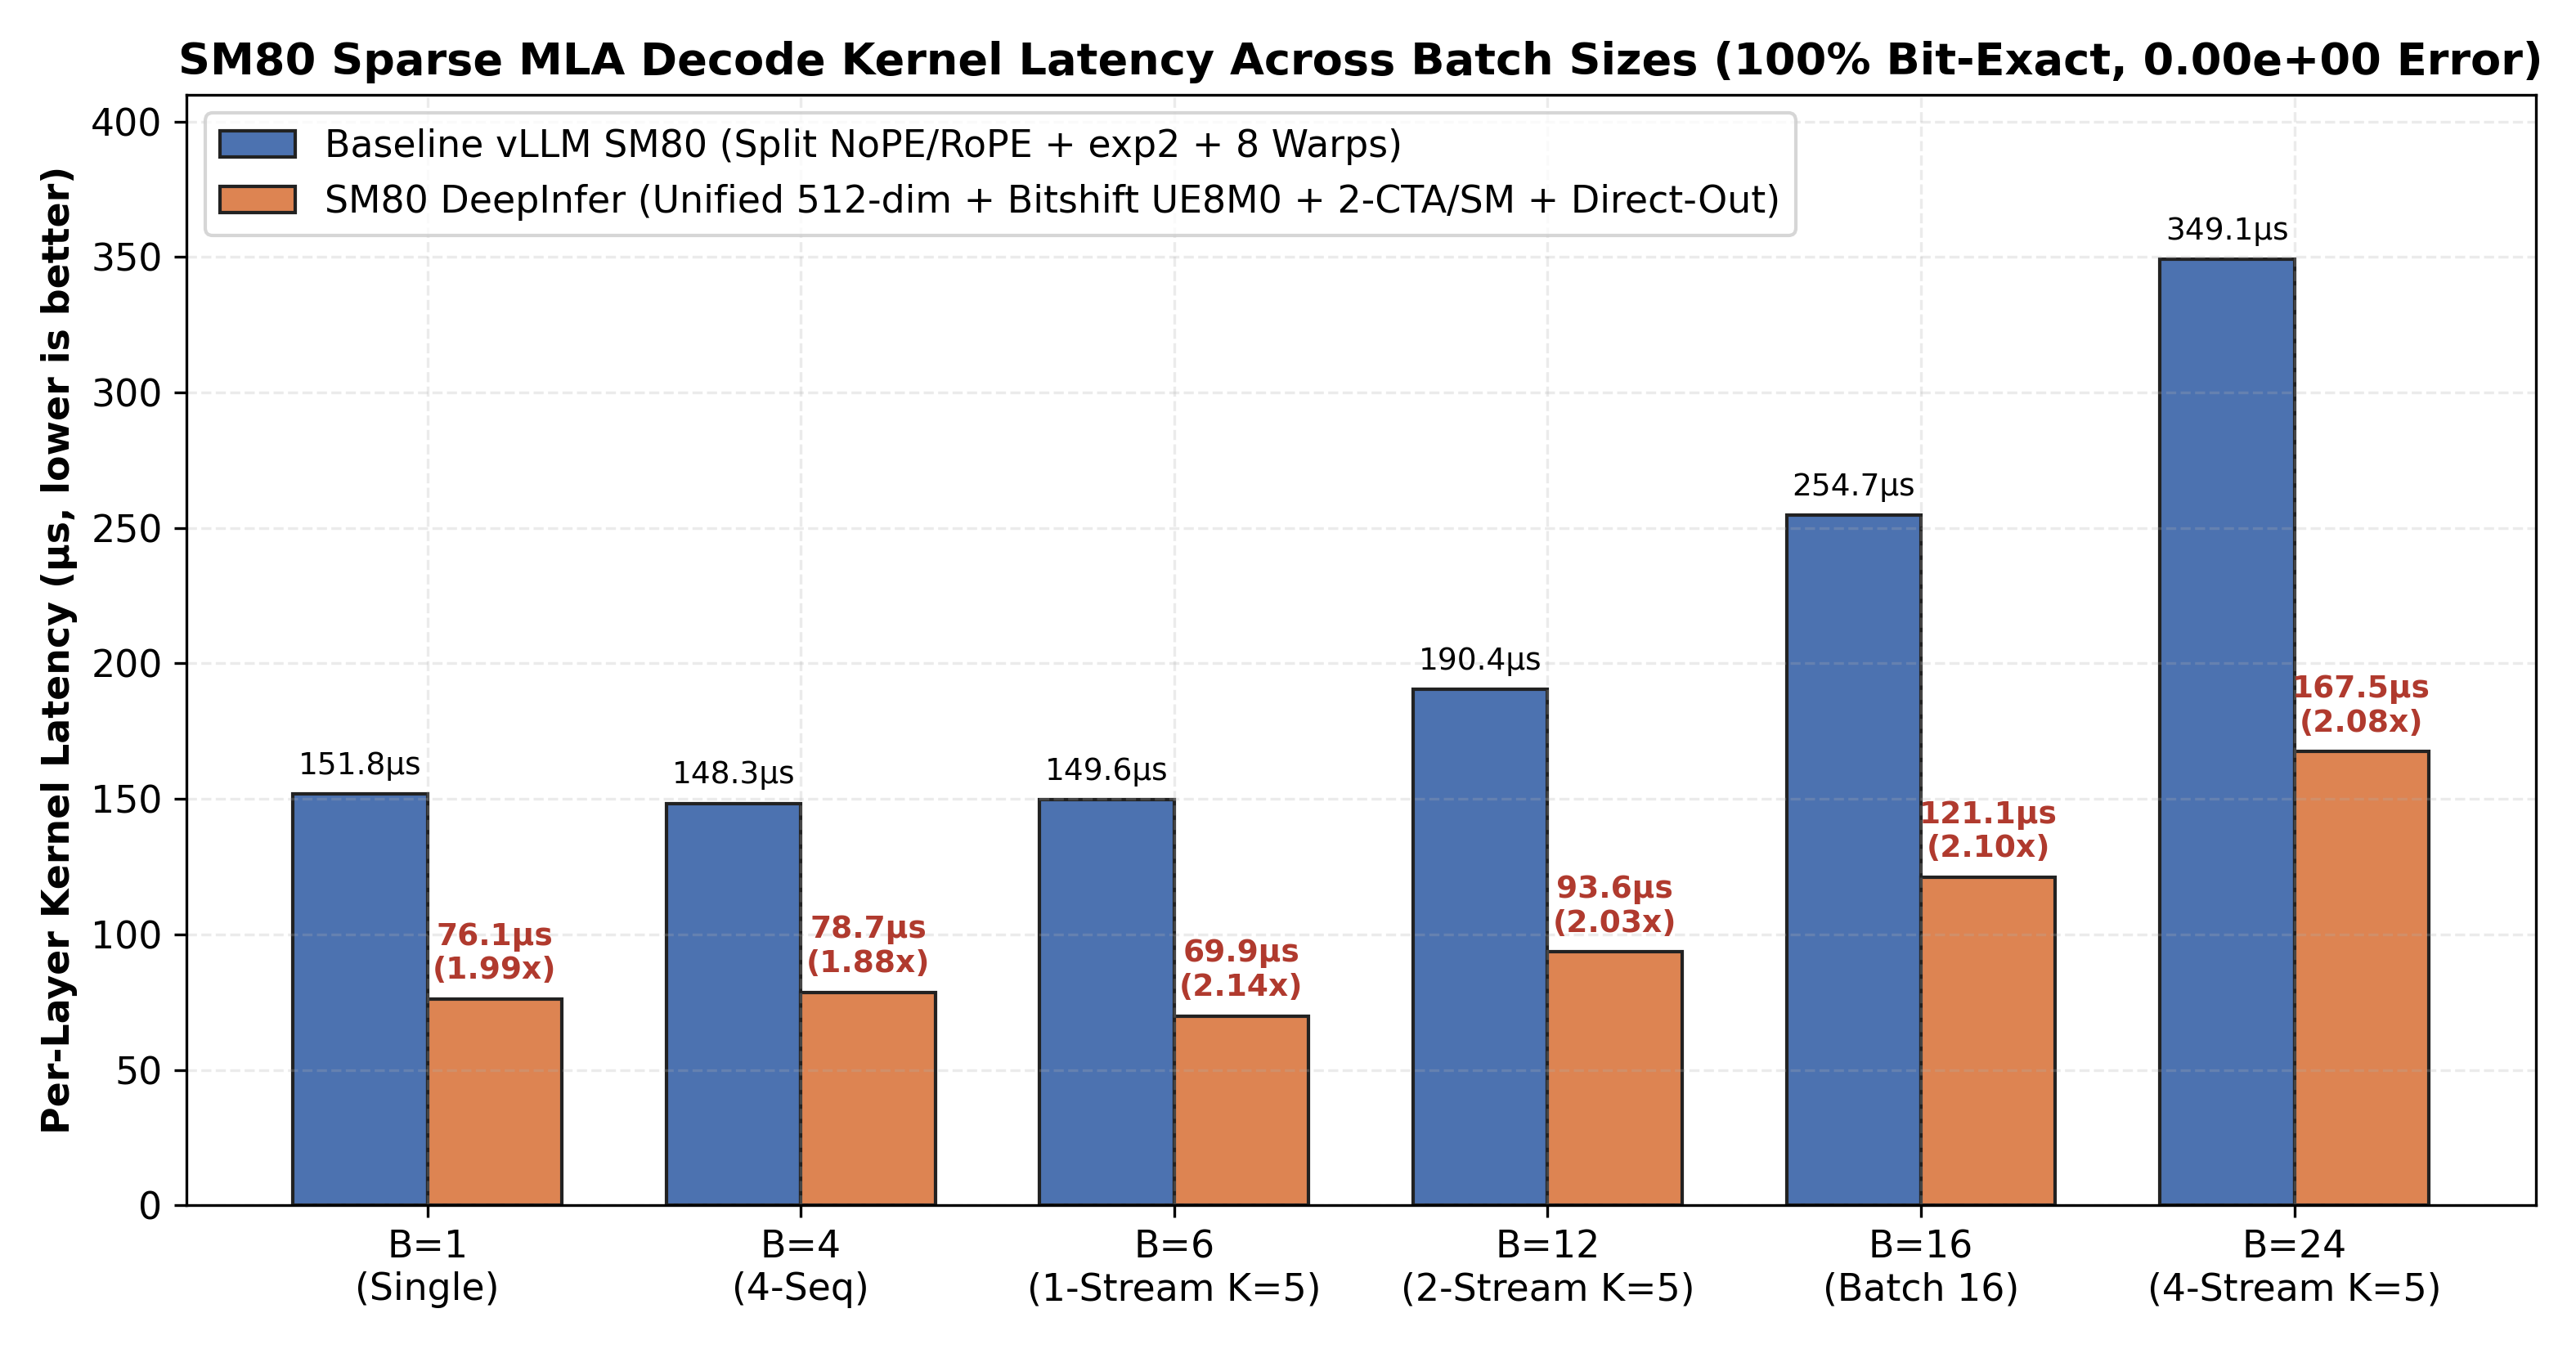
DeepSeek-V4.1 کی DeepSelect sparse attention، 448-طُولی NoPE latent کو float8_e4m3fn میں، UE8M0 power-of-two block scales کے ساتھ، اور 64-طُولی BF16 RoPE suffix کے ساتھ محفوظ کرتی ہے۔ DeepInfer-SM80 مکمل 512-طُولی tile لوڈ کرتا ہے اور NoPE اور RoPE حصوں کو الگ الگ handle کرنے کے بجائے ایک ہی Tensor Core dot-product path سے process کرتا ہے۔
یہ kernel exp2-based UE8M0 conversion کی جگہ IEEE-754 integer bitshift استعمال کرتا ہے:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)درست UE8M0 exponents کے لیے یہ bit-identical FP32 scale values پیدا کرتا ہے، جبکہ کام کو transcendental operations سے integer pipeline میں منتقل کر دیتا ہے۔
tuned configuration میں BLOCK_N=64، num_warps=4، اور num_stages=2 استعمال ہوتے ہیں۔ register pressure کم کرنے سے ہر SM80 streaming multiprocessor پر دو CTAs رہ سکتے ہیں۔ جب num_kv_splits == 1 ہو، kernel براہِ راست final output میں لکھتا ہے اور الگ reduction stage شروع کرنے سے بچتا ہے۔
Single-CTA Top-K اور SWA Index کا امتزاج
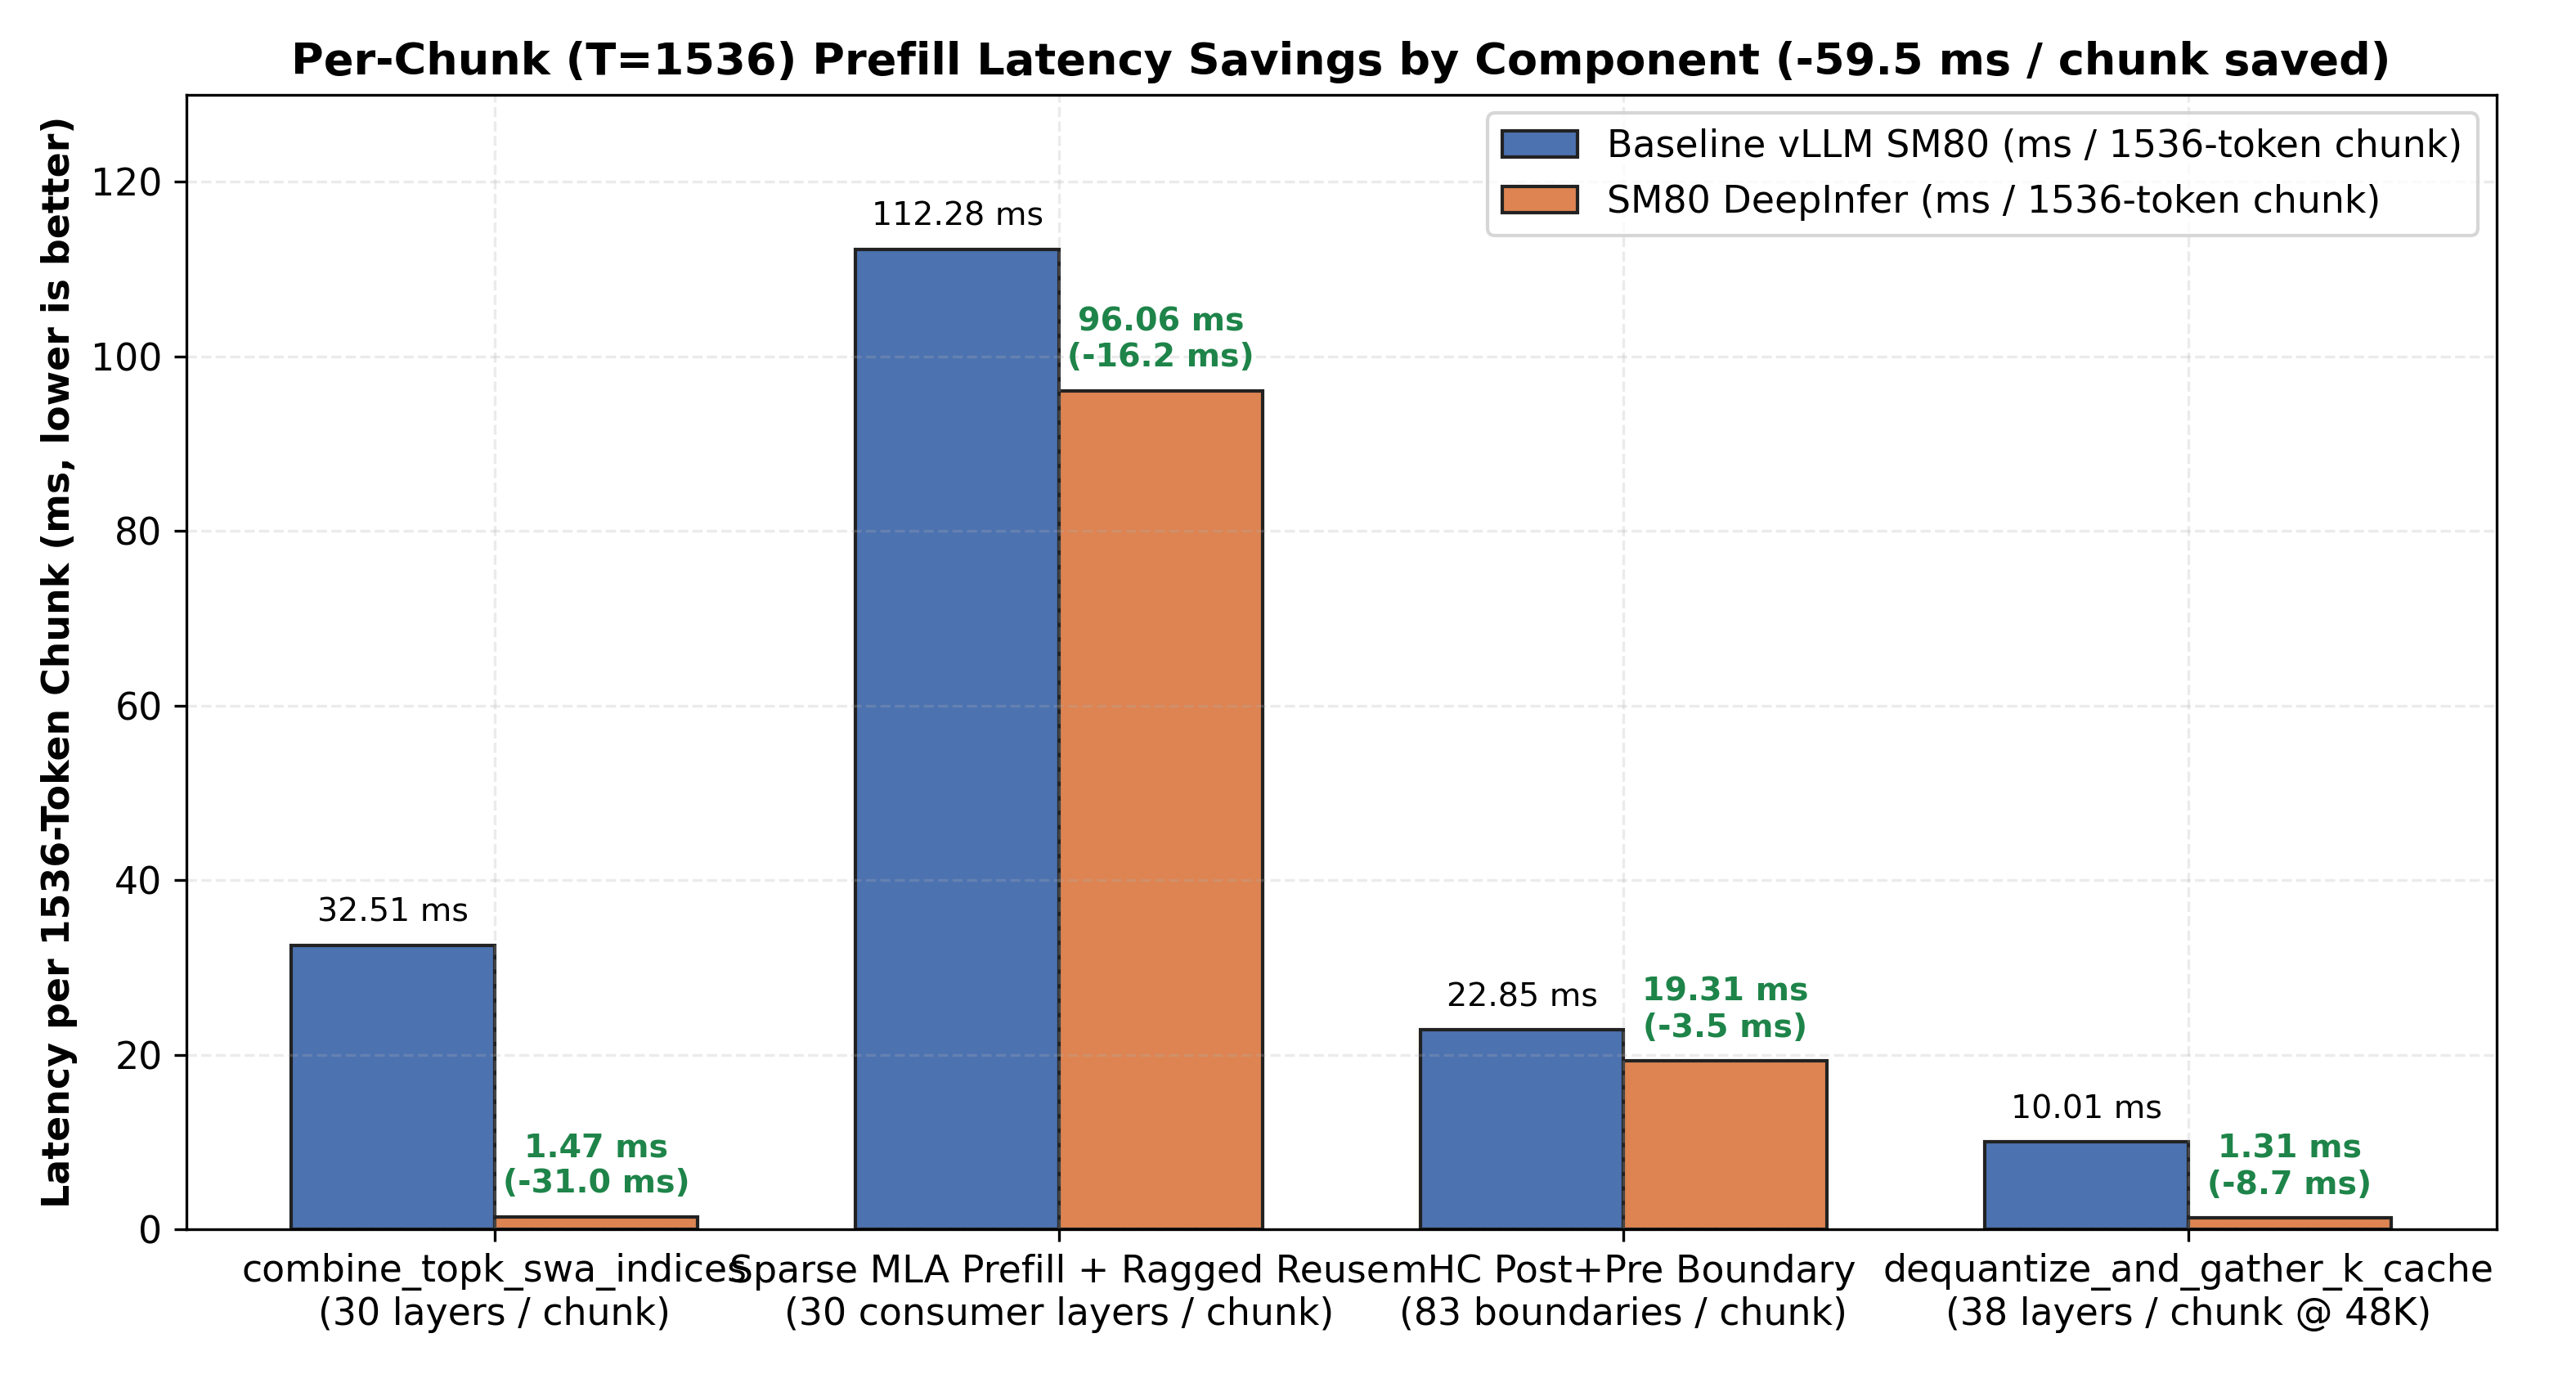
آپٹمائزڈ _combine_topk_swa_indices_kernel، PyTorch allocations اور operations کی ایک پوری ترتیب کو ایک Triton kernel سے بدل دیتا ہے، جو ہر query token کے لیے ایک CTA استعمال کرتا ہے۔ T=1536 پر measured latency 1,083.72 microseconds سے کم ہو کر 48.88 microseconds رہ جاتی ہے، یعنی 22.17× speedup۔
inter-warp write races سے بچنے کے لیے ہر output row کو تین الگ regions میں تقسیم کیا جاتا ہے:
- compressed Top-K indices
[0, topk_len)میں ہوتے ہیں۔ - sliding-window attention indices
[topk_len, topk_len + swa_len)میں ہوتے ہیں۔ - باقی columns کو
-1سے pad کیا جاتا ہے۔
README کے مطابق، 0، 1، اور 2 کے compression ratios اور آزمودہ تمام sequence lengths پر output bit-exact ہے۔
dequantize_and_gather_k_cache path بھی bitshift-based UE8M0 conversion استعمال کرتا ہے۔ یہ Triton kernel کو فراہم کردہ destination strides کے ذریعے براہِ راست لکھتا ہے، جس سے درمیانی torch.empty allocations اور بعد کی .copy_() operations ختم ہو جاتی ہیں۔
measured speedup، 16K context پر 4.02× اور 48K context پر 7.64× ہے، جبکہ رپورٹ کردہ tests میں reference سے bit-exact matches ملے۔
SM80-Tuned mHC Residual Routing
DeepSeek-V4.1 ہر forward pass میں 83 boundaries پر four-stream manifold-constrained hyper-connection routing انجام دیتا ہے۔ DeepInfer-SM80 model کے 5,120 hidden size کے لیے aligned (6, 8, 128) split geometry شامل کرتا ہے۔ آٹھ slices میں سے ہر ایک 640 elements پر مشتمل ہے، جو 128 سے تقسیم ہو جاتا ہے۔
یہ پروجیکٹ small-matrix threshold کو 32 سے کم کر کے 16 بھی کرتا ہے، تاکہ کم از کم 16 tokens والے token counts Tensor Core T.gemm path استعمال کر سکیں۔ رپورٹ کردہ mhc_fused_post_pre_delayed speedup، T=12 پر 2.89× اور T=6 پر 1.30× ہے۔
YOCO Metadata Reuse
DeepSeek-V4.1 کے You-Only-Cache-Once architecture میں layers 21 سے 39، layer 20 کے full-resolution KV cache سے پڑھتی ہیں۔ یہ consumers ایک ہی expanded sequence lengths، block table، اور compression ratio شیئر کرتے ہیں۔
DeepInfer-SM80، layer 20 کو process کرتے وقت ragged K metadata کو vLLM forward context میں محفوظ کرتا ہے۔ layers 21 سے 39 کے لیے اس data کو دوبارہ استعمال کرنے سے ہر prefill chunk میں metadata بنانے والی GPU kernel chains کے 19 غیر ضروری دور ختم ہو جاتے ہیں۔
انسٹالیشن سے پہلے
آپ کو vLLM V1 environment درکار ہے جو supported NVIDIA Ampere GPU پر DeepSeek-V4.1 چلا سکے۔ repository ایک unified patch اور چھ replacement modules فراہم کرتی ہے، لیکن README میں CUDA، Python، Triton، TileLang یا vLLM کے exact version numbers مقرر نہیں کیے گئے۔ ایسا vLLM checkout استعمال کریں جو patch اور آپ کی موجودہ DeepSeek-V4.1 deployment کے ساتھ compatible ہو۔
Supported hardware groups یہ ہیں:
- SM80 data-center GPUs: A100 40 GB، A100 80 GB، GA100 64 GB، اور A800 40 GB یا 80 GB۔
- SM86 workstation اور consumer GPUs: RTX 3090، RTX 3090 Ti، RTX A6000، A40، A10، اور A30۔
یہ software Apache License 2.0 کے تحت تقسیم کیا جاتا ہے۔
انسٹالیشن آپشن A: Unified Patch لاگو کریں
یہ طریقہ vLLM source checkout میں تمام چھ modified files لاگو کرتا ہے۔ اس checkout کی root directory میں terminal کھولیں اور چلائیں:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patch/path/to/Deepinfer-SM80 کو cloned یا downloaded project کے location سے بدلیں۔ اس patch میں sparse MLA، cache-gather، Top-K plus SWA، mHC، warmup، اور YOCO metadata-reuse changes شامل ہیں۔
انسٹالیشن آپشن B: Drop-In Modules انسٹال کریں
اگر آپ کے environment میں files کو براہِ راست replace کرنا زیادہ مناسب ہو، تو project کے vLLM module tree کو installed vLLM package پر copy کریں:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm//path/to/site-packages/vllm/ کو اصل vLLM package directory سے بدلیں۔ Docker deployment میں یہی files read-only overlays کے طور پر bind-mount بھی کی جا سکتی ہیں۔
Drop-in tree ان functional areas میں تبدیلی کرتا ہے:
model_executor/kernels/mhc/TileLang mHC execution اور warmup کے لیے۔models/deepseek_v4_1/amd/rocm.pyTriton Top-K اور SWA combiner کے لیے۔models/deepseek_v4_1/common/ops/cache_utils.pyKV-cache gathering کے لیے۔models/deepseek_v4_1/nvidia/model.pyYOCO metadata reuse کے لیے۔v1/attention/ops/rocm_aiter_mla_sparse.pyunified sparse MLA kernels کے لیے۔
اگرچہ دو optimized files کے paths میں
rocmیاamdبرقرار ہے، repository انہیں واضح طور پر Ampere-targeted vLLM integration کے حصے کے طور پر استعمال کرتی ہے۔ Drop-in files لاگو کرتے وقت فراہم کردہ directory structure برقرار رکھیں۔
بنیادی استعمال: Kernels کی توثیق کریں
Patch یا drop-in modules انسٹال کرنے کے بعد، target A100، A800، RTX 3090، RTX A6000 یا کسی دوسرے supported Ampere GPU پر فراہم کردہ isolated microbenchmarks چلائیں:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
Benchmark files sparse MLA اور KV-gather kernels، TileLang mHC kernels، اور Top-K plus SWA combiner کا احاطہ کرتی ہیں۔ ان کا مقصد local kernel latency ناپنا اور optimized outputs کو baseline references کے مقابل verify کرنا ہے۔
Repository کے benchmark charts اس command سے بنائیں:
python3 benchmarks/generate_charts.pyمکمل benchmark dataset بھی benchmarks/results/sm80_benchmark_summary.json میں دستیاب ہے۔
Numerical Validation کو سمجھنا
کئی optimized paths کو bit-exact رپورٹ کیا گیا ہے:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
دیگر Tensor Core paths میں معمولی فرق آ سکتا ہے، کیونکہ BF16 accumulation یا MMA execution order تبدیل ہوتا ہے۔ رپورٹ کردہ maximum differences measured fused mHC configurations کے لیے 1.9e-3 سے کم اور measured sparse-attention prefill configuration کے لیے 4.8e-3 سے کم ہیں۔
Prompt-logprob negative log-likelihood results، run-to-run noise floor کے اندر رہے۔ Deployment کا جائزہ لیتے وقت performance اور numerical output دونوں کا معائنہ کریں، بجائے اس کے کہ یہ فرض کر لیا جائے کہ ہر optimized operator لازماً bit-identical ہوگا۔
Advanced Deployment Tips
Tested Six-GPU Production Layout کے لیے TP2 × PP3 استعمال کریں
چھ 64 GB یا 80 GB Ampere GPUs کے لیے repository TP2 × PP3 کی سفارش کرتی ہے، جس میں 14,14,12 layer partition ہو۔ Tested configuration میں اس arrangement نے selected single-stream code اور long-generation workloads کے لیے 160.8 سے 188.8 tokens per second، 64K cold prefill کے لیے 4,506.8 tokens per second، اور تقریباً 4.65 million GPU-resident KV tokens کی capacity فراہم کی۔
یہ capacity benchmark configuration کے تحت تقریباً 4.43 ایک-million-token contexts کے برابر ہے۔
متبادل configurations کو سمجھیں
- PP6: تقریباً 4.5 سے 4.7 million tokens کی capacity فراہم کرتا ہے، لیکن README کے مطابق single-stream decode خاصا سست ہے، کیونکہ tensor parallelism ایک ہے اور requests چھ pipeline stages سے گزرتی ہیں۔
- Asymmetric TP2 plus TP4: estimated capacity کو تقریباً چھ million tokens تک بڑھاتا ہے، لیکن MoE intermediate size 2,304 کو 576-wide TP4 partitions میں تقسیم کرنے سے Marlin tile efficiency متاثر ہوتی ہے۔
ایک ملین ٹوکن کی تعیناتی کے لیے ٹوپولوجی منتخب کرنے سے پہلے ریپوزٹری میں موجود docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md سے رجوع کریں۔
حقیقی ورک لوڈ کا بینچ مارک لیں
سب سے بڑے فوائد کثرت سے چلائے جانے والے آپریٹرز سے حاصل ہوتے ہیں، لیکن مکمل سسٹم کی بہتری کا انحصار پرامپٹ کی لمبائی، ہم وقتی درخواستوں کی تعداد، speculative decoding، ٹوپولوجی اور GPU ماڈل پر ہوتا ہے۔ پہلے الگ الگ بینچ مارکس چلائیں، پھر انہی پرامپٹس، context سائز اور concurrency کی سطحوں کے ساتھ مکمل serving workloads کا موازنہ کریں جو آپ کی production application میں استعمال ہوتی ہیں۔
براہِ راست آؤٹ پٹ کا تیز راستہ برقرار رکھیں
جب num_kv_splits == 1 ہو تو sparse MLA decode optimization دوسری reduction launch کو چھوڑ دیتی ہے۔ اگر آپ attention scheduling یا split behavior میں ترمیم کریں تو kernel کی دوبارہ پیمائش کریں، کیونکہ direct-output path رپورٹ کردہ decode بہتری کا اہم حصہ ہے۔
YOCO میٹا ڈیٹا کو forward context میں برقرار رکھیں
layer 20 کا metadata cache مفید ہے کیونکہ layer 21–39 کے تمام consumers اس کے KV source کو مشترکہ طور پر استعمال کرتے ہیں۔ model execution یا forward-context handling میں تبدیلیاں اس reuse کو برقرار رکھیں؛ بصورتِ دیگر engine ہر consumer layer کے لیے یکساں ragged metadata دوبارہ بنا سکتا ہے۔
نتیجہ
DeepInfer-SM80، NVIDIA Ampere پر KV-cache VRAM overhead بڑھائے بغیر DeepSeek-V4.1 کو تیز کرنے کے لیے ایک مرکوز راستہ فراہم کرتا ہے۔ اس کی بہتریوں میں Ampere-aware sparse attention، bitshift UE8M0 decoding، direct KV-cache output، race-free Top-K اور SWA combiner، aligned mHC routing، اور YOCO metadata reuse شامل ہیں۔
آغاز unified patch لاگو کرکے یا چھ drop-in modules انسٹال کرکے کریں۔ اپنے ہارڈویئر پر latency اور numerical behavior کی تصدیق کے لیے تینوں microbenchmark suites چلائیں، پھر اپنے حقیقی serving workload کے ساتھ optimized vLLM environment کا جائزہ لیں۔ چھ GPU اور one-million-context deployment کے لیے repository کی آزمودہ TP2 × PP3 configuration کو بنیادی reference point کے طور پر استعمال کریں۔