

NamiGPT کیا ہے
NamiGPT چینی زبان کے ابتدائی سیکھنے والوں کے لیے بڑے ماڈلز کی بنیادی تعلیم کا ایک مجموعہ ہے۔ یہ PyTorch استعمال کرتے ہوئے GPT-2 کو صفر سے نافذ کرتا ہے، تیار شدہ Transformer ماڈیولز استعمال نہیں کرتا، اور OpenAI کے سرکاری پیش تربیت یافتہ وزن لوڈ کر کے inference اور متن تیار کر سکتا ہے۔
پروجیکٹ کی اولین ترجیح تربیت کی کارکردگی نہیں بلکہ سمجھ بوجھ ہے: بنیادی ماڈل gpt2/model.py میں موجود ہے اور کوڈ 200 سطروں سے بھی کم ہے؛ سبق “بلی مچھلی کھاتی ہے” کی تین الفاظ والی مثال کو مرکزی دھاگے کے طور پر استعمال کرتا ہے اور tokenization، vectors، attention matrices اور حتمی generation کے عمل کو مرحلہ وار کھولتا ہے۔
NamiGPT کا نام Karpathy کے nanoGPT کو خراج تحسین پیش کرتا ہے۔ یہ چینی زبان کے صفر سے شروع کرنے والے طلبہ کی تعلیم پر زیادہ توجہ دیتا ہے اور کم سے کم مثالوں کے ذریعے GPT-2 کے ہر مرحلے کی وضاحت کرتا ہے۔
آپ کیا سیکھیں گے
- Tokenizer متن کو token ID میں کیسے تبدیل کرتا ہے۔
- Embedding اور positional encoding ماڈل کا input کیسے بناتے ہیں۔
- Self-Attention اور Multi-Head Attention کا حساب کیسے کیا جاتا ہے۔
- Residual connection، LayerNorm، FFN اور activation function کا الگ الگ کردار کیا ہے۔
- متعدد Transformer Block مل کر GPT-2 کیسے بناتے ہیں۔
- OpenAI کے سرکاری وزن کو ہاتھ سے بنائے گئے ماڈل میں کیسے لوڈ کیا جاتا ہے۔
- Greedy، temperature اور top-k حکمت عملیوں سے متن کیسے تیار کیا جاتا ہے۔
- ٹیسٹ کے ذریعے ہاتھ سے بنائے گئے implementation اور HuggingFace implementation کے یکساں ہونے کی تصدیق کیسے کی جاتی ہے۔
پروجیکٹ کی اہم خصوصیات
بنیادی اجزا کو صفر سے نافذ کرنا
NamiGPT تیار شدہ Transformer ماڈیولز کو براہ راست استعمال نہیں کرتا۔ ماڈل میں LayerNorm، Attention، FFN، Block اور GPT جیسے اجزا شامل ہیں، اس لیے یہ دیکھنے کے لیے موزوں ہے کہ data اور tensors کوڈ کی ہر سطر میں کیسے بہتے ہیں۔
باب کے اسکرپٹ الگ الگ چل سکتے ہیں
Inference کا حصہ 15 بتدریج آگے بڑھنے والے موضوعات پر مشتمل ہے، جن میں tokenizer، Embedding، positional encoding، self-attention، multi-head attention، residual connection، layer normalization، feed-forward network، activation function، Transformer Block، stacking، weight loading، text generation اور interpretability شامل ہیں۔ ہر تعلیمی موضوع کے ساتھ ایک متعلقہ قابلِ اجرا اسکرپٹ موجود ہے۔
تعامل پر مبنی visualization فراہم کرتا ہے
پروجیکٹ Transformer architecture کی متحرک visualization اور مکمل inference matrix visualization فراہم کرتا ہے۔ جب کوڈ یا فارمولے سمجھنا مشکل ہوں تو “بلی مچھلی کھاتی ہے” کی مثال میں matrix کے عناصر کو ایک ایک خانے کے حساب سے بنتے ہوئے دیکھا جا سکتا ہے۔
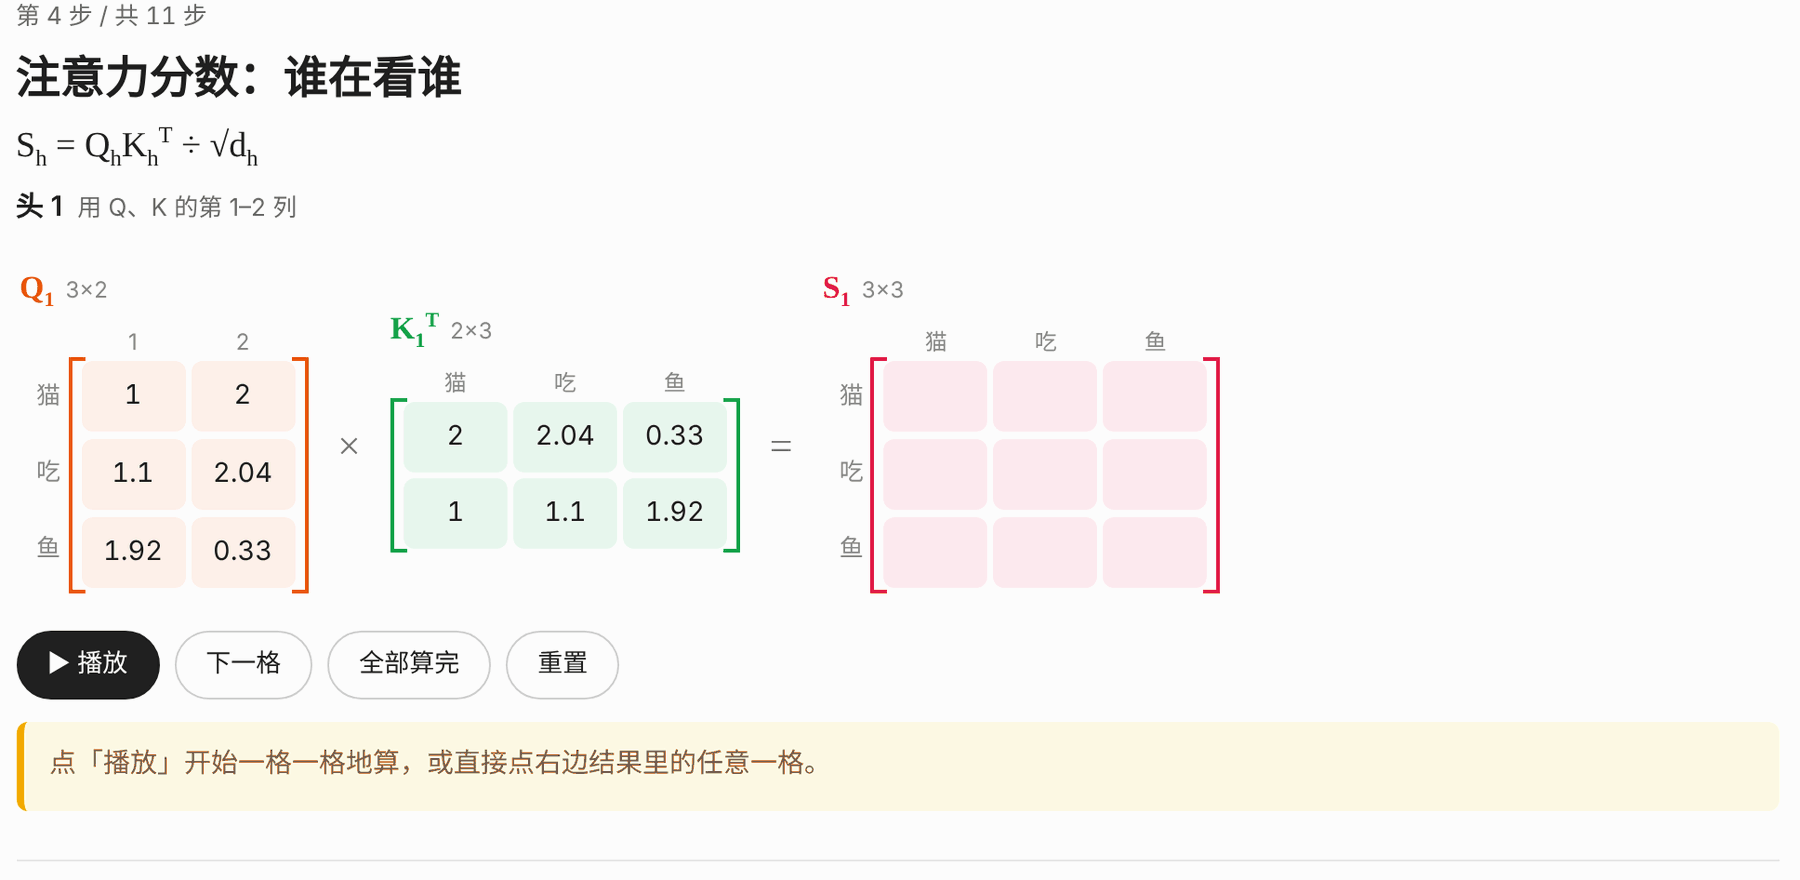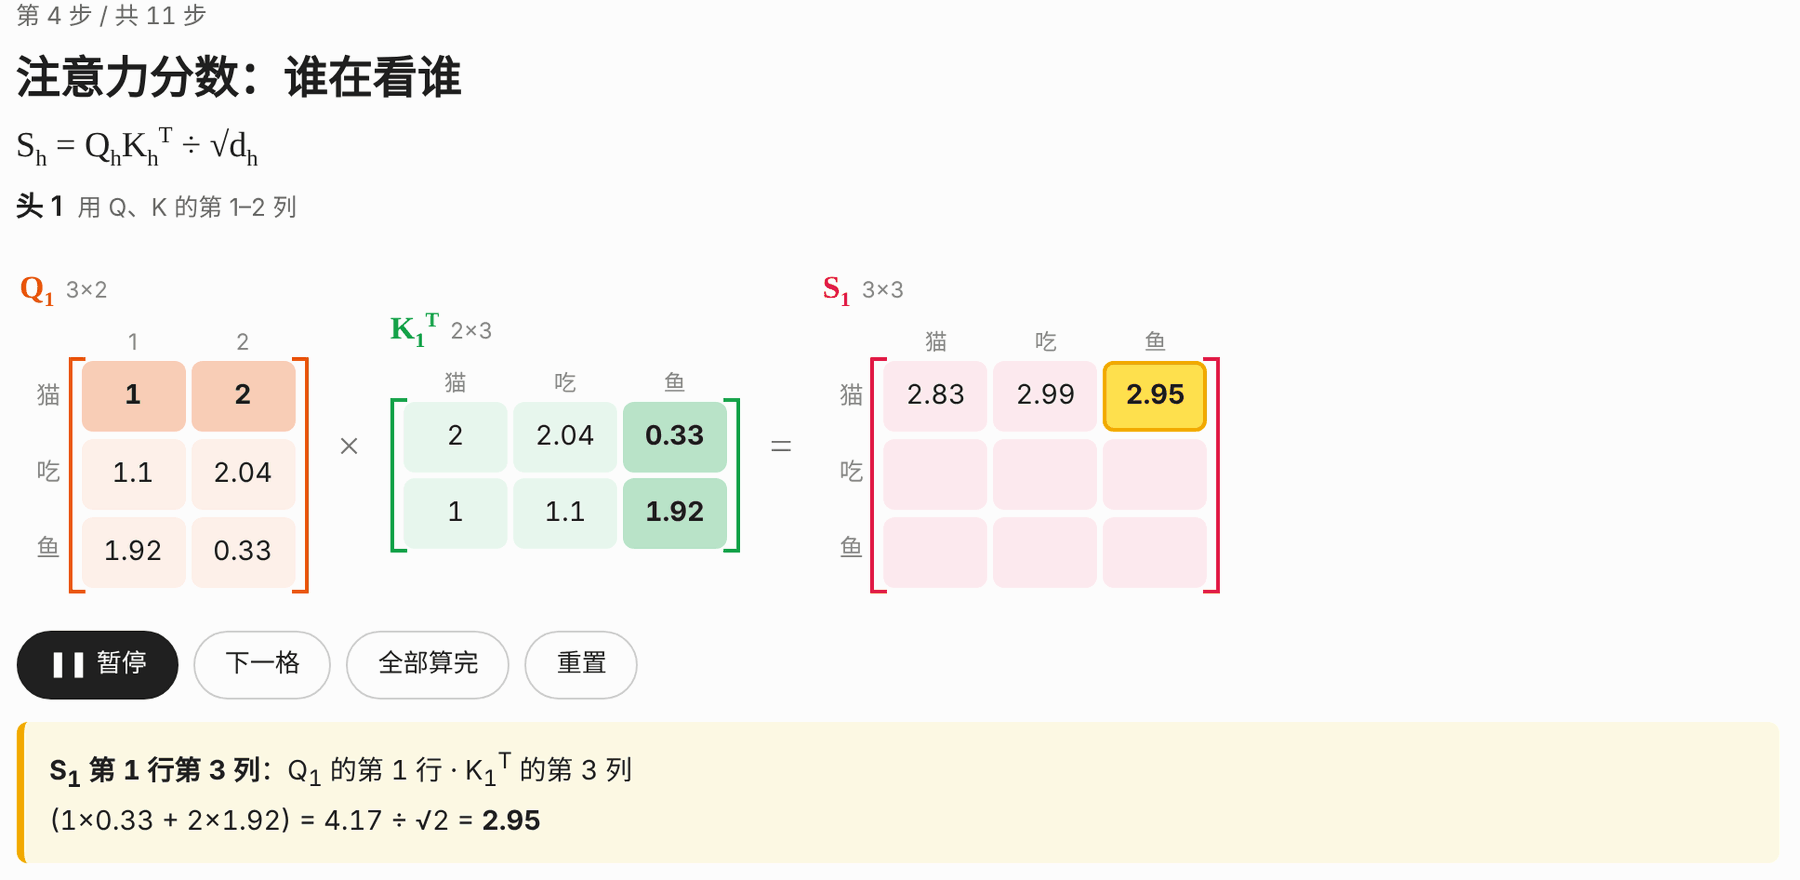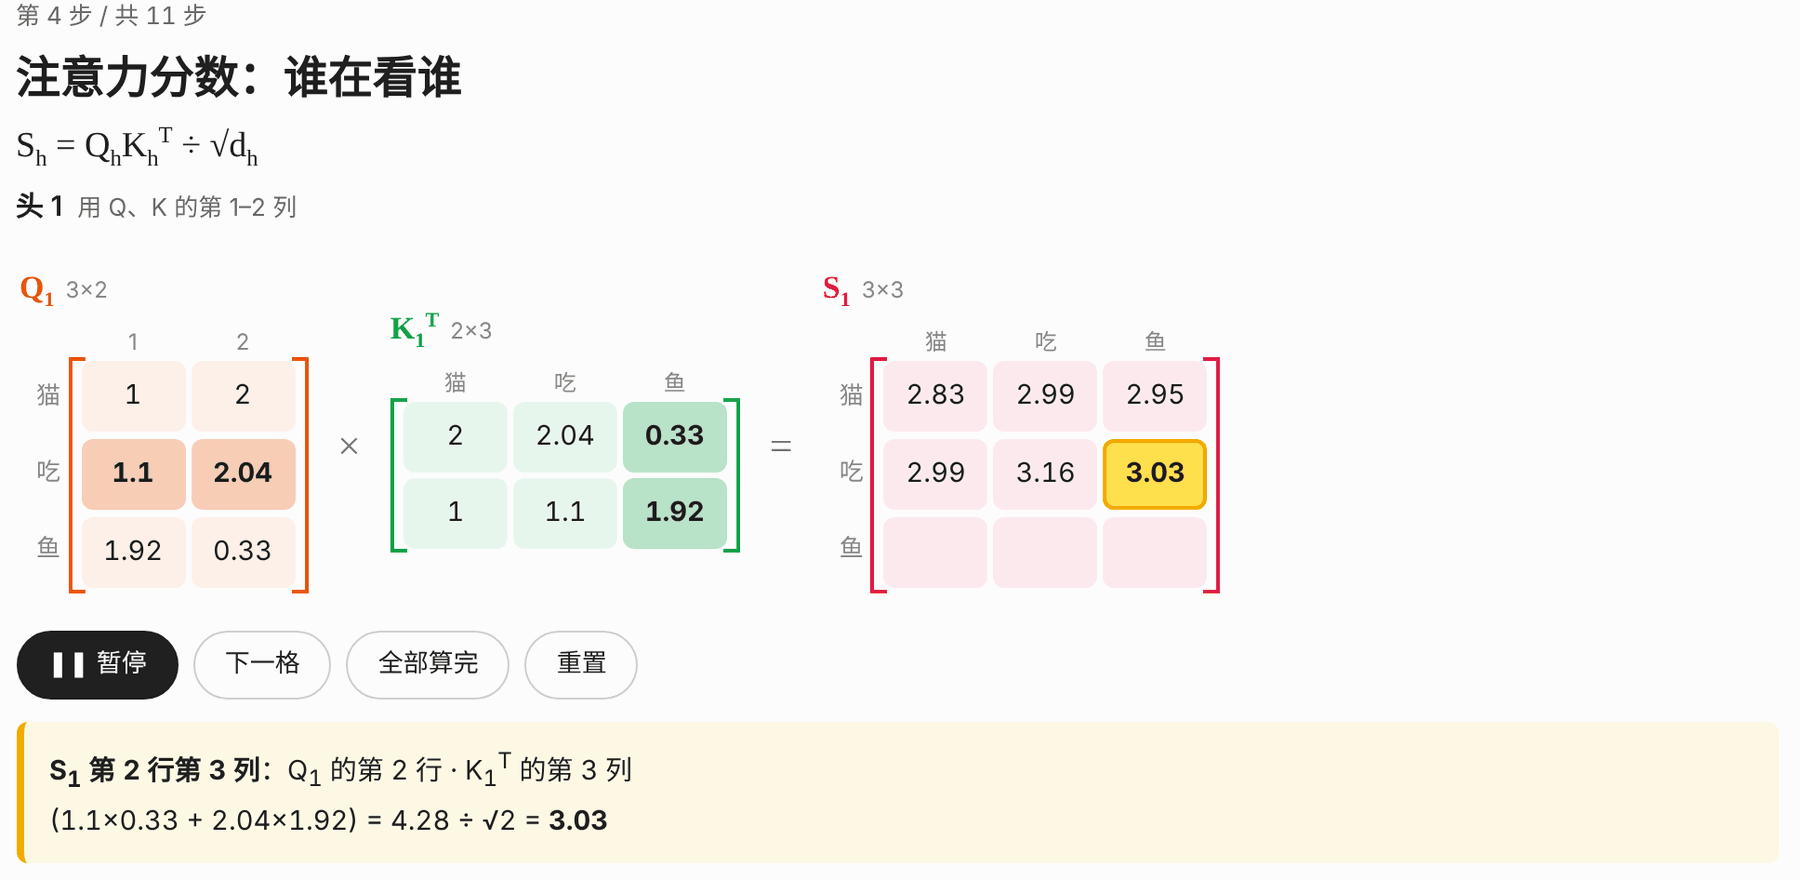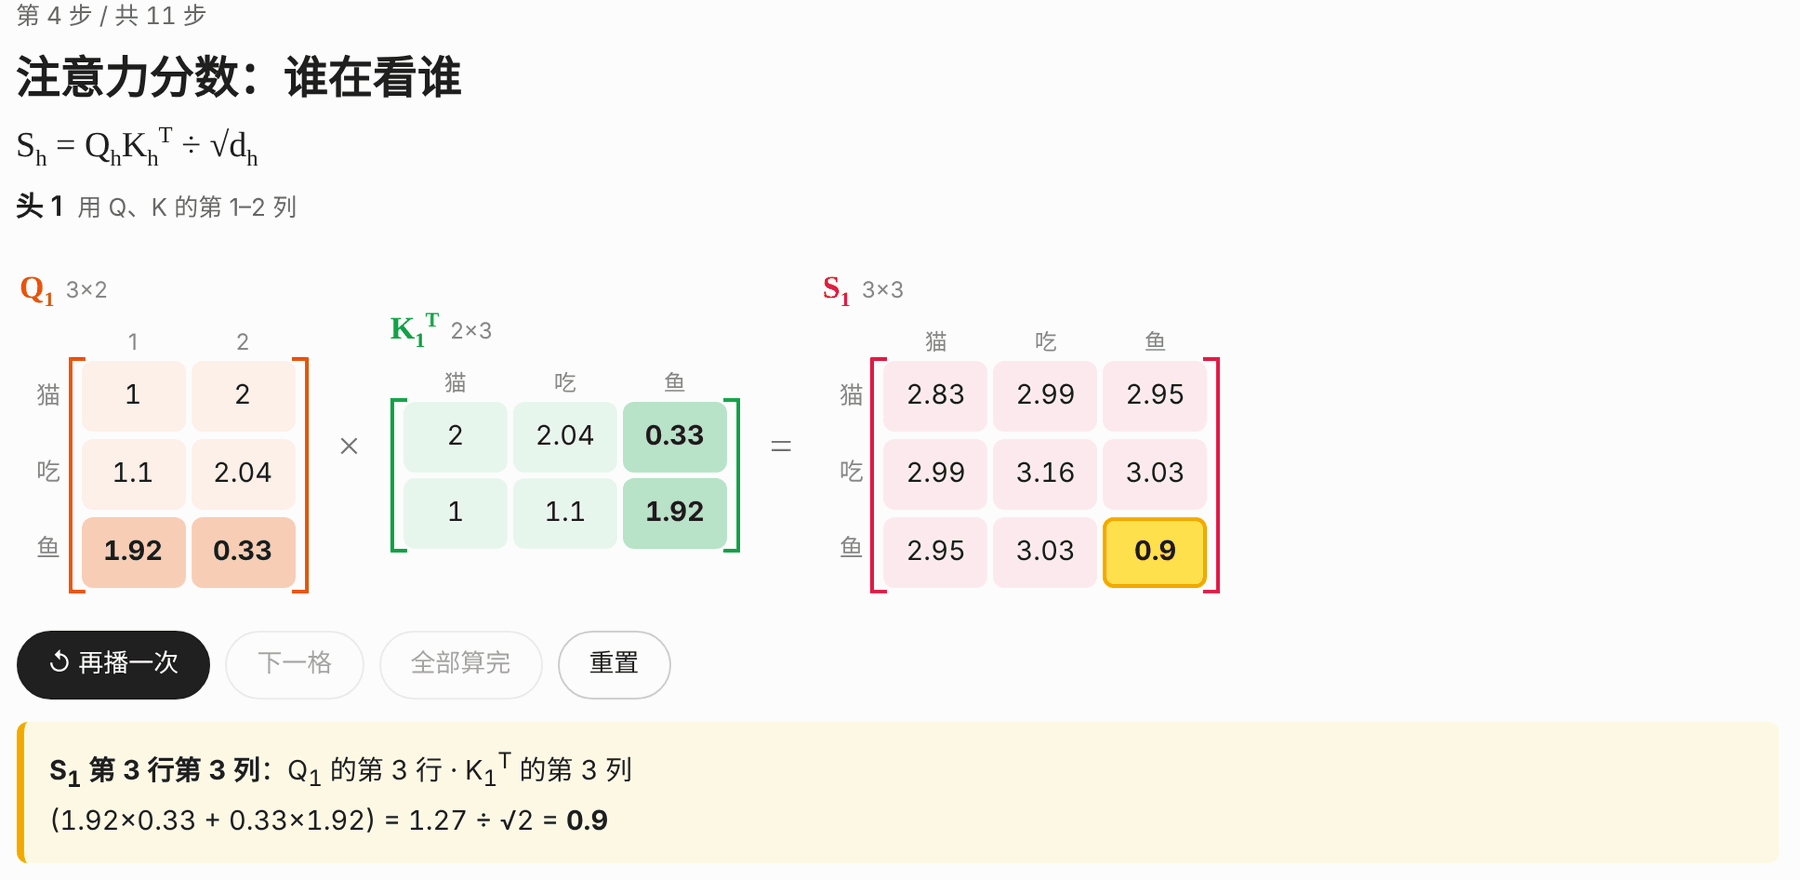
پہلے ایک تصویر میں Transformer کو سمجھیں دیکھنے کی تجویز ہے، پھر باب کے کوڈ کے ساتھ بڑے ماڈل کی inference visualization استعمال کریں۔
HuggingFace کے نتائج کے ساتھ ہم آہنگی
repository میں shape checks اور HuggingFace کے سرکاری implementation کے ساتھ alignment tests شامل ہیں۔ بے ترتیب وزن استعمال کر کے تیز موازنے کے علاوہ، اضافی تصدیق کے لیے حقیقی GPT-2 وزن بھی ڈاؤن لوڈ کیے جا سکتے ہیں۔
تنصیب سے پہلے تیاری
شروع کرنے سے پہلے Python کوڈ پڑھنے کی بنیادی صلاحیت اور matrix multiplication جیسے بنیادی linear algebra کے تصورات کی سمجھ ضروری ہے۔ پروجیکٹ کے لیے Python 3.9 یا اس سے نیا ورژن اور PyTorch 2.x تجویز کیا گیا ہے۔
پہلے repository کلون کریں، پروجیکٹ ڈائریکٹری میں جائیں اور dependencies انسٹال کریں:
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
اگر HuggingFace سے سرکاری وزن ڈاؤن لوڈ کرتے وقت نیٹ ورک محدود ہو تو موجودہ terminal میں mirror address سیٹ کیا جا سکتا ہے:
export HF_ENDPOINT=https://hf-mirror.comیہ mirror صرف سرکاری وزن ڈاؤن لوڈ کرنے کے لیے استعمال ہوتا ہے۔ بعد میں from_pretrained کال کرتے وقت ماڈل کا ڈھانچہ اب بھی NamiGPT کے ہاتھ سے بنائے گئے implementation سے آتا ہے۔
پہلا مرحلہ: ابواب کے ذریعے GPT-2 کو سمجھیں
ابتدائی سیکھنے والوں کے لیے سب سے موزوں طریقہ یہ ہے کہ مکمل ماڈل فوراً پڑھنے کے بجائے inference data flow کے مطابق ہر باب کا مطالعہ کیا جائے:
- Input مرحلہ: پہلے Tokenizer، Embedding اور positional encoding سمجھیں۔
- Attention مرحلہ: Self-Attention سمجھنے کے بعد Multi-Head Attention تک جائیں۔
- Module مرحلہ: residual connection، LayerNorm، FFN اور activation function سیکھیں۔
- Model مرحلہ: اجزا کو Transformer Block میں جوڑیں اور اسے stack کر کے مکمل GPT-2 بنائیں۔
- Application مرحلہ: سرکاری وزن لوڈ کریں، متن تیار کریں اور interpretability کے نتائج دیکھیں۔
ہر اسکرپٹ الگ چلایا جا سکتا ہے۔ مثال کے طور پر multi-head attention کا باب چلانے کے لیے:
python chapters/01-inference/ep06_multi_head_attention.pyمکمل تصویری اور تحریری مواد NamiGPT تصویری و تحریری سبق میں دستیاب ہے، جبکہ repository میں اصل مسودہ docs/01-inference/ میں موجود ہے۔
دوسرا مرحلہ: GPT-2 لوڈ کر کے متن تیار کریں
تنصیب مکمل ہونے کے بعد NamiGPT کے فراہم کردہ model loading اور generation interfaces براہ راست import کیے جا سکتے ہیں۔ ذیل کی مثال GPT-2 tokenizer استعمال کرتی ہے، انگریزی prompt کو token ID میں encode کرتی ہے، پھر ہاتھ سے بنائے گئے ماڈل اور سرکاری 124M وزن لوڈ کرتی ہے:
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
کوڈ کے اجرا کا عمل
tiktoken.get_encoding("gpt2")GPT-2 کا استعمال کردہ encoder حاصل کرتا ہے۔enc.encode(...)prompt متن کو token ID میں تبدیل کرتا ہے۔torch.tensorID کو ماڈل کے مطلوبہ batch tensor میں ڈھالتا ہے۔from_pretrained("gpt2")ہاتھ سے بنایا ہوا GPT-2 تخلیق کرتا ہے اور سرکاری 124M وزن لوڈ کرتا ہے۔generateprompt متن کے بعد زیادہ سے زیادہ 30 نئے token تیار کرتا ہے۔enc.decodeoutput token ID کو دوبارہ متن میں تبدیل کرتا ہے۔
نوٹ: GPT-2 کو conversational fine-tuning نہیں دی گئی؛ یہ موجودہ مواد کو آگے بڑھانے میں ماہر ہے، سوالات کے جواب دینے میں نہیں جیسے chat model کرتا ہے۔ اس کے training corpus میں انگریزی غالب ہے، اس لیے ابتدا میں انگریزی prompts استعمال کرنے کی تجویز ہے۔
تیسرا مرحلہ: generation parameters کو سمجھیں
مثال میں sampling کے دو اہم parameters استعمال کیے گئے ہیں:
temperature=0.8: امیدوار token کی probability distribution کو ایڈجسٹ کرنے کے لیے استعمال ہوتا ہے۔ پروجیکٹ کا generation module temperature strategy کو support کرتا ہے۔top_k=50: صرف زیادہ probability والے ابتدائی 50 امیدوار token میں سے انتخاب کرتا ہے۔ پروجیکٹ greedy generation اور top-k generation دونوں کو support کرتا ہے۔
سیکھنے کے دوران prompt متن کو برقرار رکھتے ہوئے صرف temperature یا top-k تبدیل کریں، پھر continuation کے نتائج کا موازنہ کریں۔ اس طرح دیکھا جا سکتا ہے کہ generation strategy output پر کیسے اثر انداز ہوتی ہے، تاہم مخصوص parameters کا انتخاب تجربے کے مقصد کے مطابق ہونا چاہیے۔
چوتھا مرحلہ: Gradio ویب demo شروع کریں
اگر browser میں prompt درج کر کے continuation کا نتیجہ اور ہر مرحلے پر امیدوار الفاظ کی probability دیکھنی ہو تو Gradio انسٹال کر کے repository کا demo پروگرام شروع کریں:
pip install gradio
python demo/app.py
ویب demo ماڈل کی ہر مرحلے کی prediction دیکھنے کے لیے موزوں ہے، جبکہ باب کے اسکرپٹ کسی ایک component کے حسابی عمل کا مطالعہ کرنے کے لیے زیادہ مناسب ہیں۔ دونوں کو ملا کر استعمال کرنے سے حتمی متن کو اندرونی probability کی تبدیلیوں سے مربوط کیا جا سکتا ہے۔
پانچواں مرحلہ: tests چلائیں
Attention، weight loading یا generation logic میں ترمیم کے بعد tests چلانے کی تجویز ہے۔ Default tests بے ترتیب وزن استعمال کرتے ہیں، اس لیے pretrained model ڈاؤن لوڈ کرنے کی ضرورت نہیں ہوتی اور عموماً جلد مکمل ہو جاتے ہیں:
pytest tests/ -vاگر حقیقی GPT-2 وزن کے ساتھ اضافی alignment بھی کرنا ہو تو یہ چلائیں:
TEST_PRETRAINED=1 pytest tests/ -vدوسری کمانڈ حقیقی وزن بھی ڈاؤن لوڈ کرے گی، اس لیے پہلی بار چلانے پر ڈاؤن لوڈ مکمل ہونے کا انتظار کرنا ہوگا۔
Repository structure کا مختصر جائزہ
gpt2/config.py: ماڈل configuration، جس میں 124M، 355M، 774M اور 1.5B specifications شامل ہیں۔gpt2/model.py: LayerNorm، Attention، FFN، Block اور GPT model کا بنیادی ڈھانچہ۔gpt2/load_weights.py: سرکاری وزن کو ہاتھ سے بنائے گئے ماڈل میں لوڈ کرتا ہے۔gpt2/generate.py: greedy، temperature اور top-k generation logic۔chapters/01-inference/: ہر سبق کے مطابق demonstration scripts۔docs/01-inference/: سبق کے مضامین کے اصل مسودے۔demo/app.py: Gradio ویب demo۔tests/: shape checks اور HuggingFace alignment tests۔
اعلیٰ تکنیک: HuggingFace alignment کی تین اہم تفصیلات
1. Causal mask درست طور پر نافذ کریں
GPT-2 ایک autoregressive language model ہے۔ sequence میں ہر لفظ صرف خود کو اور اس سے پہلے کے الفاظ کو پڑھ سکتا ہے، بعد کے token کو پہلے سے نہیں دیکھ سکتا۔ اگر causal mask رہ جائے تو سرکاری وزن کامیابی سے لوڈ ہونے کے باوجود model output غلط ہوگا۔
2. وزن منتقل کرتے وقت transpose سنبھالیں
GPT-2 کا اصل implementation Conv1D استعمال کرتا ہے، جس کا weight shape [in, out] ہے؛ PyTorch کا nn.Linear [out, in] استعمال کرتا ہے۔ اس لیے سرکاری parameters کو ہاتھ سے بنائے گئے linear layer میں لوڈ کرتے وقت transpose کرنا ضروری ہے۔
اس کے علاوہ، c_attn Query، Key اور Value کے parameters کو ایک ساتھ جوڑتا ہے۔ ہاتھ سے بنائے گئے implementation کے ساتھ alignment کرتے وقت پہلے انہیں متعلقہ تین حصوں میں تقسیم کریں، پھر درست جگہ پر رکھیں۔
3. tanh approximation والا GELU استعمال کریں
GPT-2، GELU کا tanh approximation والا ورژن استعمال کرتا ہے، جبکہ PyTorch کا nn.GELU() default طور پر exact ورژن استعمال کرتا ہے۔ اگر ہر عنصر کی alignment کرنی ہو تو یہ سیٹ کریں:
nn.GELU(approximate="tanh")یہ تین تفصیلات بظاہر معمولی ہیں، مگر براہ راست اس بات پر اثر ڈالتی ہیں کہ ہاتھ سے بنایا گیا model سرکاری implementation کے نتائج دہرا سکتا ہے یا نہیں۔ غلطی تلاش کرتے وقت mask، parameter shapes اور activation function version کو بالترتیب چیک کیا جا سکتا ہے۔
تجویز کردہ learning اور debugging طریقہ
- سب سے پہلے architecture کی متحرک visualization کے ذریعے سمجھیں کہ GPT-2 صرف Transformer decoder کا حصہ استعمال کرتا ہے۔
- موجودہ باب کا اسکرپٹ چلائیں اور input، output اور intermediate tensors کے shapes نوٹ کریں۔
- جب attention matrix سمجھنا مشکل ہو تو آن لائن matrix visualization کے ساتھ ایک ایک خانے کا موازنہ کریں۔
- کسی component کو مکمل کرنے کے بعد
gpt2/model.pyمیں اس کا متعلقہ implementation پڑھیں۔ - implementation میں ترمیم کے بعد پہلے random-weight tests چلائیں، پھر ضرورت کے مطابق real-weight tests چلائیں۔
- آخر میں text generation example اور Gradio page سے مکمل model behavior دیکھیں۔
یہ ترتیب architecture diagram، matrix calculation، chapter code، complete model اور final output کو آپس میں جوڑ دیتی ہے، اور شروع ہی میں مکمل GPT-2 کے کثیر سطحی ڈھانچے میں الجھنے سے بچاتی ہے۔
خلاصہ
NamiGPT بنیادی میٹرکس حساب سے مکمل GPT-2 انفیرنس تک سیکھنے کا ایک راستہ فراہم کرتا ہے۔ آپ پہلے ہر جزو کو سمجھنے کے لیے الگ الگ باب کی اسکرپٹس چلا سکتے ہیں، پھر OpenAI کے سرکاری وزن لوڈ کرکے انگریزی متن کو آگے بڑھا سکتے ہیں، اور آخر میں بصری جائزے اور HuggingFace کے مطابقتی ٹیسٹ کے ذریعے اپنی سمجھ اور تبدیلیوں کی تصدیق کر سکتے ہیں۔
پروجیکٹ کا کوڈ MIT لائسنس کے تحت ہے؛ docs/ ڈائریکٹری کے مضامین CC BY-NC 4.0 لائسنس کے تحت ہیں۔ دوبارہ اشاعت کے لیے ماخذ کا حوالہ دینا ضروری ہے اور تجارتی استعمال ممنوع ہے۔